
Explainable AI (XAI): Wie KI-Entscheidungen nachvollziehbar werden
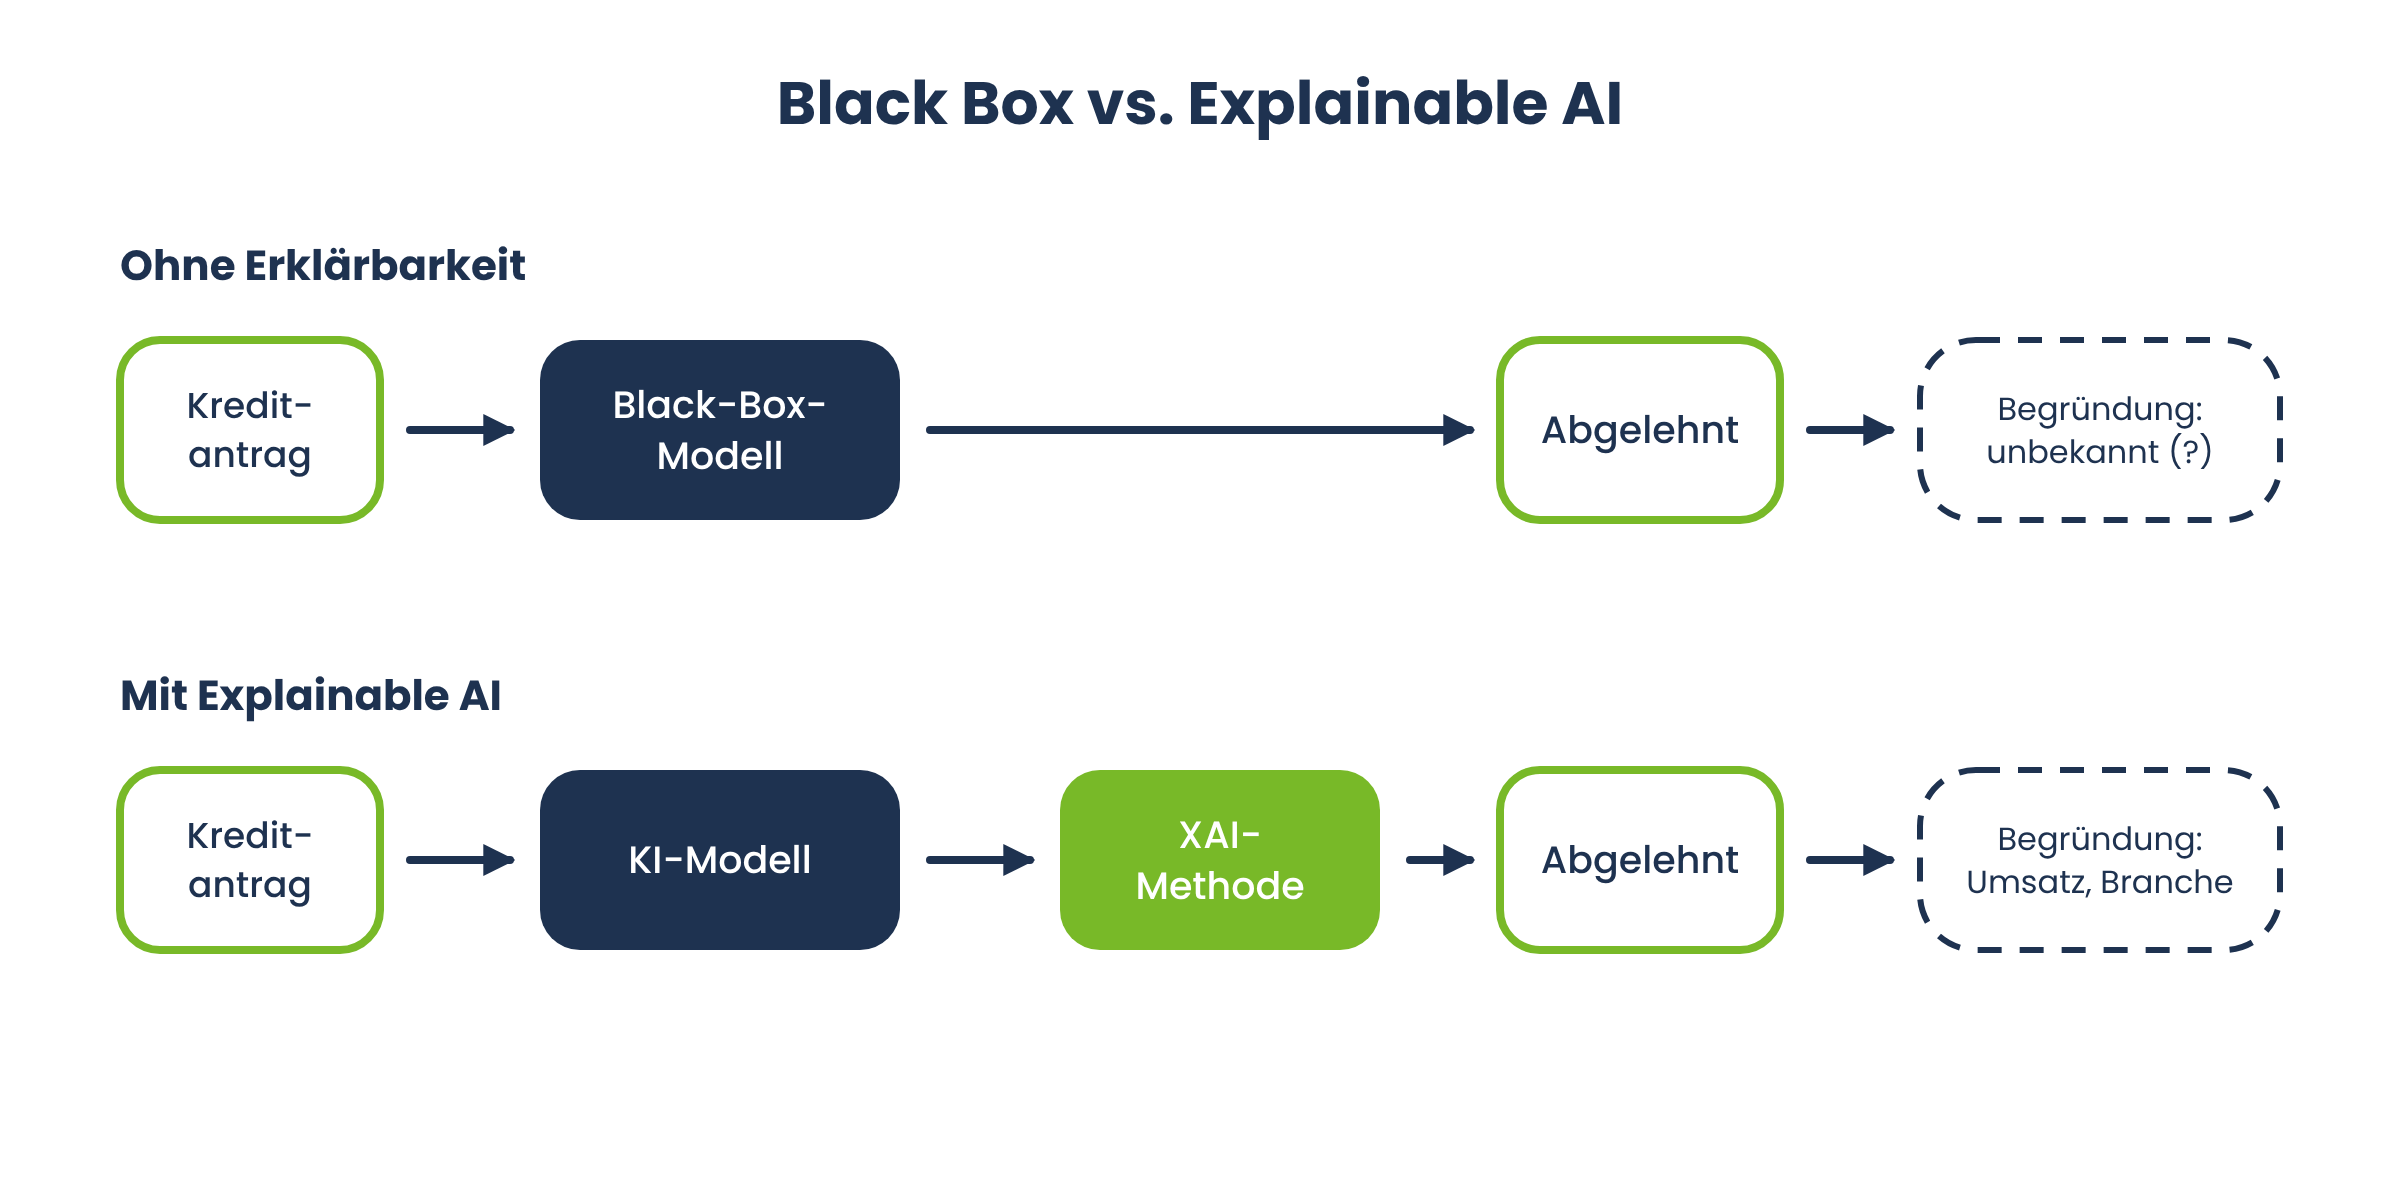
Ein Unternehmen beantragt einen Kredit. Die Bank nutzt ein KI-Modell, um Anträge automatisiert zu bewerten. Innerhalb von Sekunden kommt die Antwort: abgelehnt. Doch warum? Weder der Sachbearbeiter noch der Antragsteller können nachvollziehen, welche Faktoren zu dieser Entscheidung geführt haben. War es die Umsatzentwicklung, die Branche, ein einzelner Ausreißer in den Buchhaltungsdaten? Ohne Antwort bleibt nur Frustration – und im schlimmsten Fall der Verdacht auf eine unfaire Behandlung.
Dieses Szenario zeigt, warum Explainable AI (XAI), zu Deutsch erklärbare künstliche Intelligenz, für Unternehmen heute unverzichtbar ist. Je mehr Entscheidungen an KI-Systeme delegiert werden, desto wichtiger wird die Frage, wie diese Systeme zu ihren Ergebnissen kommen. Das gilt für Kreditvergaben genauso wie für medizinische Diagnosen, Bewerbungsverfahren oder die automatisierte Prüfung von Versicherungsschäden. Explainable AI liefert die Werkzeuge, um genau diese Black-Box zu öffnen.
In diesem Artikel erfährst du, was Explainable AI konkret bedeutet, welche Methoden dahinterstehen und warum XAI längst nicht mehr nur ein technisches Detail, sondern eine regulatorische und wirtschaftliche Notwendigkeit ist.
Was ist Explainable AI (XAI)? Eine Definition:
Explainable AI, kurz XAI, bezeichnet eine Sammlung von Methoden und Prozessen, mit denen sich die Entscheidungen und Vorhersagen von KI-Modellen für Menschen nachvollziehbar machen lassen. Der Begriff umfasst sowohl technische Verfahren, die einzelne Vorhersagen erklären, als auch übergeordnete Konzepte wie Modelltransparenz und Dokumentation.
Um XAI zu verstehen, hilft ein Blick auf das zugrunde liegende Problem: Moderne künstliche Intelligenz basiert häufig auf maschinellem Lernen (ML), insbesondere auf tiefen künstlichen neuronalen Netzen (Deep-Learning). Diese Modelle lernen aus großen Datenmengen, indem sie darin Muster und Korrelationen erkennen und daraus Vorhersagen ableiten. Das Resultat ist oft eine beeindruckend hohe Vorhersagegenauigkeit, aber auch ein Modell, dessen interne Logik selbst für die Entwicklerinnen und Entwickler kaum noch nachvollziehbar ist. Man spricht dann von einem Black-Box-Modell.
Explainable AI setzt genau hier an. Sie liefert Antworten auf Fragen wie: Welche Merkmale eines Datensatzes waren für eine bestimmte Vorhersage entscheidend? Wie hätte sich das Ergebnis verändert, wenn eine Eingabe anders ausgefallen wäre? Und lässt sich das Verhalten des Modells insgesamt in verständlichen Regeln zusammenfassen? Wichtig ist dabei: XAI ersetzt nicht die Leistungsfähigkeit eines Modells, sondern ergänzt sie um eine zweite, ebenso wichtige Dimension – das Verständnis.
Praxisbeispiele: Wo wird Explainable AI heute eingesetzt?
Die theoretischen Konzepte von Explainable AI entfalten ihren Wert erst im konkreten Anwendungskontext. Drei Bereiche zeigen besonders deutlich, wie unterschiedlich die Anforderungen an Erklärbarkeit je nach Branche ausfallen können.
Beispiel #1: Finanzwesen und Kreditvergabe
Im Finanzsektor gehört Explainable AI längst zum Standardrepertoire. Banken setzen KI-Modelle ein, um Kreditwürdigkeit, Betrugsrisiken oder Anlageempfehlungen zu bewerten. Da diese Entscheidungen unmittelbare finanzielle Konsequenzen für Kundinnen und Kunden haben und regulatorisch besonders streng überwacht werden, sind nachvollziehbare Begründungen praktisch unverzichtbar. SHAP-Werte helfen hier dabei, jede einzelne Kreditentscheidung nachträglich in verständliche Einzelfaktoren aufzuschlüsseln – eine Voraussetzung sowohl für interne Revisionsprozesse als auch für die Kommunikation mit Aufsichtsbehörden.
Beispiel #2: Medizin und Diagnostik
In der Medizin steht bei jeder KI-gestützten Diagnose die Patientensicherheit im Mittelpunkt. Ein Modell, das aus einem Röntgenbild oder einer Gewebeprobe eine Diagnose ableitet, muss Ärztinnen und Ärzten zeigen können, worauf diese Einschätzung beruht. Methoden wie Layerwise Relevance Propagation kommen hier besonders häufig zum Einsatz, weil sie sich als anschauliche Heatmaps direkt über medizinische Bilddaten legen lassen. So kann das medizinische Fachpersonal die KI-Empfehlung mit dem eigenen Fachwissen abgleichen, statt sie blind zu übernehmen oder pauschal zu ignorieren.
Beispiel #3: Betrugserkennung und Bildforensik mit fraudify
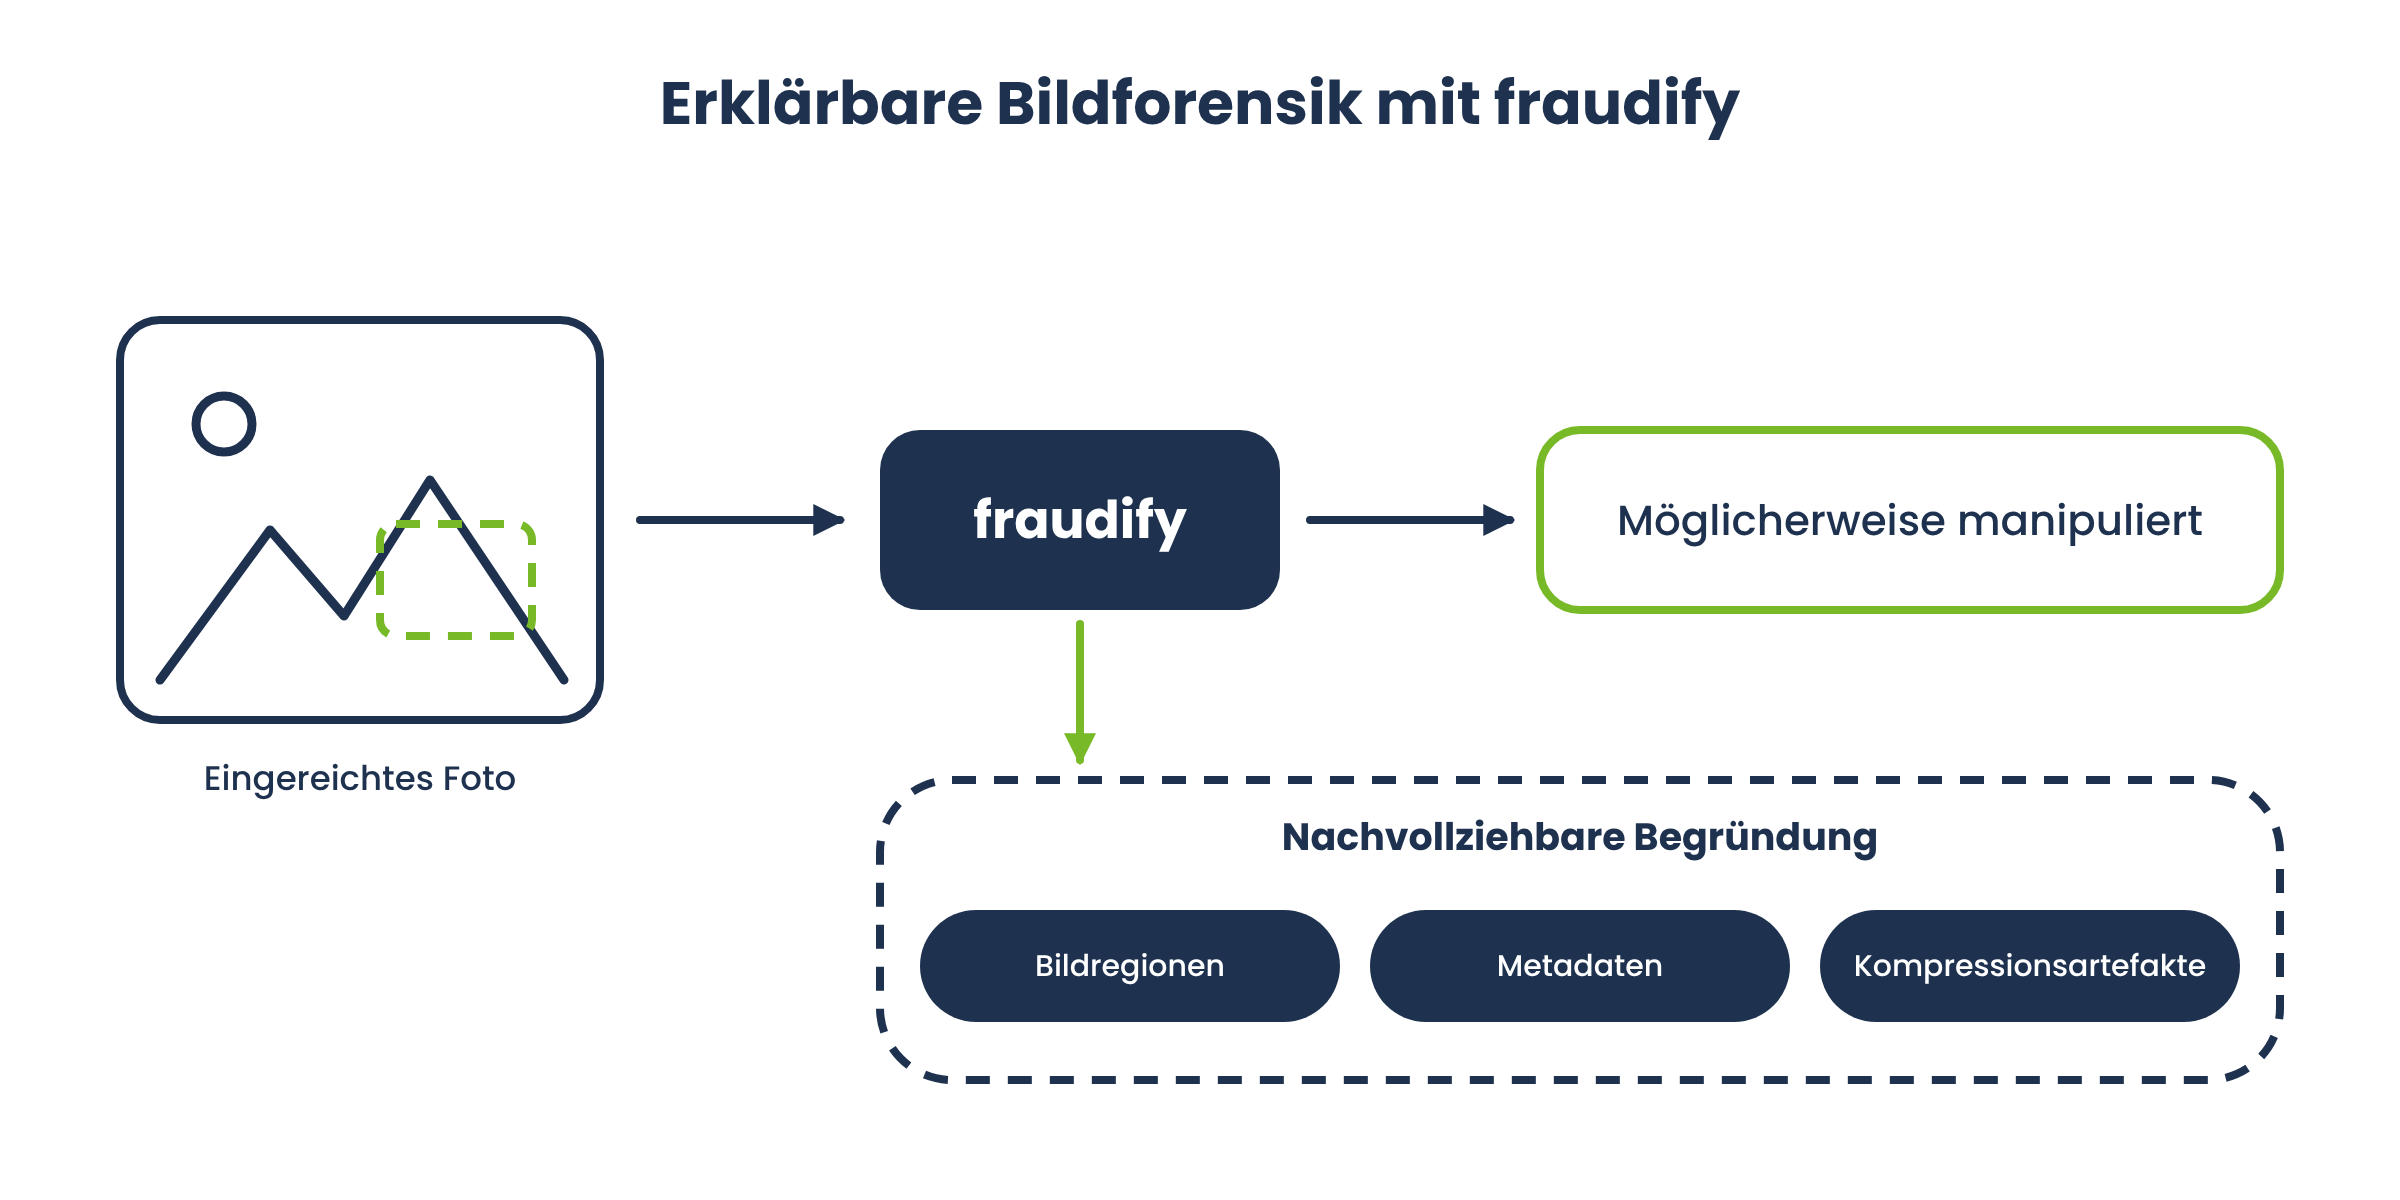
Auch bei der automatisierten Prüfung von Bild- und Dokumentenmaterial mit unserer Bildforensik-Software fraudify gewinnt Erklärbarkeit an Bedeutung. Wird ein eingereichtes Foto von fraudify als möglicherweise manipuliert eingestuft, reicht eine reine Ja-Nein-Aussage in der Praxis selten aus. Sachbearbeitende benötigen eine nachvollziehbare Begründung, etwa welche Bildregionen, Metadaten oder Kompressionsartefakte zu dieser Einschätzung geführt haben, um die Entscheidung fachlich einordnen und gegenüber Kundinnen und Kunden vertreten zu können. Erklärbarkeit wird hier zum entscheidenden Faktor dafür, dass KI-gestützte Bildforensik in der täglichen Praxis überhaupt akzeptiert und produktiv genutzt wird.
Warum ist Erklärbarkeit bei KI-Systemen so wichtig?
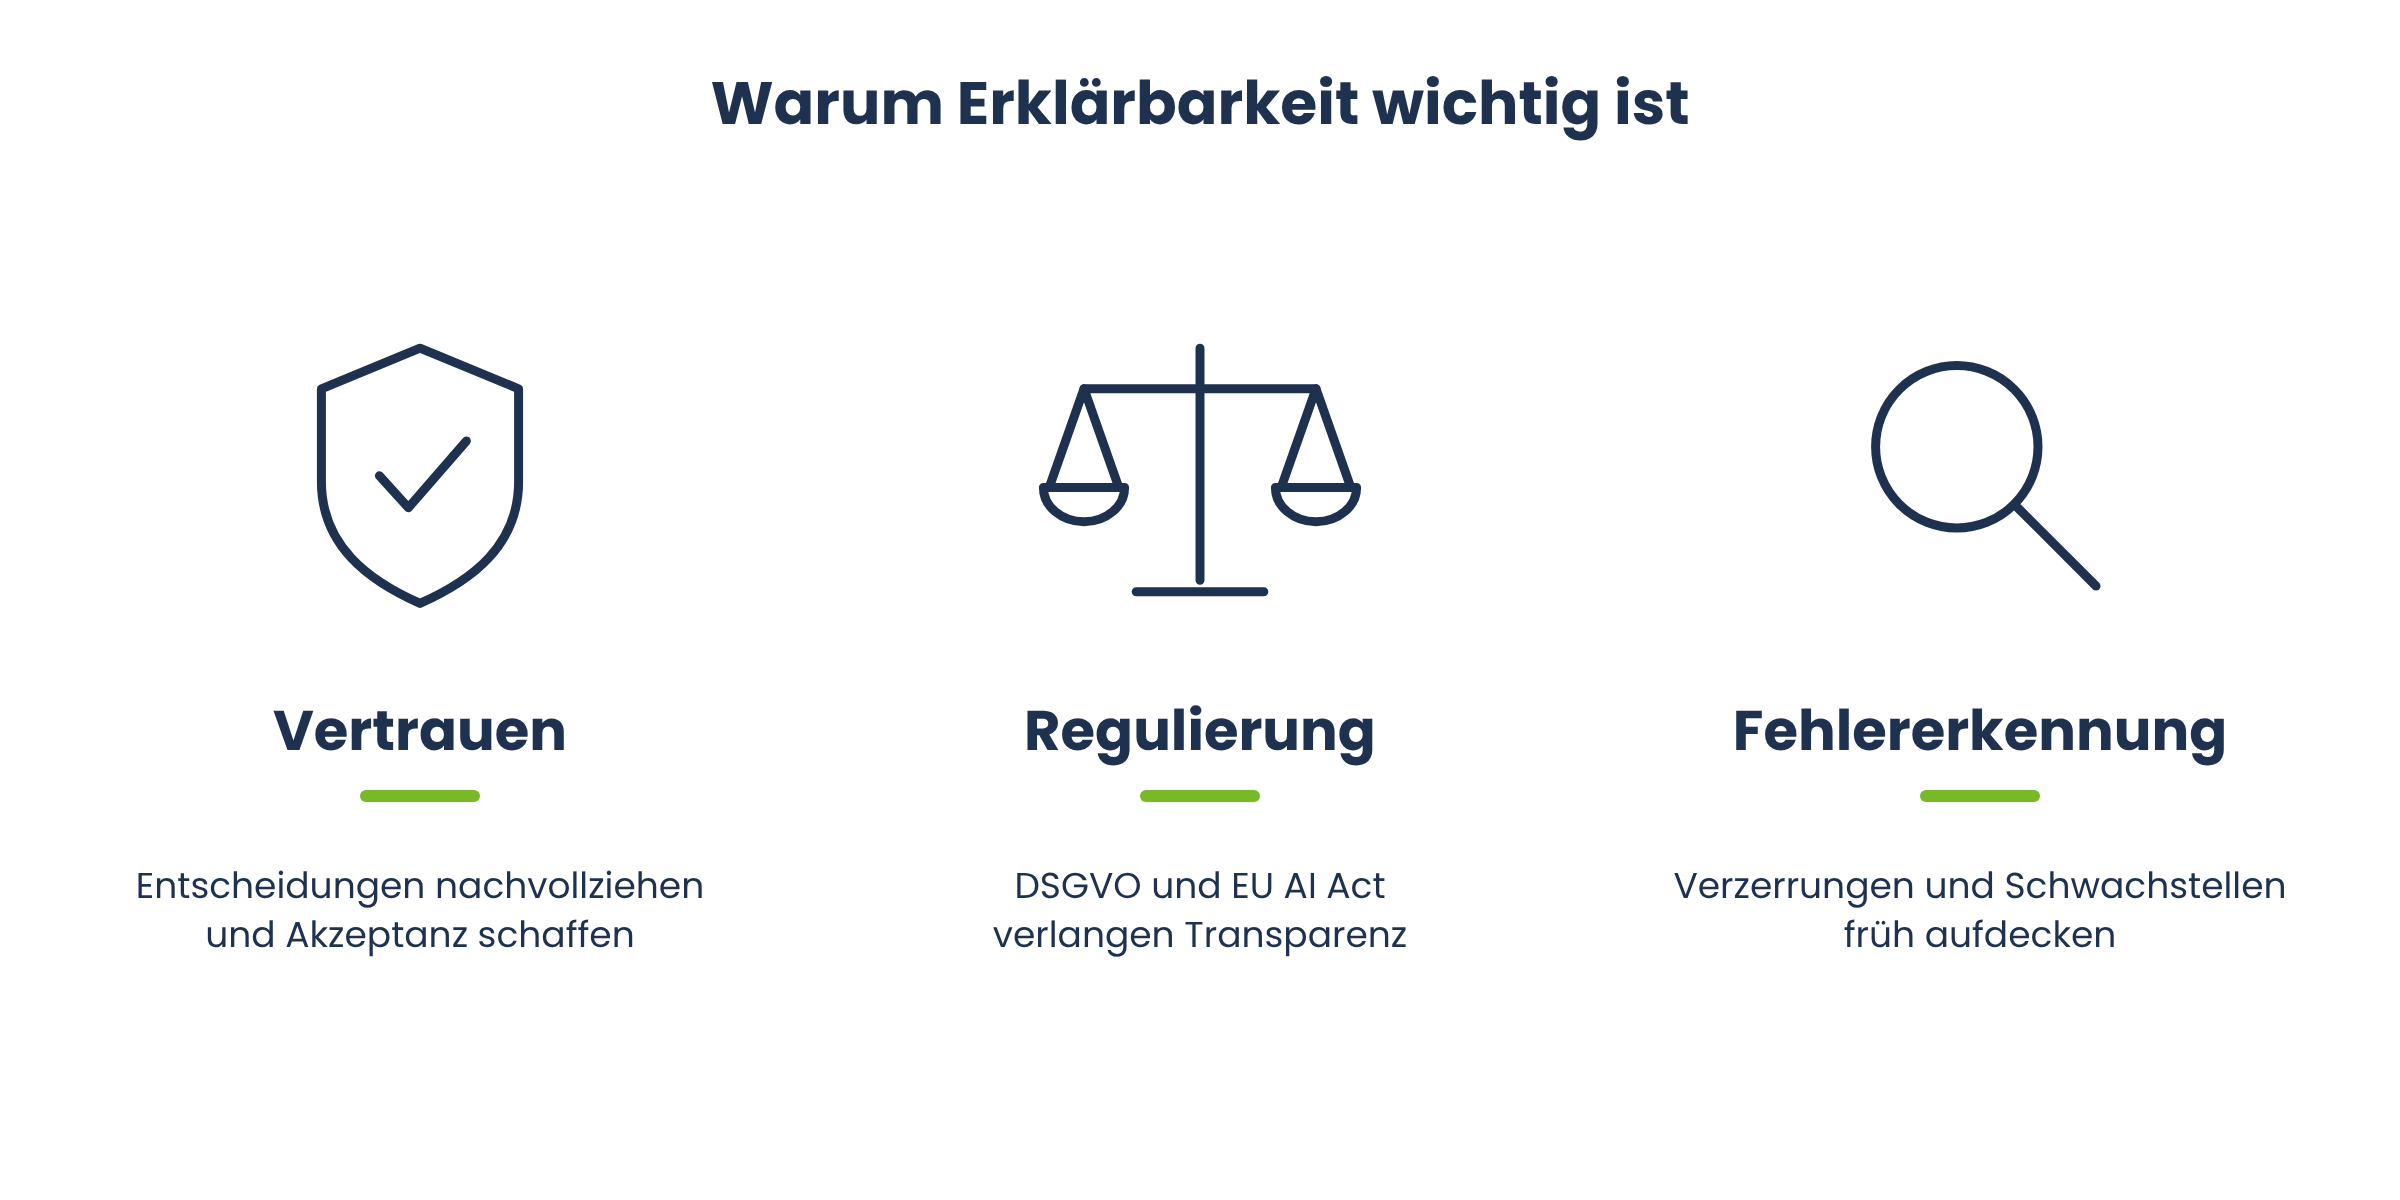
Die Relevanz von Explainable AI lässt sich an drei zentralen Gründen festmachen: Vertrauen, Regulierung und Fehlererkennung. Jeder dieser Aspekte betrifft Unternehmen unmittelbar, sobald KI-Modelle in geschäftskritischen Prozessen eingesetzt werden.
Grund #1: Vertrauen in KI-gestützte Entscheidungen aufbauen
Menschen vertrauen Entscheidungen eher, wenn sie deren Zustandekommen nachvollziehen können. Das gilt für zwischenmenschliche Kommunikation genauso wie für den Umgang mit Technologie. Ein KI-System, das lediglich ein Ergebnis ausgibt, ohne Begründung, wirkt wie ein Orakel – und das untergräbt die Akzeptanz, selbst wenn die Vorhersagen objektiv korrekt sind.
Für Mitarbeitende, die mit KI-gestützten Systemen arbeiten, ist Nachvollziehbarkeit sogar eine Voraussetzung für sinnvolle Zusammenarbeit. Wer eine KI-Empfehlung nicht versteht, kann sie weder sinnvoll validieren noch gegenüber Kundinnen und Kunden vertreten. Explainable AI schafft hier die nötige Grundlage: Sie macht aus einem reinen Vorhersagewerkzeug einen nachvollziehbaren Entscheidungsassistenten.
Grund #2: Gesetzliche und regulatorische Anforderungen erfüllen
Transparenz bei KI-Entscheidungen ist längst nicht mehr nur eine gute Idee, sondern in vielen Fällen gesetzlich vorgeschrieben. Die europäische Datenschutz-Grundverordnung (DSGVO) und der EU AI Act stellen konkrete Anforderungen an die Nachvollziehbarkeit automatisierter Entscheidungsprozesse. Auf beide Regelwerke gehen wir weiter unten im Detail ein. Für Unternehmen bedeutet das schon heute: Wer KI-Systeme für risikobehaftete Anwendungsfälle wie Kreditvergabe, Personalauswahl oder medizinische Diagnostik einsetzt, kommt an Explainable-AI-Methoden kaum noch vorbei.
Grund #3: Fehler, Verzerrungen und Schwachstellen frühzeitig erkennen
Ein KI-Modell kann auch dann fehlerhaft arbeiten, wenn seine Genauigkeit auf dem Papier hoch ist. Ein klassisches Beispiel: Ein Bildklassifikator soll Wölfe und Huskys unterscheiden und erkennt „Wolf" zuverlässig – bis sich herausstellt, dass er in Wahrheit gar nicht das Tier, sondern den Schnee im Hintergrund als entscheidendes Merkmal gelernt hat. Ohne Explainable AI wäre ein solches Fehlverhalten kaum aufgefallen, denn die Testergebnisse hätten weiterhin gestimmt (Ribeiro et al., 2016).
Genau solche versteckten Zusammenhänge deckt XAI auf. Erklärbarkeitsmethoden zeigen, auf welche Merkmale ein Modell tatsächlich reagiert. Damit werden Schwachstellen sichtbar gemacht, bevor sie in der Praxis zu falschen oder diskriminierenden Entscheidungen führen.
Wie funktionieren Black-Box-Modelle – und warum sind sie ein Problem?
Der Begriff Black-Box-Modell beschreibt KI-Systeme, deren interne Funktionsweise für Menschen nicht mehr direkt nachvollziehbar ist. Das betrifft vor allem komplexe Architekturen wie tiefe neuronale Netze, Ensemble-Modelle aus vielen Entscheidungsbäumen oder große Sprachmodelle.
Diese Modelle bestehen aus Millionen oder Milliarden von Parametern, die während des Trainings automatisch angepasst werden. Durch die vielen nichtlinearen Zusammenhänge zwischen diesen Parametern über zahlreiche Schichten hinweg entstehen dabei hochgradig verschachtelte, wechselseitig abhängige Berechnungen. Am Ende steht ein mathematisches Gebilde, das zwar präzise Vorhersagen liefert, dessen einzelne Rechenschritte aber keine intuitive, für Menschen lesbare Bedeutung mehr haben.
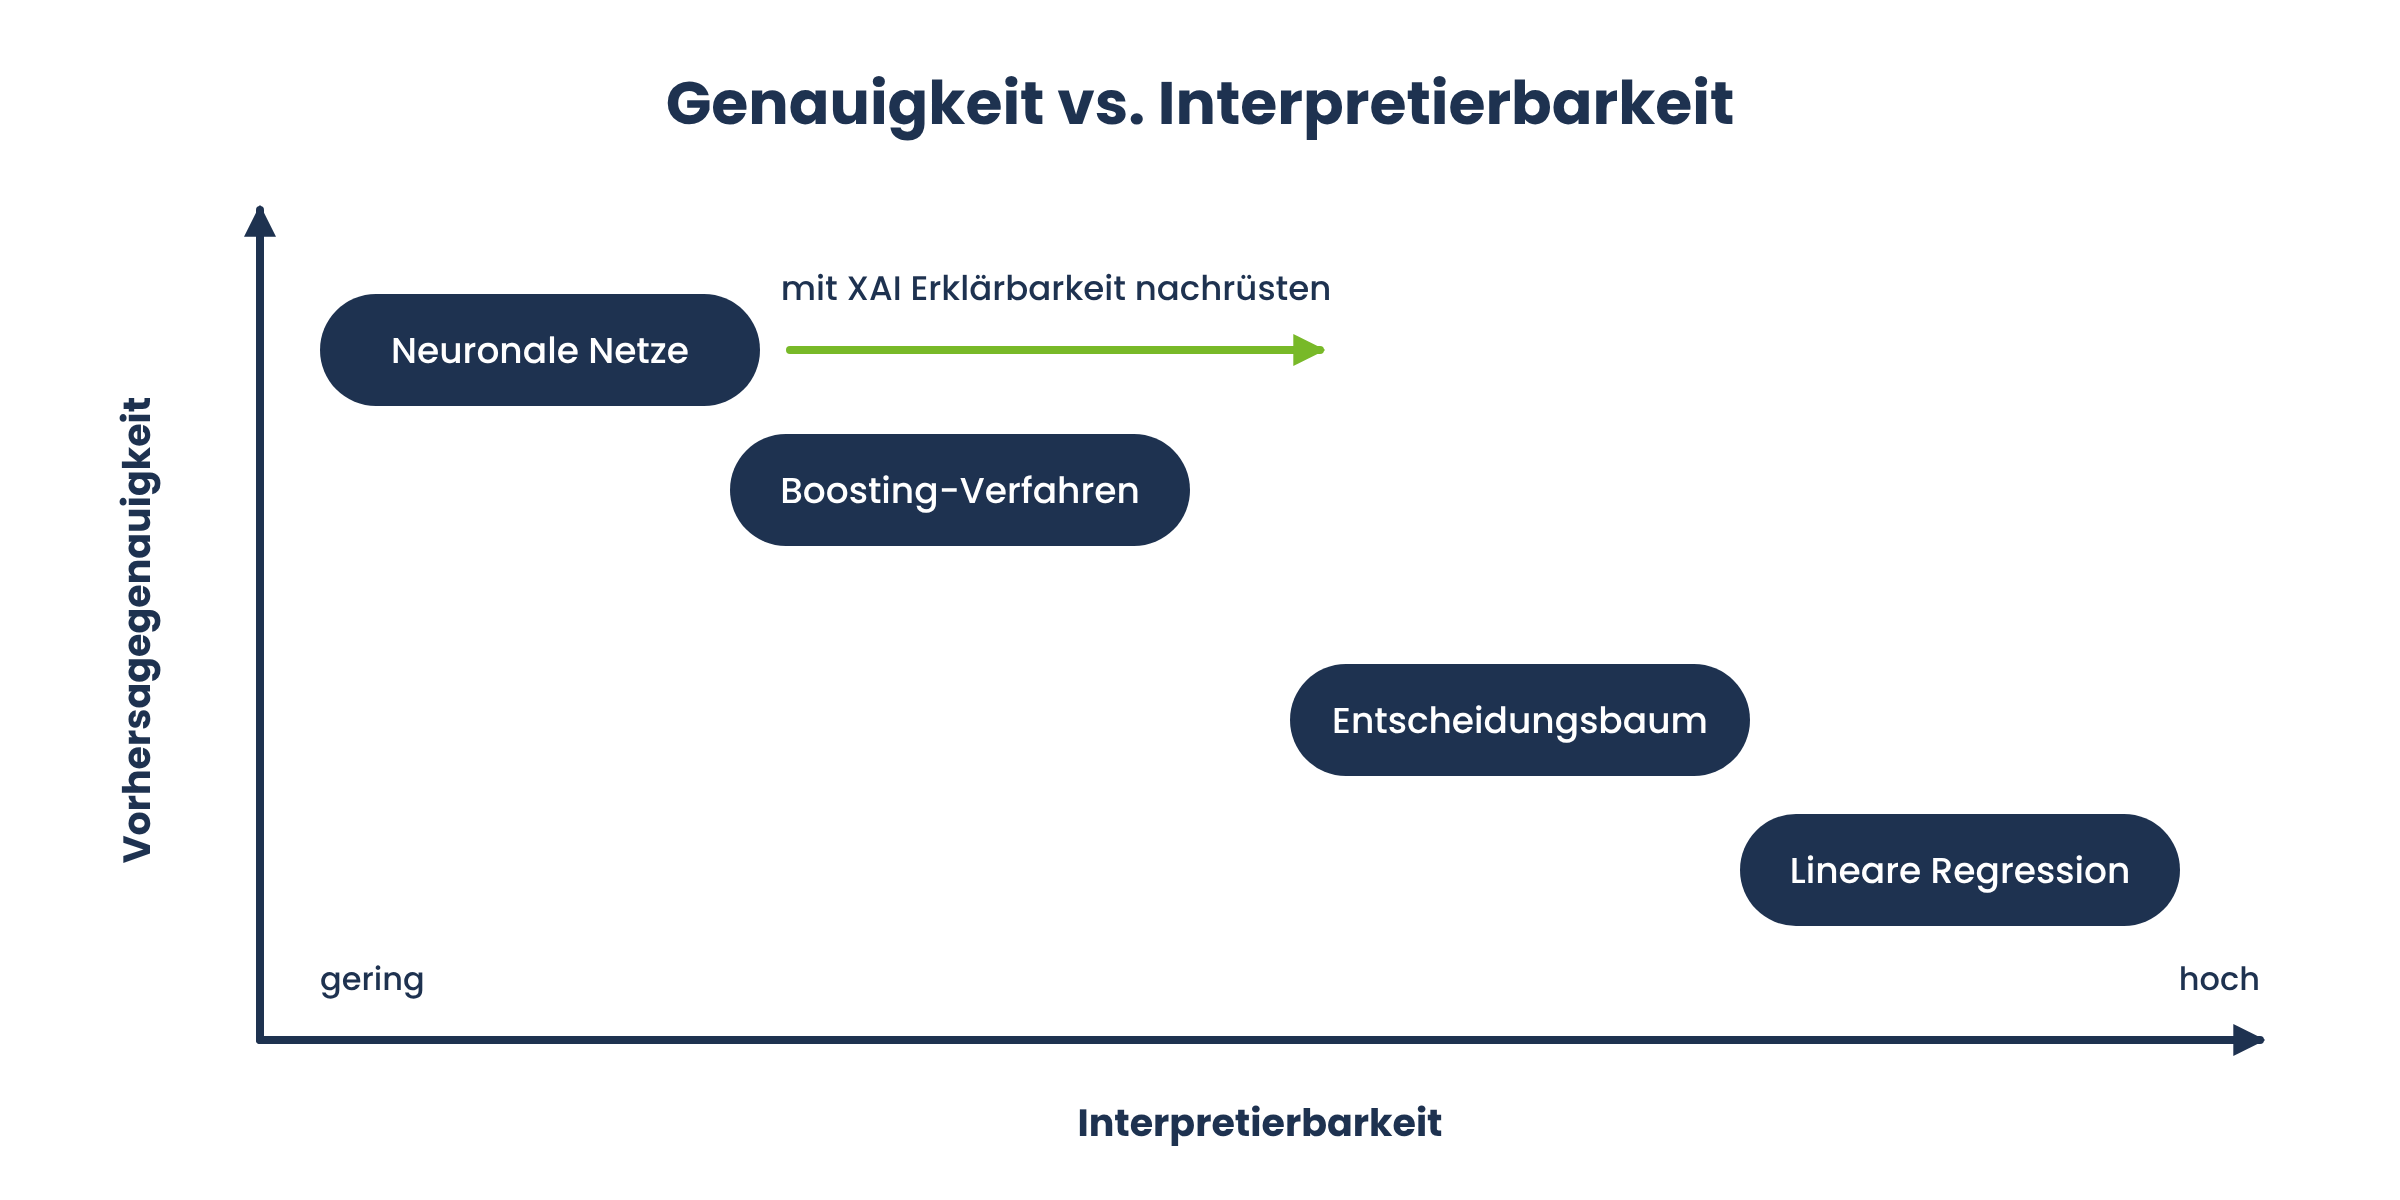
Das Problem dabei: Je leistungsfähiger ein Modell ist, desto komplexer wird in der Regel auch seine Struktur und desto schwerer lässt es sich erklären. Diese Beobachtung führt zu einem Spannungsfeld, das in der Forschung häufig als Trade-off zwischen Genauigkeit und Interpretierbarkeit beschrieben wird. Einfache, von Natur aus verständliche Modelle wie lineare Regressionen oder kleine Entscheidungsbäume liefern zwar nachvollziehbare Ergebnisse, stoßen bei komplexen, hochdimensionalen Problemen aber schnell an ihre Grenzen.
In der Praxis heißt das: Unternehmen, die auf besonders leistungsfähige Modelle setzen, brauchen zusätzliche Werkzeuge, um trotzdem Transparenz herzustellen. Genau diese Lücke schließen die Methoden der Explainable AI.
Interpretability vs. Explainability: Wo liegt der Unterschied?
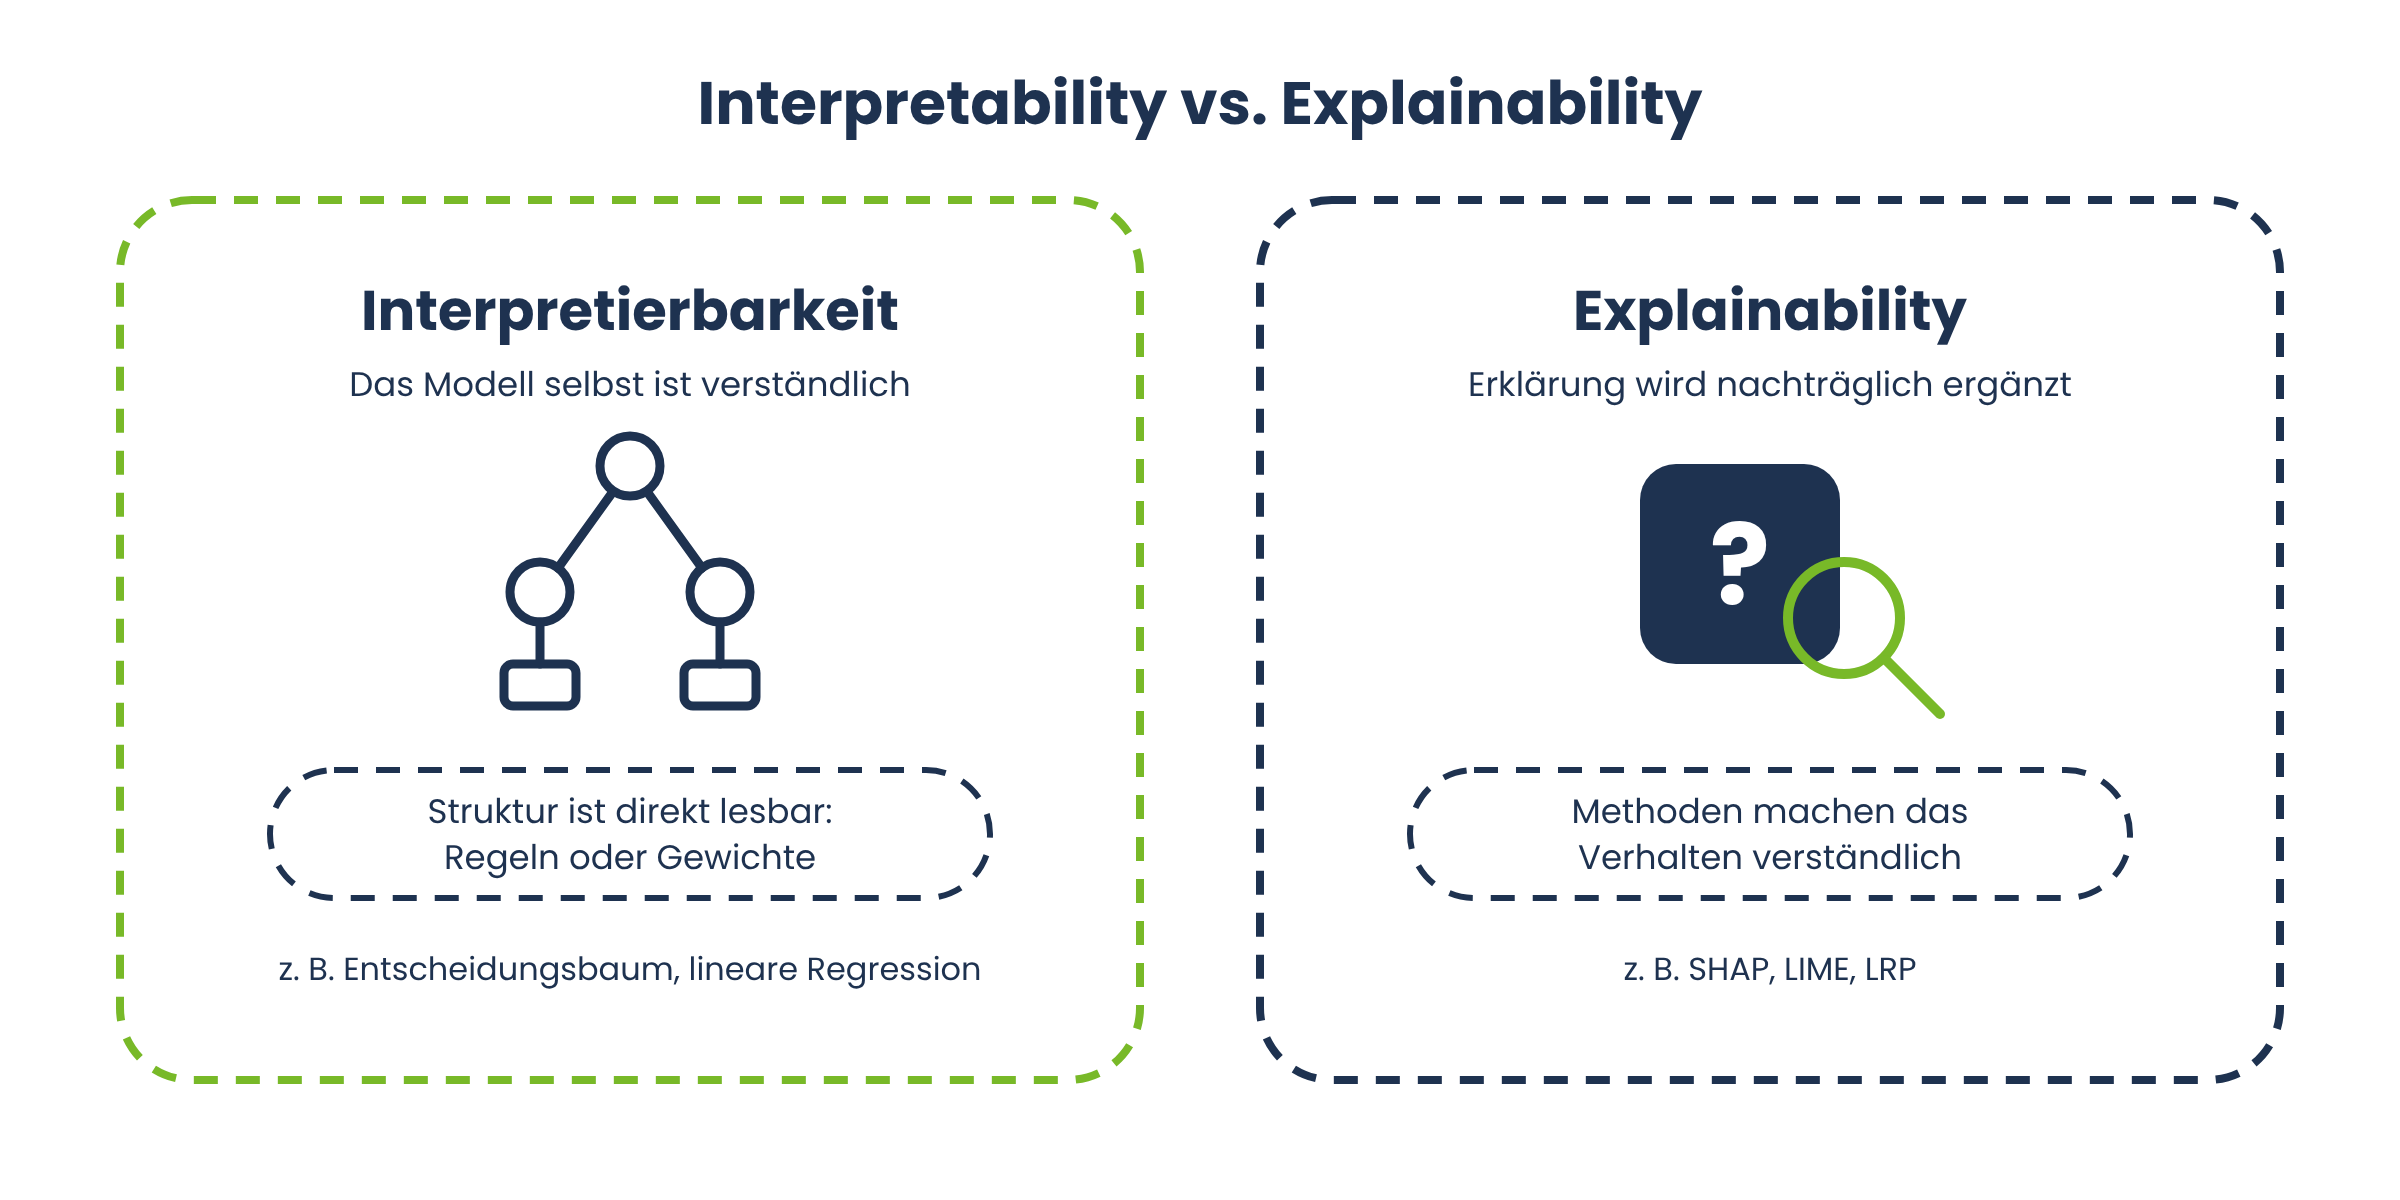
In der Praxis werden die Begriffe Interpretability (Interpretierbarkeit) und Explainability (Erklärbarkeit) oft synonym verwendet. In der Fachliteratur gibt es dafür keine einheitliche Definition. Häufig wird jedoch folgende Unterscheidung getroffen:
Interpretierbarkeit bezieht sich auf die Transparenz eines Modells selbst: Wie leicht lässt sich nachvollziehen, wie ein Modell aus seinen Eingaben zu einem Ergebnis kommt? Ein interpretierbares Modell offenbart seine innere Struktur – etwa die Regeln eines Entscheidungsbaums oder die Gewichte einer linearen Regression – direkt und ohne zusätzliche Hilfsmittel.
Explainability geht einen Schritt weiter und zielt auf nachträgliche Rechtfertigung ab: Mit zusätzlichen Methoden lässt sich das Verhalten eines Modells auch im Nachhinein verständlich machen, unabhängig davon, wie transparent es selbst aufgebaut ist. Besonders relevant ist das bei komplexen Modellen: Ein neuronales Netz zur Bilderkennung bleibt intern eine Black-Box, mit einer Erklärungsmethode lässt sich aber trotzdem zeigen, welche Bildregionen für eine bestimmte Klassifikation ausschlaggebend waren.
Auch wenn die Begriffe uneinheitlich verwendet werden, ist die Unterscheidung mehr als akademische Spitzfindigkeit. Sie beschreibt zwei Wege zu mehr Transparenz: von Grund auf interpretierbare Modelle zu wählen oder leistungsfähigere Black-Box-Modelle nachträglich mit Explainability-Werkzeugen zu erklären. Welcher Weg für ein Unternehmen sinnvoll ist, hängt vor allem von der benötigten Vorhersageleistung und dem verfügbaren Rechenaufwand ab. Interpretierbare Modelle sind meist schneller und günstiger zu trainieren und zu betreiben, erreichen aber bei komplexen Zusammenhängen oft nicht dieselbe Genauigkeit. Black-Box-Modelle wie Boosting-Verfahren oder neuronale Netze können in solchen Fällen die bessere Leistung liefern: Boosting-Verfahren gehören bei tabellarischen Daten oft zu den stärksten Modellen, neuronale Netze spielen ihre Stärke vor allem bei sehr großen Datenmengen und unstrukturierten Daten wie Bildern oder Text aus. Dafür brauchen sie mehr Rechenressourcen, und auch die nachträglichen Erklärungen verursachen zusätzlichen Aufwand.
Welche Arten von XAI-Methoden gibt es?
Die Landschaft der Explainable-AI-Methoden lässt sich anhand zweier Kriterien strukturieren: der Reichweite einer Erklärung (global oder lokal) und dem Zeitpunkt, zu dem Erklärbarkeit hergestellt wird (von Anfang an oder nachträglich).
Global vs. lokal: Zwei Perspektiven auf ein Modell
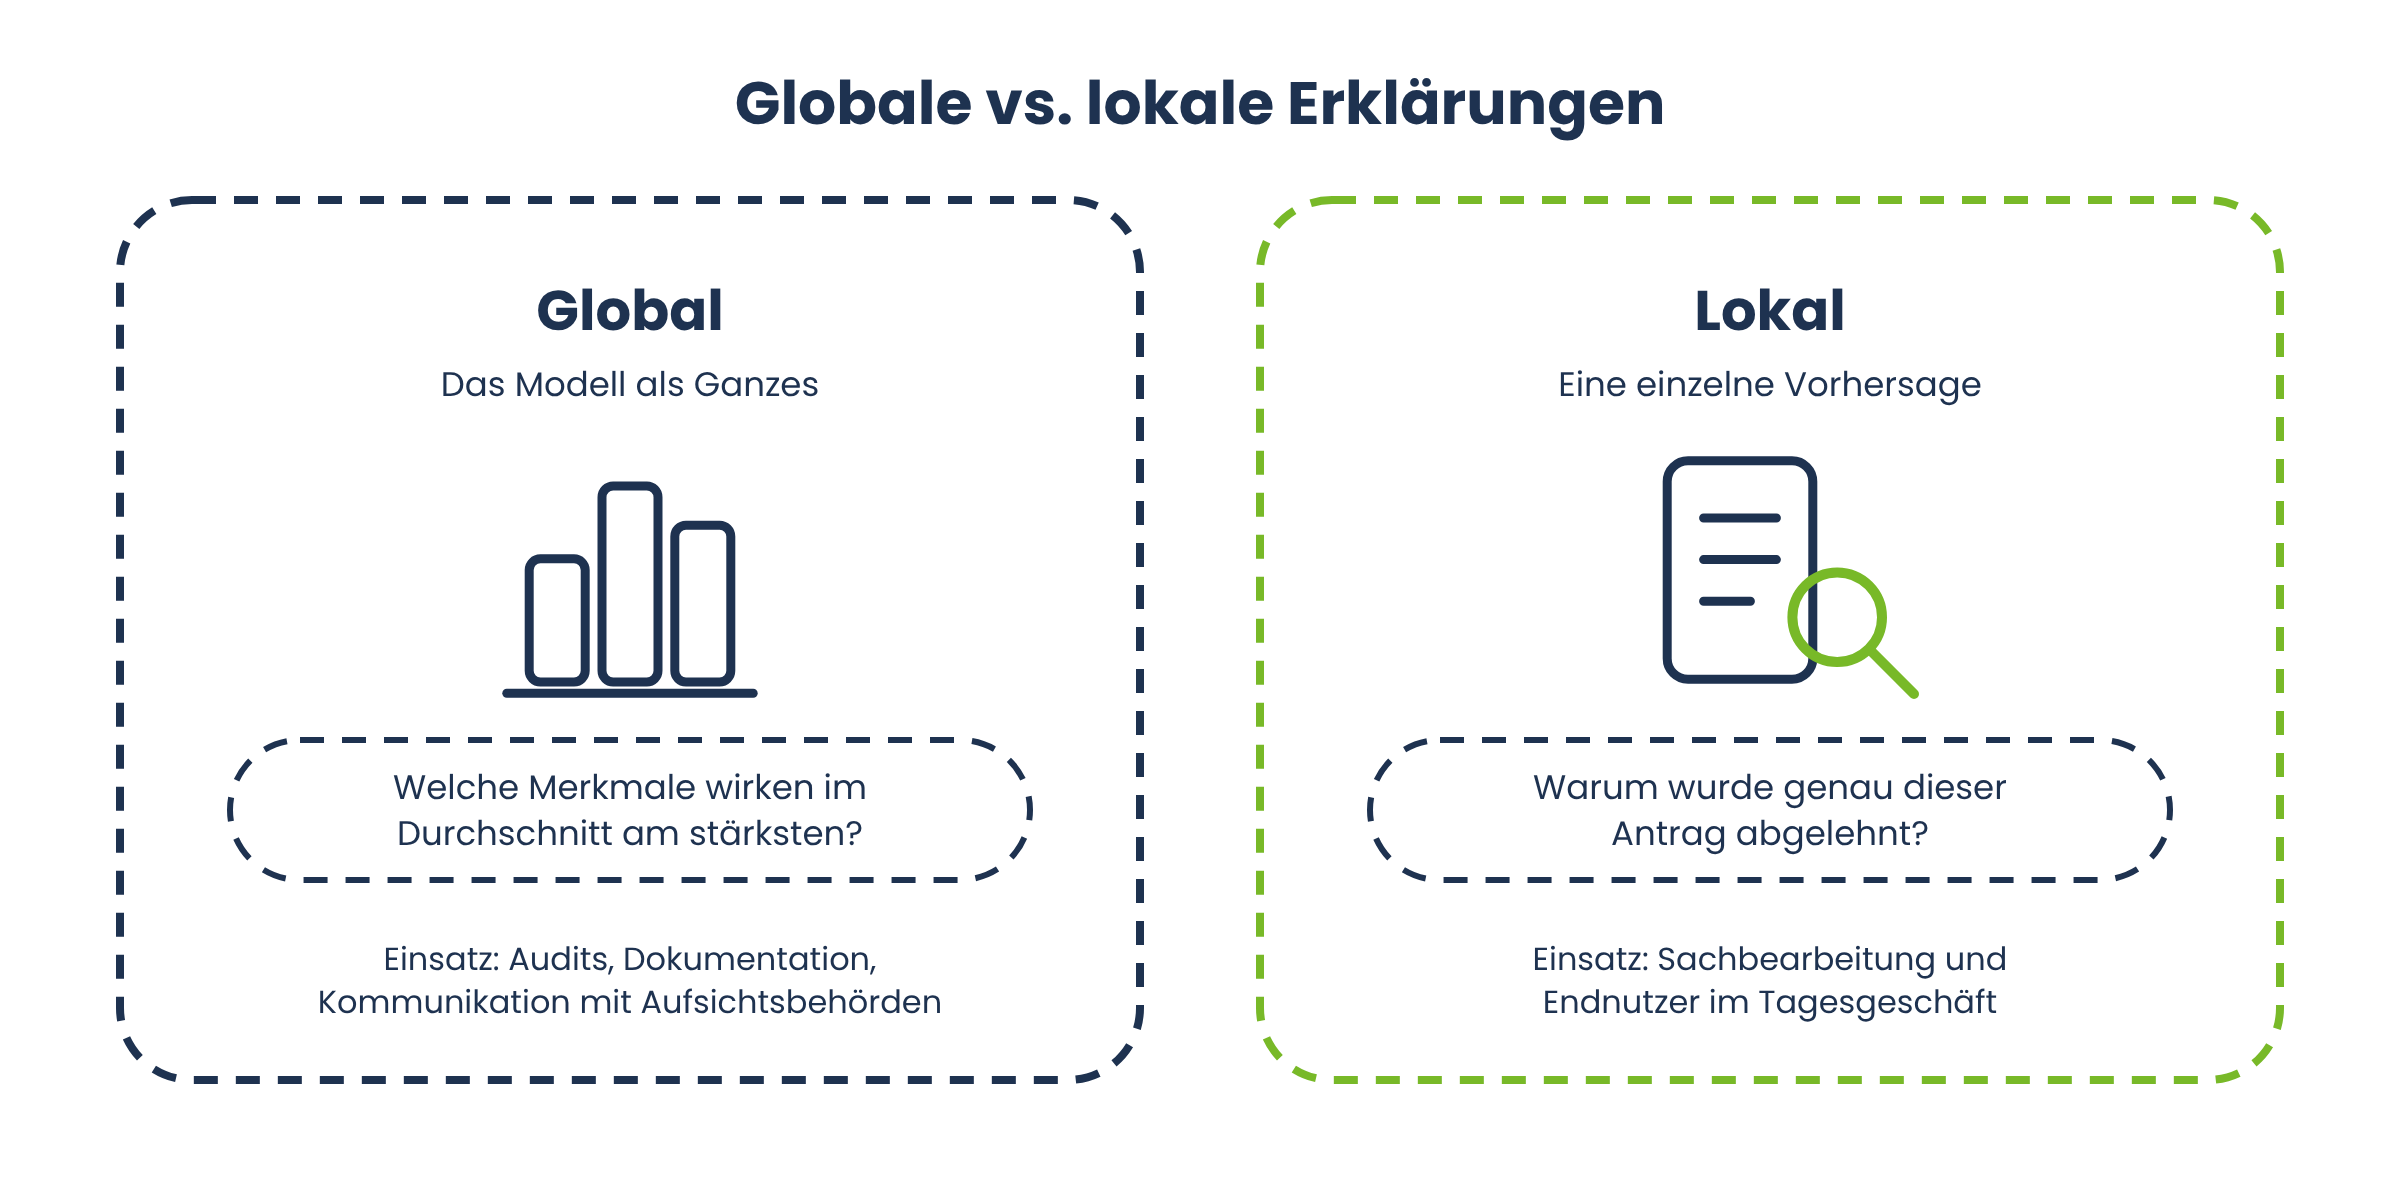
Globale Erklärungen beschreiben das Verhalten eines Modells als Ganzes. Typische Verfahren sind Permutation Feature Importance und Partial Dependence Plots. Sie beantworten Fragen wie: Welche Merkmale beeinflussen die Vorhersagen im Durchschnitt am stärksten? Gibt es systematische Muster, etwa eine übermäßige Gewichtung bestimmter demografischer Merkmale? Gibt es systematische Muster, etwa eine übermäßige Gewichtung bestimmter demografischer Merkmale wie Alter oder Geschlecht? Oder wirken Merkmale wie die Postleitzahl als Stellvertreter für geschützte Eigenschaften? Globale Erklärungen eignen sich besonders gut für Audits, Modell-Dokumentation und die Kommunikation mit Aufsichtsbehörden.
Lokale Erklärungen fokussieren dagegen auf eine einzelne Vorhersage. Sie beantworten die Frage: Warum wurde genau dieser eine Kreditantrag abgelehnt, dieses eine Röntgenbild als auffällig eingestuft oder dieser eine Datensatz als Betrugsfall markiert? Für Endnutzer und Sachbearbeiter im Tagesgeschäft sind lokale Erklärungen meist relevanter, weil sie sich unmittelbar auf den konkreten Einzelfall beziehen.
Intrinsisch interpretierbare Modelle vs. Post-hoc-Erklärungen
Bei intrinsisch interpretierbaren Modellen ist die Nachvollziehbarkeit fest in die Modellarchitektur eingebaut. Dazu zählen etwa lineare und logistische Regressionen, kleinere Entscheidungsbäume oder Regelsysteme. Ihr großer Vorteil: Es gibt keine Diskrepanz zwischen dem, was das Modell tatsächlich berechnet, und der Erklärung, die ausgegeben wird – beides ist identisch.
Post-hoc-Erklärungen setzen dagegen nach dem Training an. Sie werden auf bestehende, meist komplexere Modelle angewendet, um deren Verhalten im Nachhinein plausibel zu machen. Dazu zählen die meisten der im Folgenden vorgestellten Verfahren wie SHAP, LIME oder Layerwise Relevance Propagation auch weit verbreitete Ansätze wie Permutation Feature Importance und Partial Dependence Plots. Der Vorteil liegt in der Flexibilität: Post-hoc-Methoden lassen sich auf nahezu jedes Modell anwenden, unabhängig von dessen interner Struktur. Der Nachteil: Die erzeugte Erklärung ist eine Annäherung an das tatsächliche Modellverhalten, nicht das Verhalten selbst.
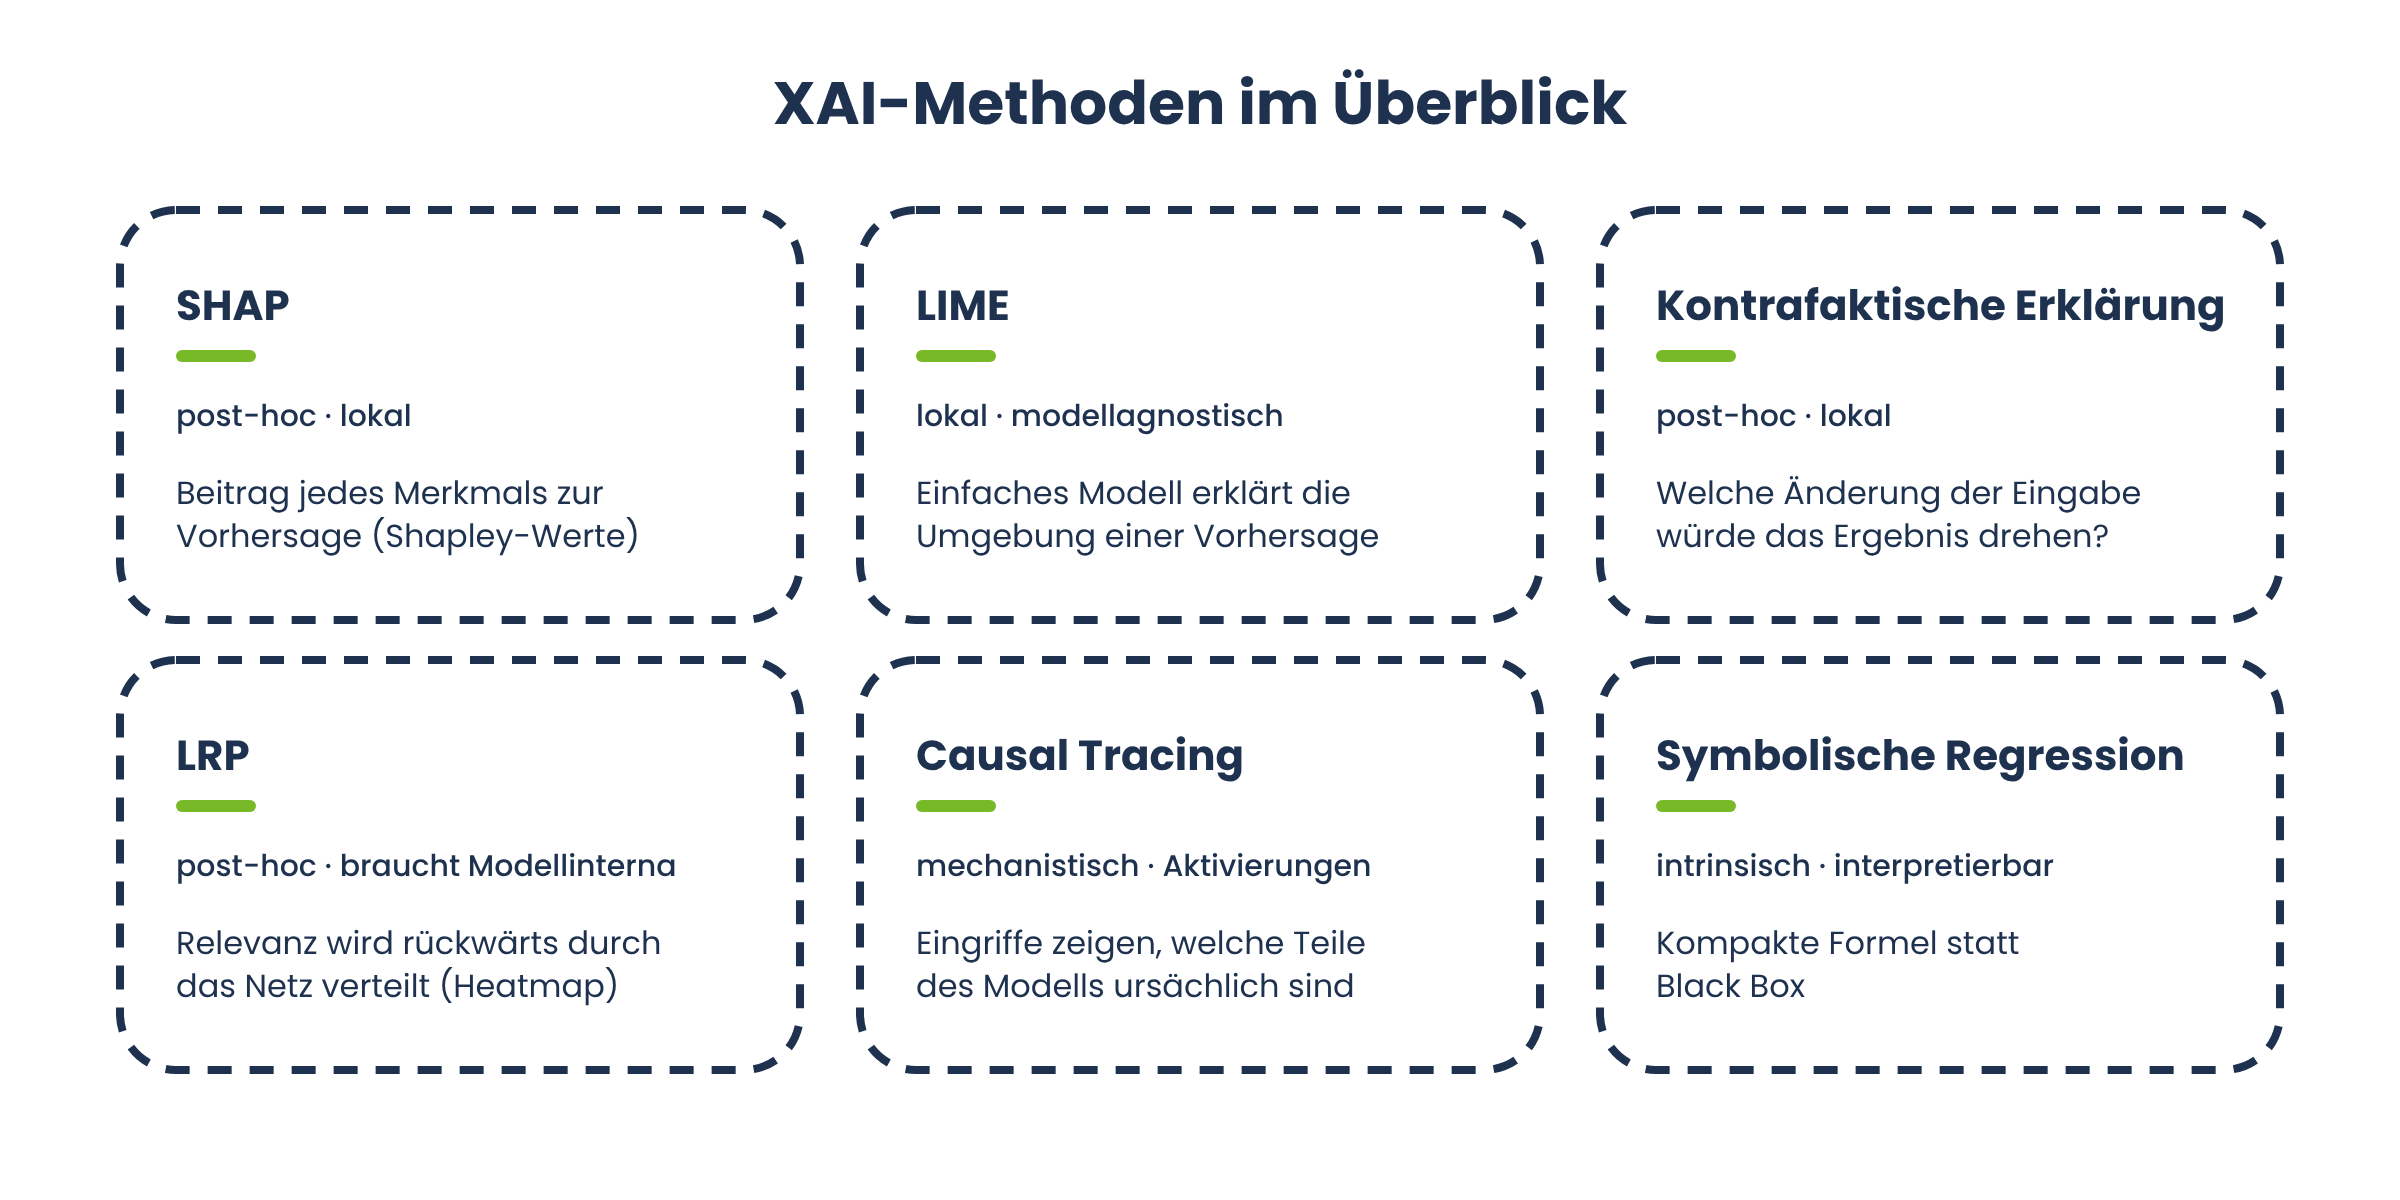
Wie funktioniert SHAP (Shapley Additive Explanations)?
SHAP steht für Shapley Additive Explanations und zählt zu den am weitesten verbreiteten Methoden der Explainable AI. Entwickelt wurde der Ansatz 2017 von den Forschenden Scott Lundberg und Su-In Lee, die damit ein einheitliches Framework für die Interpretation von Modellvorhersagen vorstellten (Lundberg & Lee, 2017).
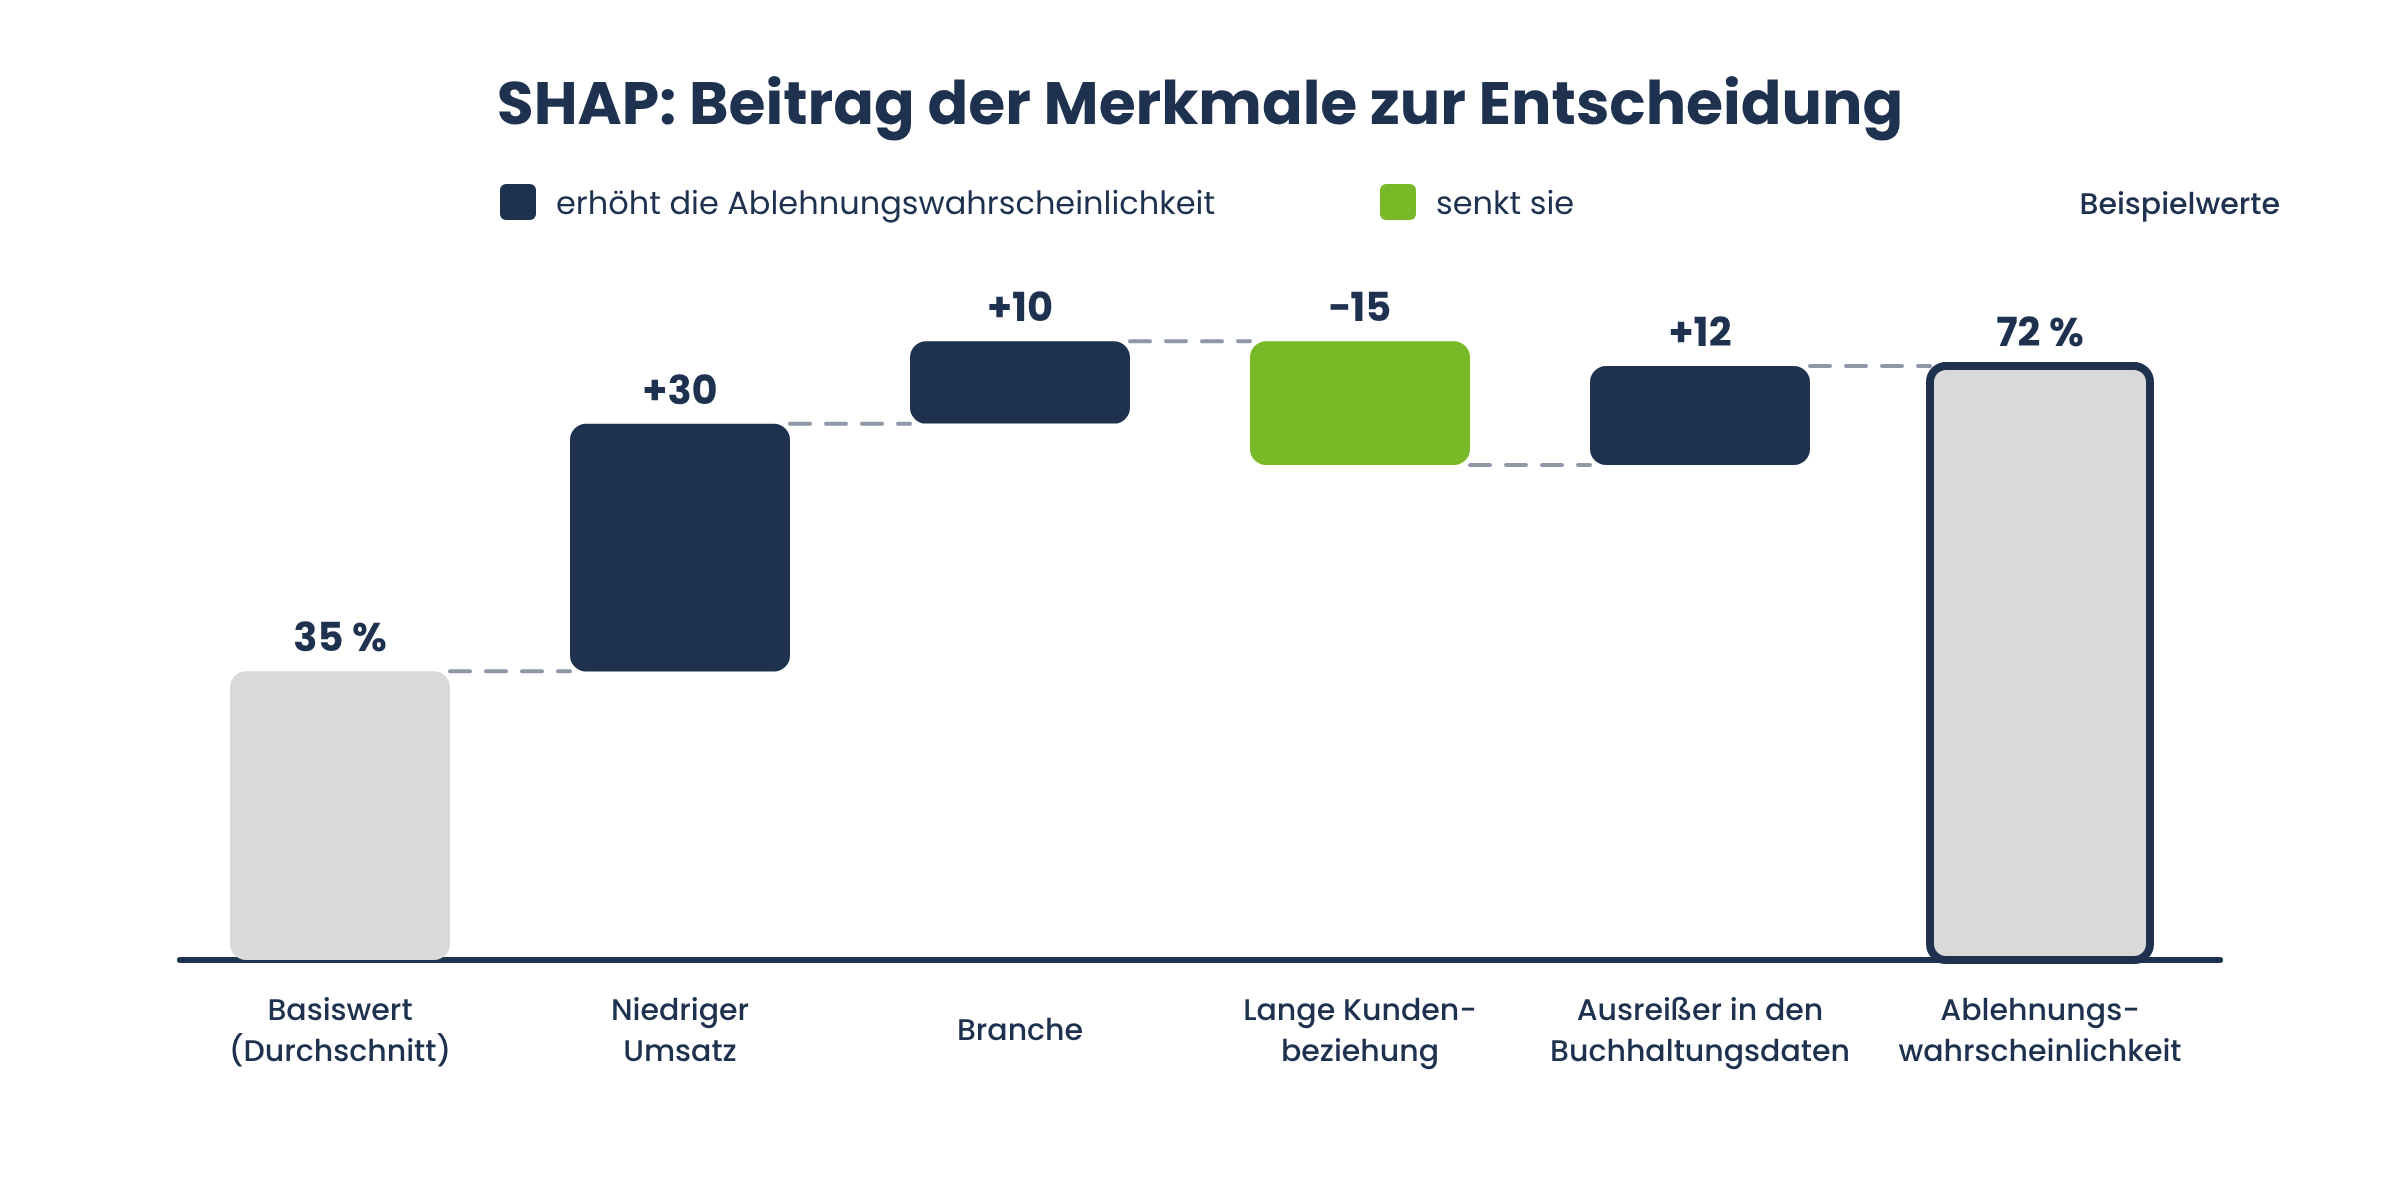
Die Grundidee von SHAP stammt aus der Spieltheorie und basiert auf dem sogenannten Shapley-Wert, benannt nach dem Mathematiker Lloyd Shapley. Ursprünglich diente dieses Konzept dazu, den sogenannten fairen Anteil jedes Spielers am gemeinsamen Gewinn einer Koalition zu berechnen. SHAP überträgt dieses Prinzip auf maschinelles Lernen: Jedes Merkmal eines Datensatzes wird wie ein „Spieler“ behandelt, und SHAP berechnet, wie stark dieses Merkmal zur konkreten Vorhersage beigetragen hat – verglichen mit dem Durchschnittswert aller möglichen Merkmalskombinationen.
Das Ergebnis ist ein SHAP-Wert pro Merkmal und Vorhersage. Positive Werte zeigen an, dass ein Merkmal die Vorhersage in eine bestimmte Richtung verschoben hat, negative Werte das Gegenteil. In der Praxis lässt sich damit für den eingangs erwähnten Kreditantrag nachvollzehbar aufschlüsseln: Der niedrige Umsatz hat die Ablehnungswahrscheinlichkeit um X Prozentpunkte erhöht, die lange Kundenbeziehung sie dagegen um Y Prozentpunkte gesenkt.
Ein besonderer Vorzug von SHAP liegt in seinen theoretischen Eigenschaften: Lokale Genauigkeit, Konsistenz und die korrekte Behandlung fehlender Werte sind mathematisch garantiert. Das unterscheidet SHAP von vielen älteren Feature-Importance-Methoden, die diese Eigenschaften nicht erfüllen. Der Preis dafür ist der Rechenaufwand: Eine exakte Berechnung aller möglichen Merkmalskombinationen ist bei vielen Merkmalen praktisch nicht durchführbar, weshalb in der Praxis effizientere Verfahren wie Kernel SHAP oder Tree SHAP zum Einsatz kommen. Letzteres wurde speziell für baumbasierte Modelle wie Random Forests oder Gradient Boosting entwickelt.
Was ist LIME – und wie unterscheidet es sich von SHAP?
LIME steht für Local Interpretable Model-agnostic Explanations und wurde 2016 von Marco Tulio Ribeiro, Sameer Singh und Carlos Guestrin vorgestellt (Ribeiro et al., 2016). Wie der Name andeutet, ist LIME lokal (es erklärt einzelne Vorhersagen), interpretierbar (die Erklärung selbst ist einfach zu verstehen) und modellagnostisch (es benötigt nur Zugriff auf das Vorhersagefunktion des Modells, nicht auf dessen interne Struktur).
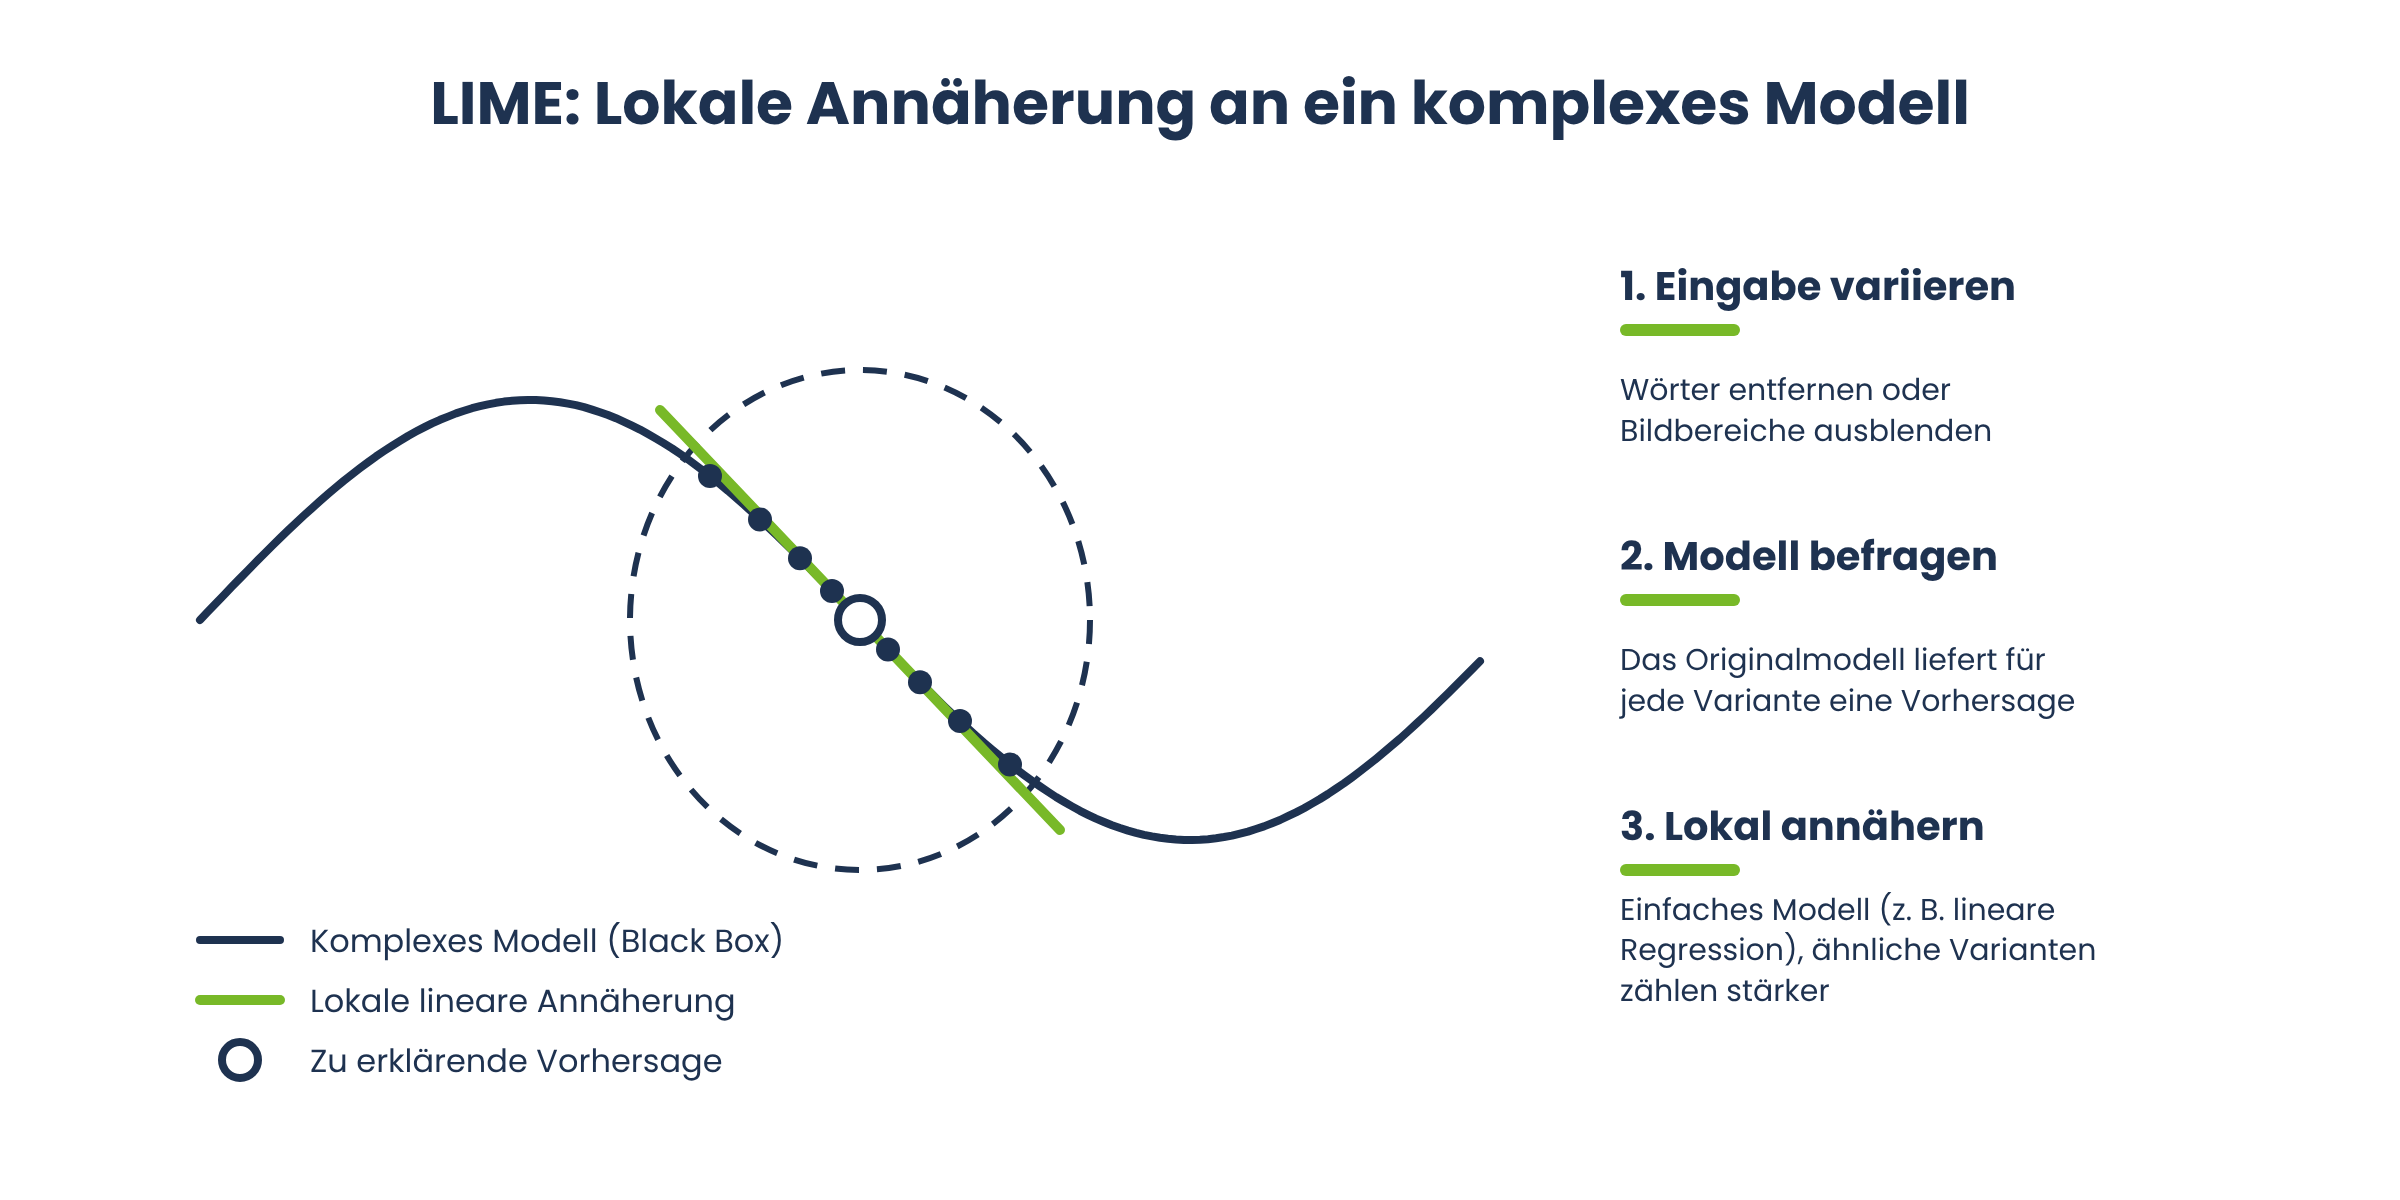
Die Funktionsweise von LIME lässt sich anschaulich erklären: Um eine einzelne Vorhersage zu erklären, erzeugt LIME zunächst leicht veränderte Varianten der ursprünglichen Eingabe – etwa, indem bei einem Text einzelne Wörter entfernt oder bei einem Bild einzelne Bildbereiche ausgeblendet werden. Für jede dieser Varianten fragt LIME das Originalmodell nach einer Vorhersage. Anschließend wird auf diesen künstlich erzeugten Datenpunkten ein einfaches, gut interpretierbares Modell trainiert, meist eine lineare Regression. Dabei zählen Varianten, die der ursprünglichen Eingabe ähnlicher sind, stärker. Dieses einfache Modell approximiert das Verhalten des komplexen Originalmodells – aber eben nur lokal, also in der unmittelbaren Umgebung der zu erklärenden Vorhersage.
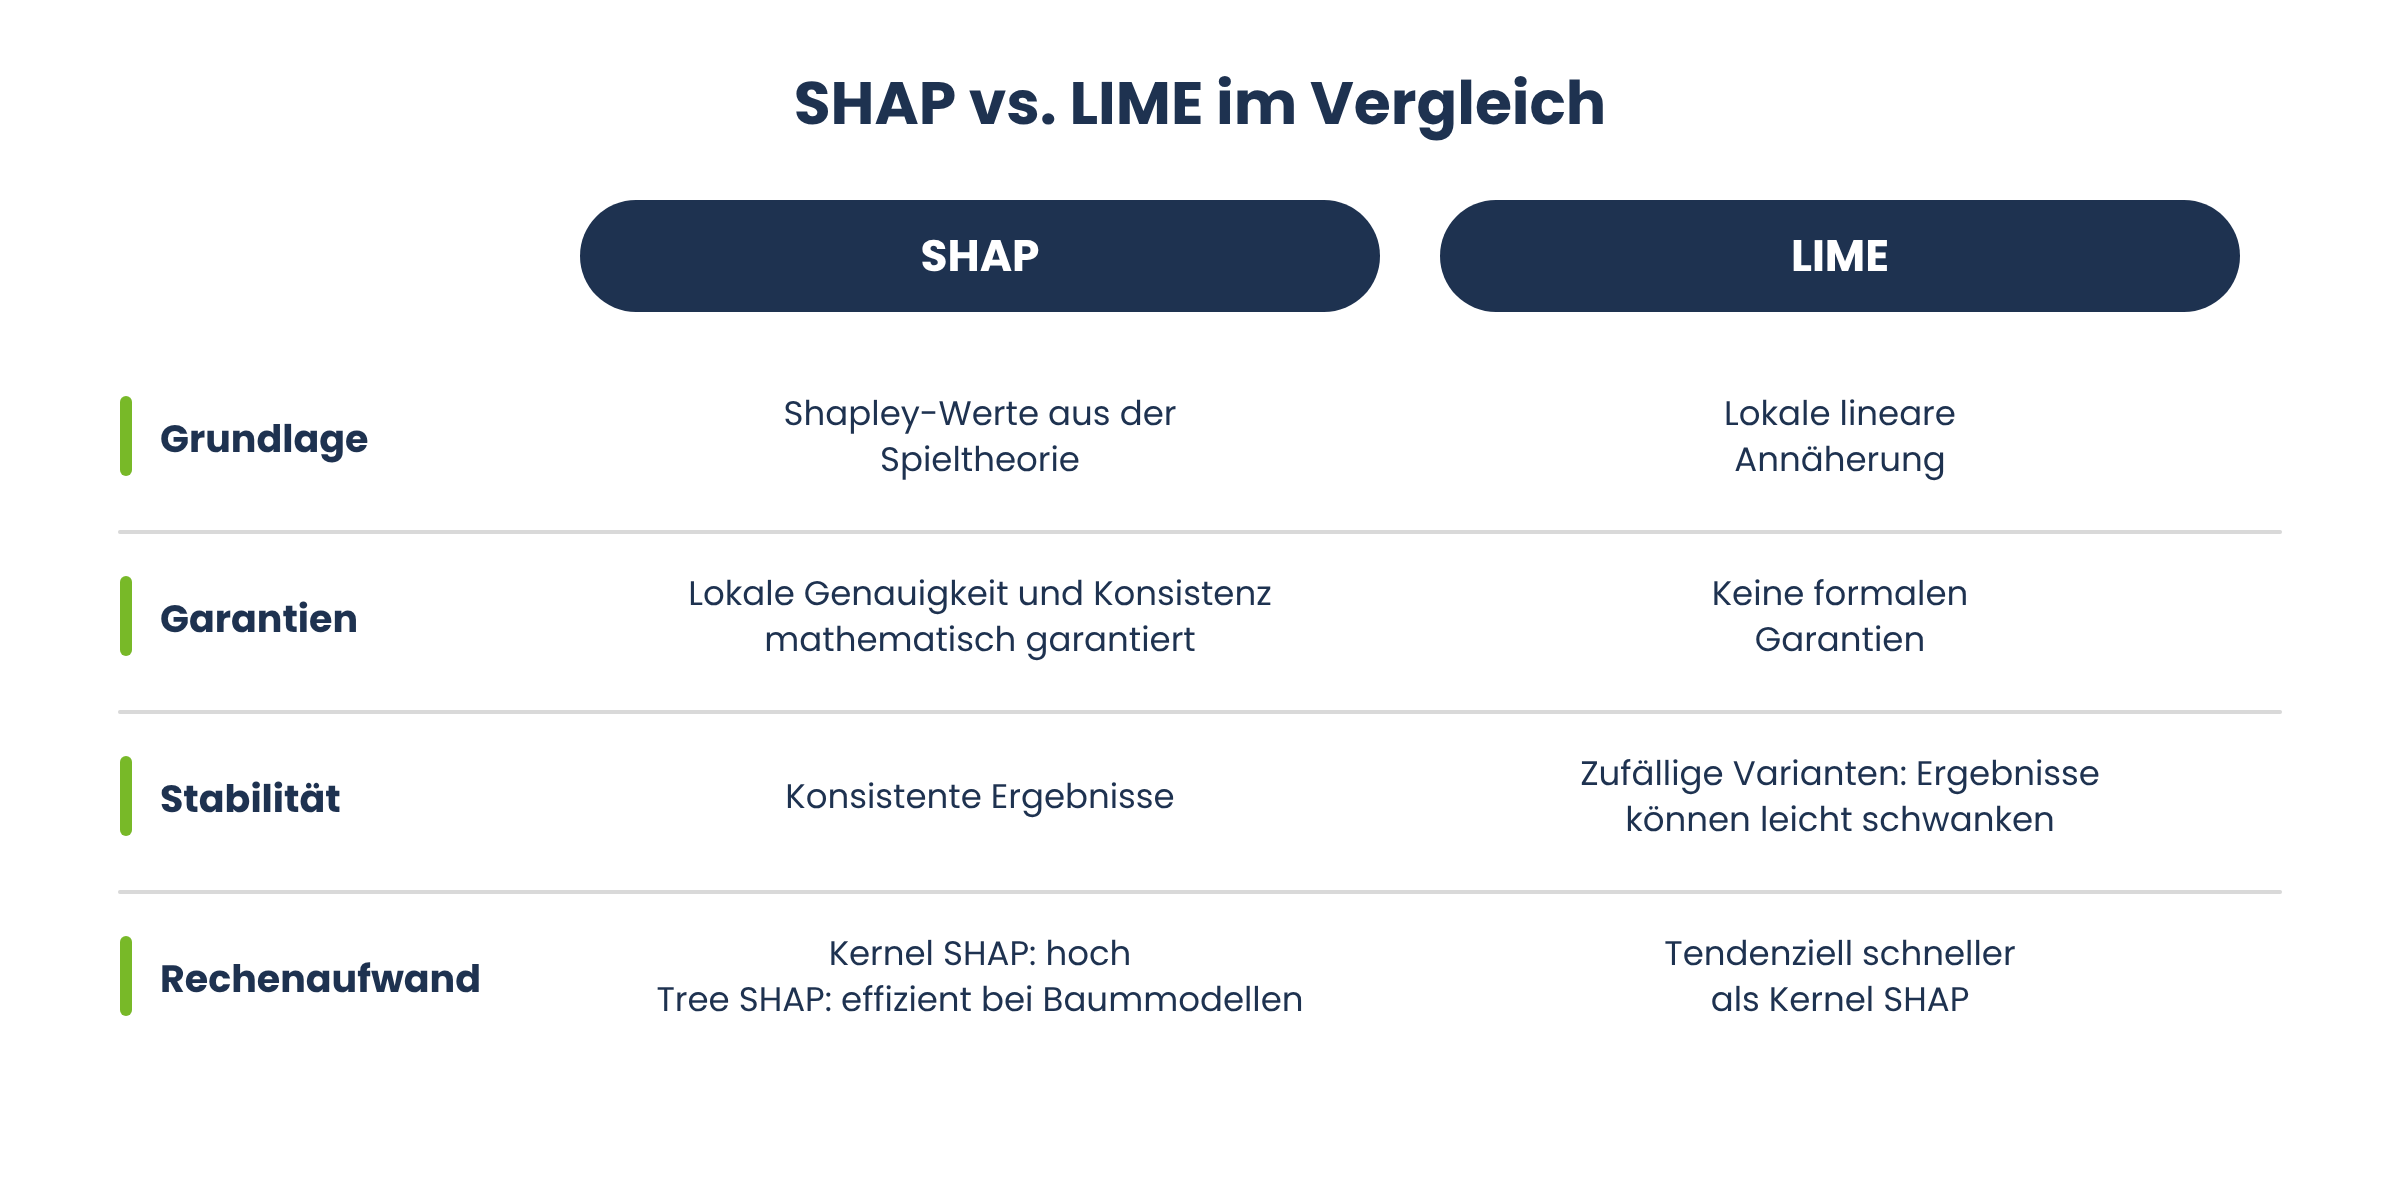
Der wesentliche Unterschied zu SHAP liegt im theoretischen Fundament. Während SHAP auf den spieltheoretisch fundierten Shapley-Werten basiert und dadurch bestimmte Konsistenzeigenschaften garantiert, arbeitet LIME mit einer lokalen, linearen Annäherung ohne diese formalen Garantien. Da LIME die Varianten der Eingabe zufällig erzeugt, können die Erklärungen zudem von Durchlauf zu Durchlauf leicht schwanken. In der Praxis bedeutet das: LIME ist tendenziell schneller zu berechnen und intuitiv verständlich, SHAP liefert dafür konsistentere und theoretisch fundiertere Ergebnisse. Der Geschwindigkeitsvorteil von LIME gilt allerdings vor allem gegenüber dem modellagnostischen Kernel SHAP. Bei baumbasierten Modellen ermöglicht Tree SHAP eine sehr effiziente Berechnung. Viele Unternehmen setzen deshalb je nach Anwendungsfall auf beide Methoden parallel.
Was sind kontrafaktische Erklärungen (Counterfactual Explanations)?
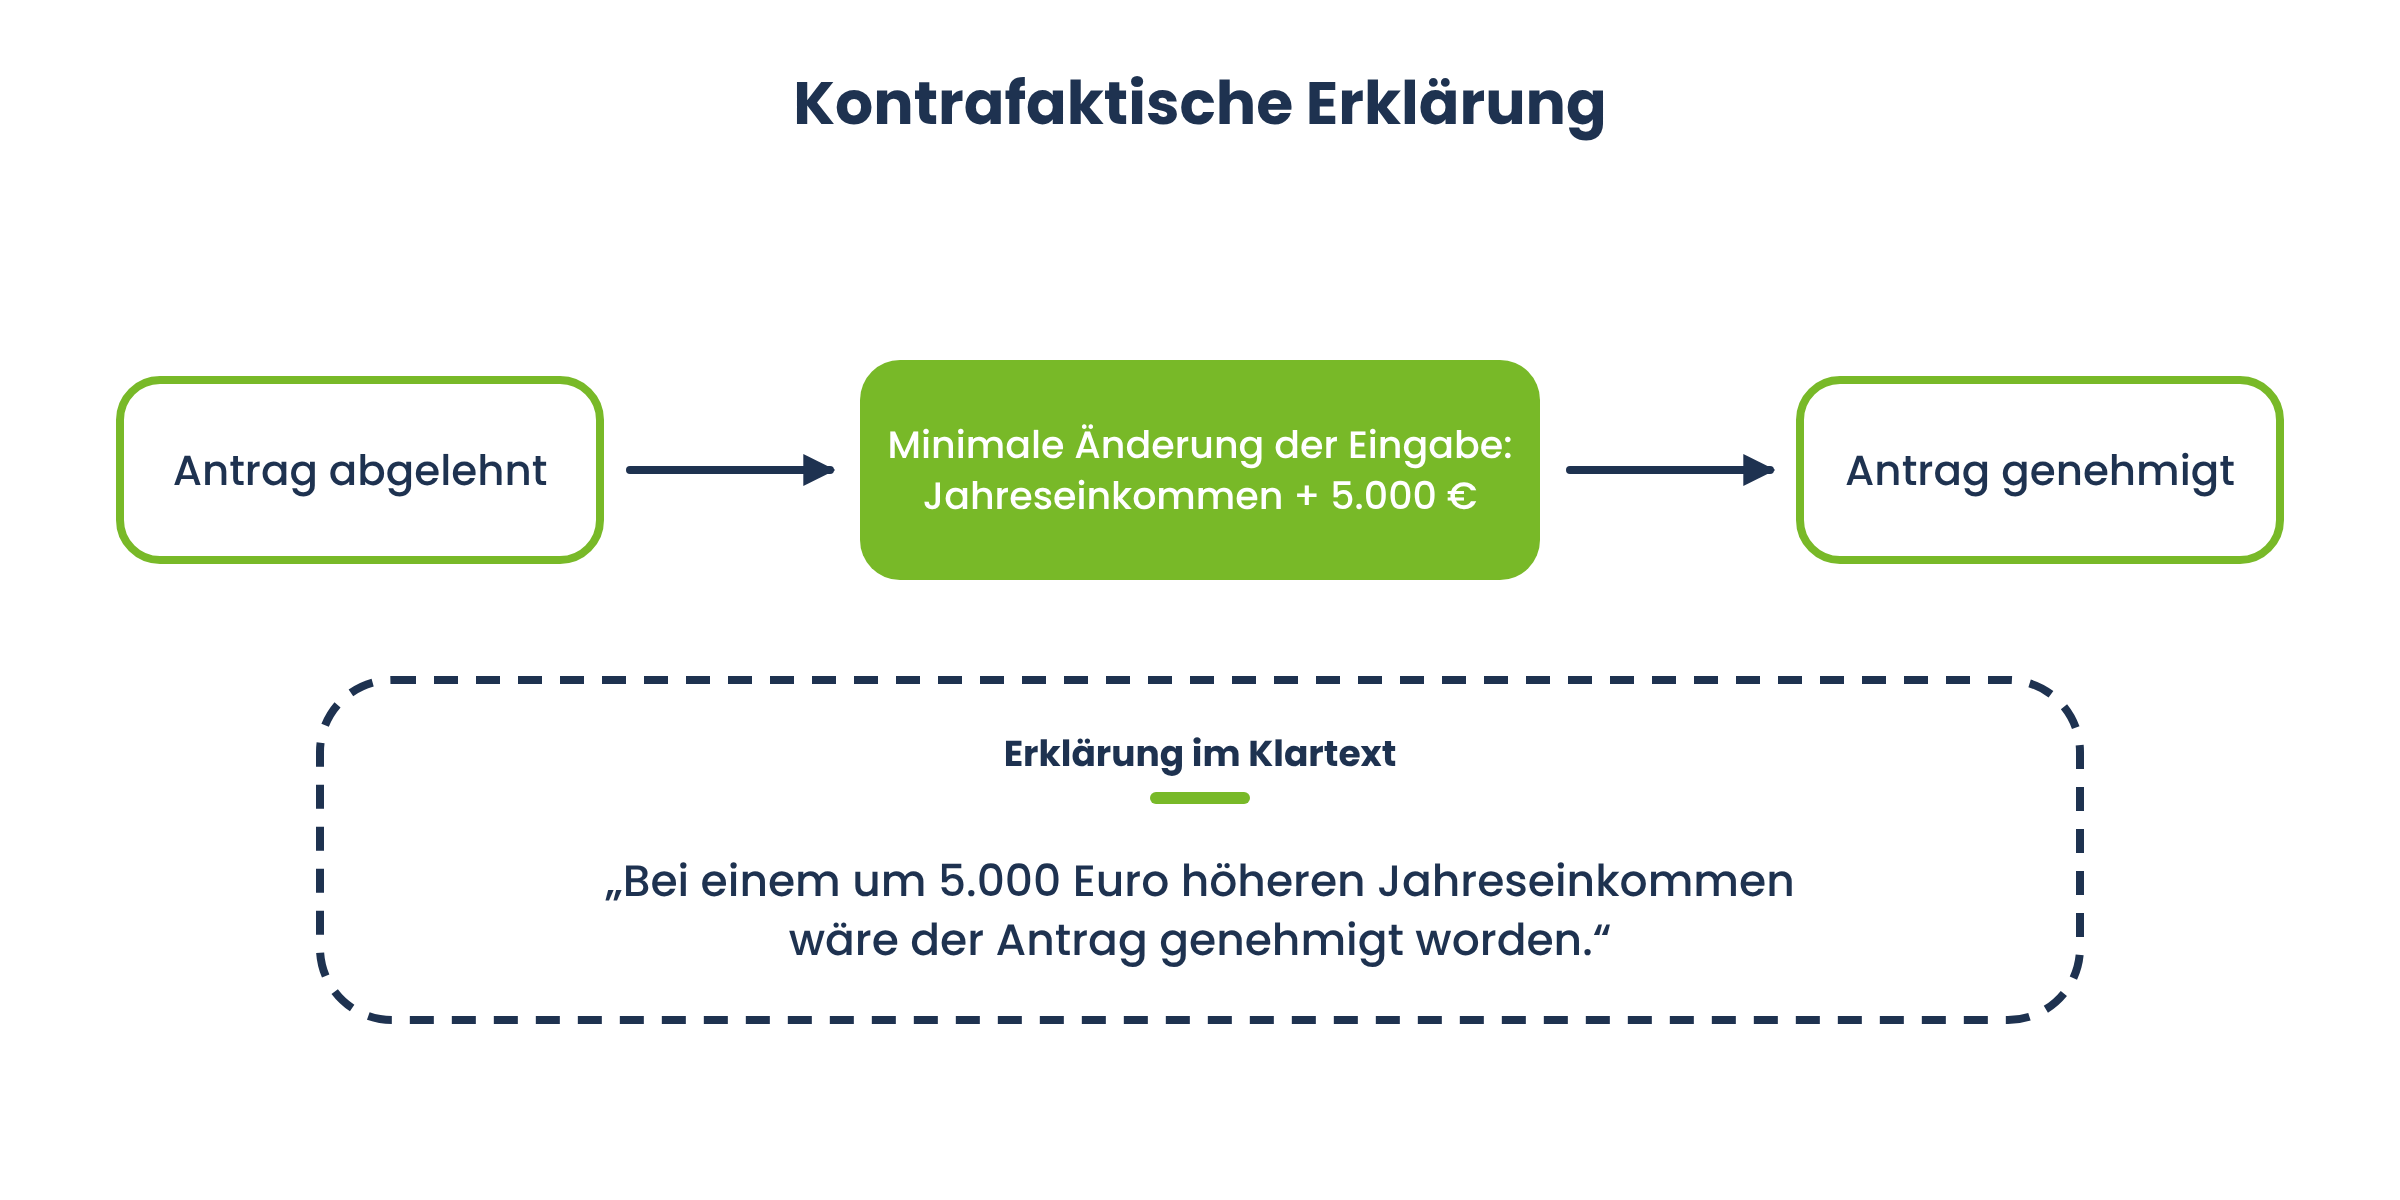
Kontrafaktische Erklärungen, im Englischen Counterfactual Explanations, verfolgen einen anderen Ansatz als SHAP oder LIME: Statt zu zeigen, wie stark einzelne Merkmale zu einer Vorhersage beigetragen haben, beantworten sie die Frage, welche minimale Änderung der Eingabedaten zu einem anderen Ergebnis geführt hätte.
Ein Beispiel macht das Prinzip greifbar: Wurde ein Kreditantrag abgelehnt, liefert eine kontrafaktische Erklärung eine Aussage wie „Bei einem um 5.000 Euro höheren Jahreseinkommen wäre der Antrag genehmigt worden.“ Diese Form der Erklärung ist besonders wertvoll, weil sie nicht nur nachvollziehbar, sondern im Idealfall auch handlungsleitend ist: Die antragstellende Person erfährt konkret, welche Stellschraube sie verändern müsste, um ein anderes Ergebnis zu erzielen.
Technisch gesehen suchen Algorithmen für kontrafaktische Erklärungen nach dem nächstgelegenen Datenpunkt, der vom Modell anders klassifiziert würde als der ursprüngliche. Dabei wird typischerweise versucht, möglichst wenige und möglichst realistische Merkmale zu verändern, damit die Erklärung praktisch umsetzbar bleibt. Eine wichtige Einschränkung: Kontrafaktische Erklärungen zeigen zwar, welche Änderung der Eingabe das Ergebnis verändern würde, nicht aber, warum das Modell so reagiert und welche Vorgänge in seinem Inneren dahinterstehen. Dieser Frage geht Causal Tracing nach, das im nächsten Abschnitt vorgestellt wird.
Praktische Relevanz gewinnen kontrafaktische Erklärungen auch juristisch: Die DSGVO-Erwägungsgründe legen nahe, dass Betroffene ein Recht auf eine nachvollziehbare Erklärung automatisierter Entscheidungen haben. Kontrafaktische Erklärungen bieten eine praxistaugliche Antwort, weil sie ohne technisches Vorwissen verständlich sind.
Wie funktioniert Layer-wise Relevance Propagation (LRP)?
Layer-wise Relevance Propagation, kurz LRP, wurde 2015 von Sebastian Bach und Team entwickelt und zählt zu den etabliertesten Methoden zur Erklärung neuronaler Netze. Ursprünglich vor allem für die Bildklassifikation entwickelt, wird sie inzwischen auch bei anderen Datentypen wie Text eingesetzt (Bach et al., 2015).
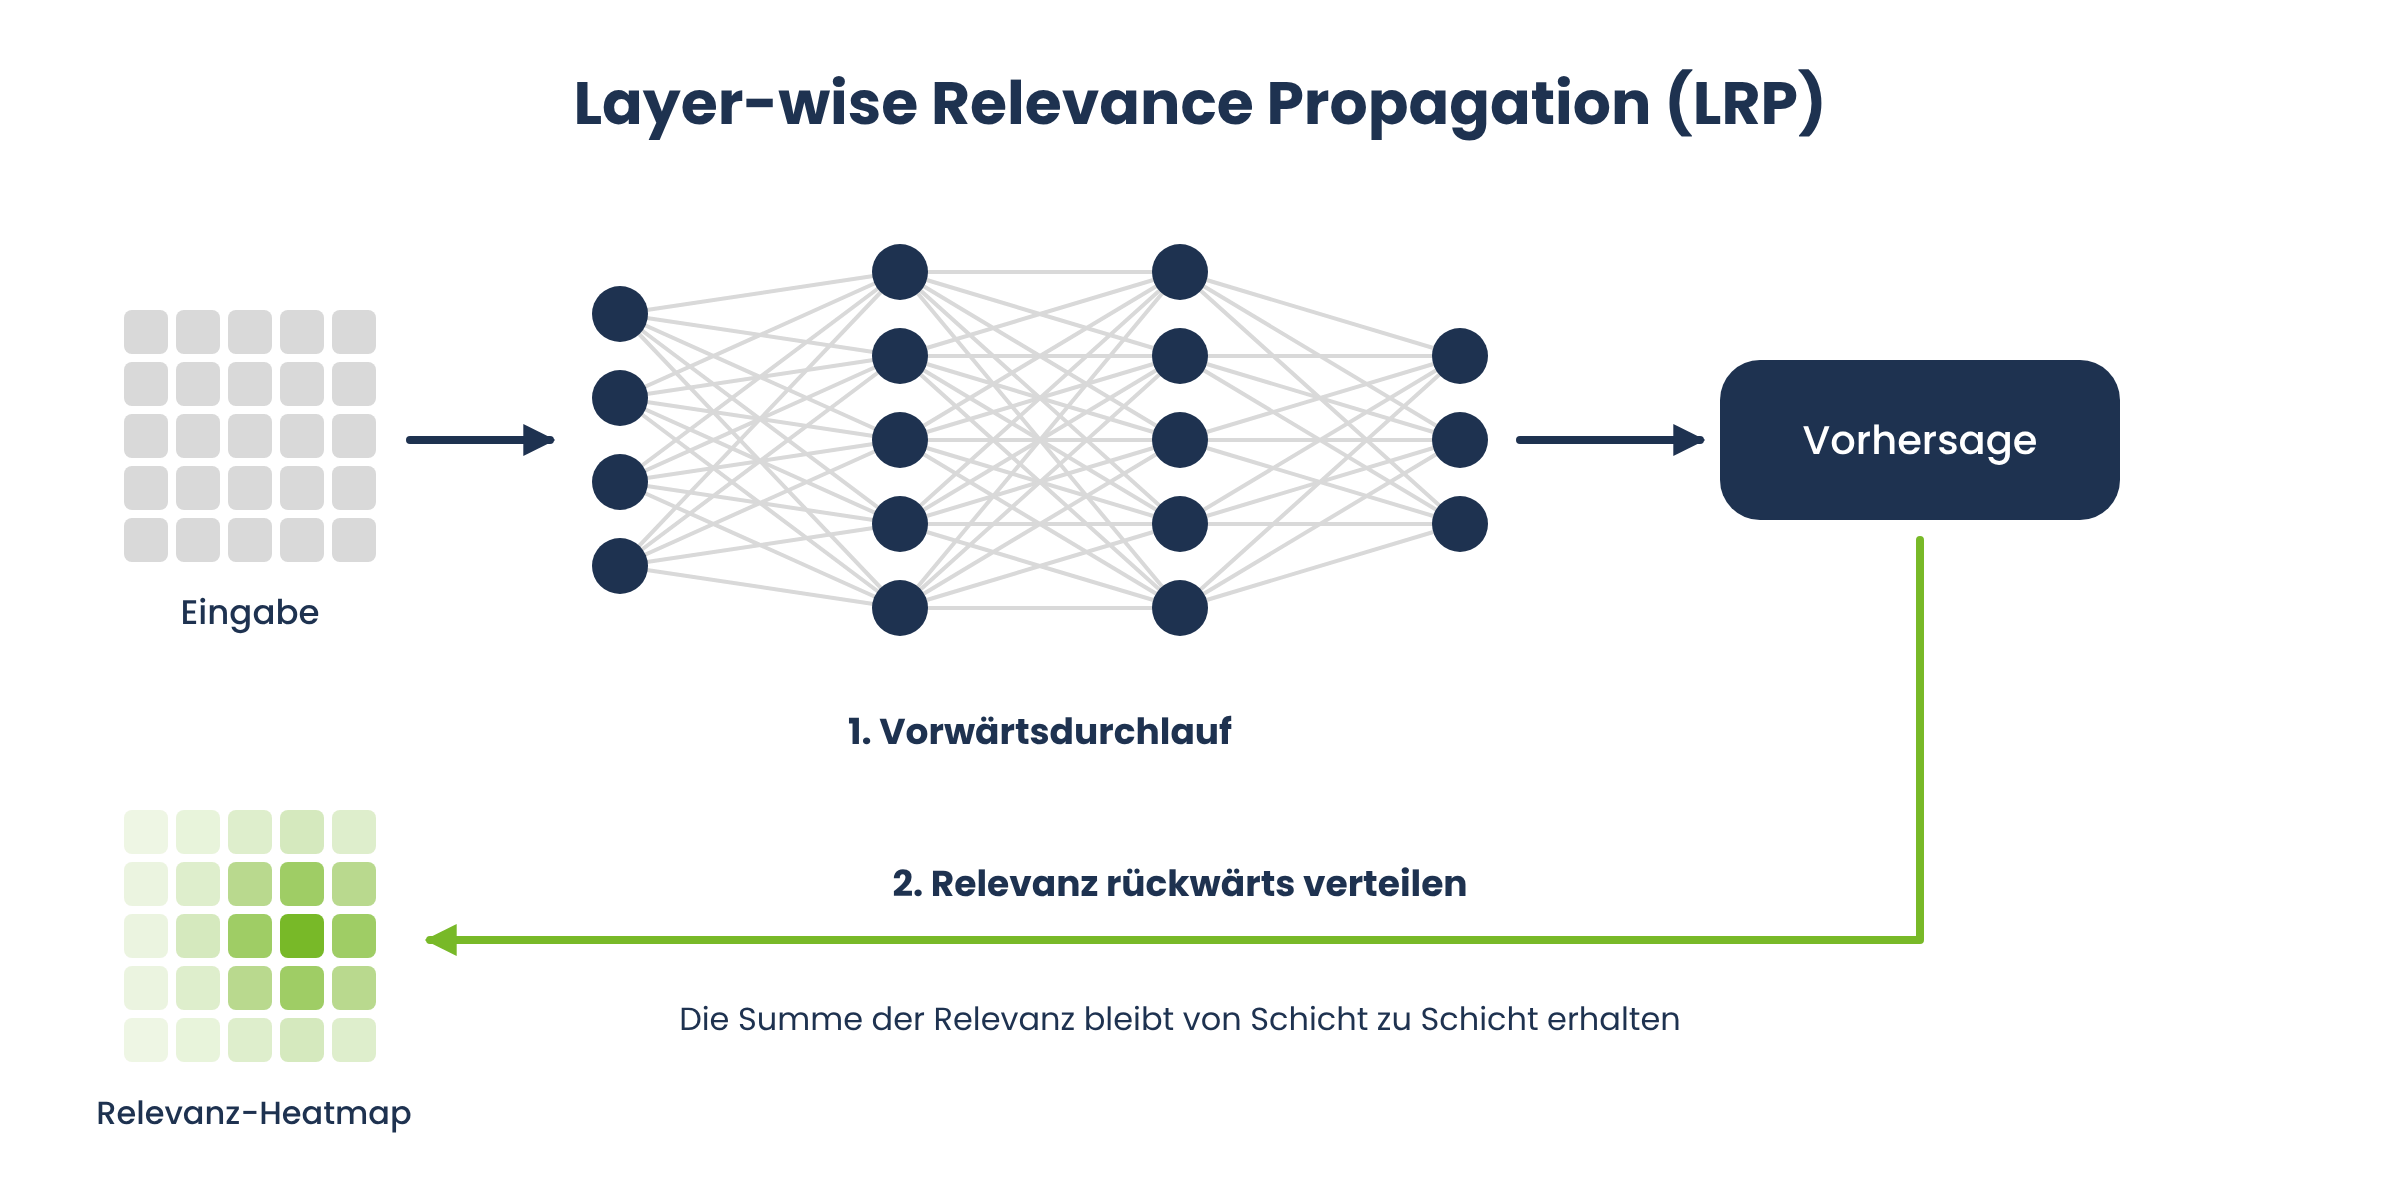
Das Grundprinzip von LRP unterscheidet sich deutlich vonmodellagnostischen Verfahren wie LIME und Kernel SHAP: Statt das Modell von außen zu betrachten und durch Störungen der Eingabedaten Rückschlüsse zu ziehen, nutzt LRP die interne Struktur des neuronalen Netzes selbst. Nach einem normalen Vorwärtsdurchlauf, bei dem das Netz seine Vorhersage berechnet, wird der Ausgabewert schichtweise rückwärts durch das Netz „zurückverteilt“. Dabei erhält jeder Knoten einen Relevanzwert, der angibt, wie stark es zu diesem Ausgabewert beigetragen hat. Diese Relevanz wird nach festen Regeln von Schicht zu Schicht weitergereicht, bis am Ende jedem einzelnen Eingabepixel beziehungsweise jedem einzelnen Eingabemerkmal ein Relevanzwert zugeordnet ist.
Ein zentrales Prinzip von LRP ist die sogenannte Relevanzerhaltung: Die Summe der Relevanzwerte bleibt von Schicht zu Schicht im Wesentlichen gleich und entspricht dem ursprünglichen Ausgabewert. Das Ergebnis lässt sich bei Bildklassifikatoren besonders anschaulich visualisieren – als Heatmap, die zeigt, welche Bildbereiche am stärksten für oder gegen die Entscheidung des Modells gesprochen haben. Bei der medizinischen Bildanalyse etwa kann eine solche Heatmap zeigen, welche Regionen eines MRT-Scans die Einschätzung des Modells maßgeblich beeinflusst haben, was Ärztinnen und Ärzten eine unmittelbare Plausibilitätsprüfung ermöglicht.
Im Vergleich zu einfachen gradientenbasierten Verfahren gilt LRP als weniger anfällig für verrauschte Erklärungen und Sättigungseffekte: Gradienten messen, wie stark der Ausgabewert auf kleine Änderungen der Eingabe reagiert, während LRP den Ausgabewert selbst auf die Eingabemerkmale verteilt. Wie gut das in der Praxis gelingt, hängt allerdings von der gewählten Propagationsregel ab. Der Nachteil: LRP setzt Zugriff auf die interne Architektur und die Gewichte des Modells voraus und lässt sich, anders als LIME oder Kernel SHAP, nicht modellagnostisch einsetzen.
Was ist Causal Tracing – und wie hilft es, KI-Modelle zu verstehen?
Während SHAP, LIME und LRP in erster Linie zeigen, welche Eingabemerkmale wie stark zu einer Vorhersage beitragen, verfolgt Causal Tracing einen anderen Anspruch: Durch gezielte Eingriffe in ein Modell soll es klären, welche internen Komponenten ursächlich für ein bestimmtes Modellverhalten sind, und nicht nur, welche Merkmale mit der Vorhersage zusammenhängen.
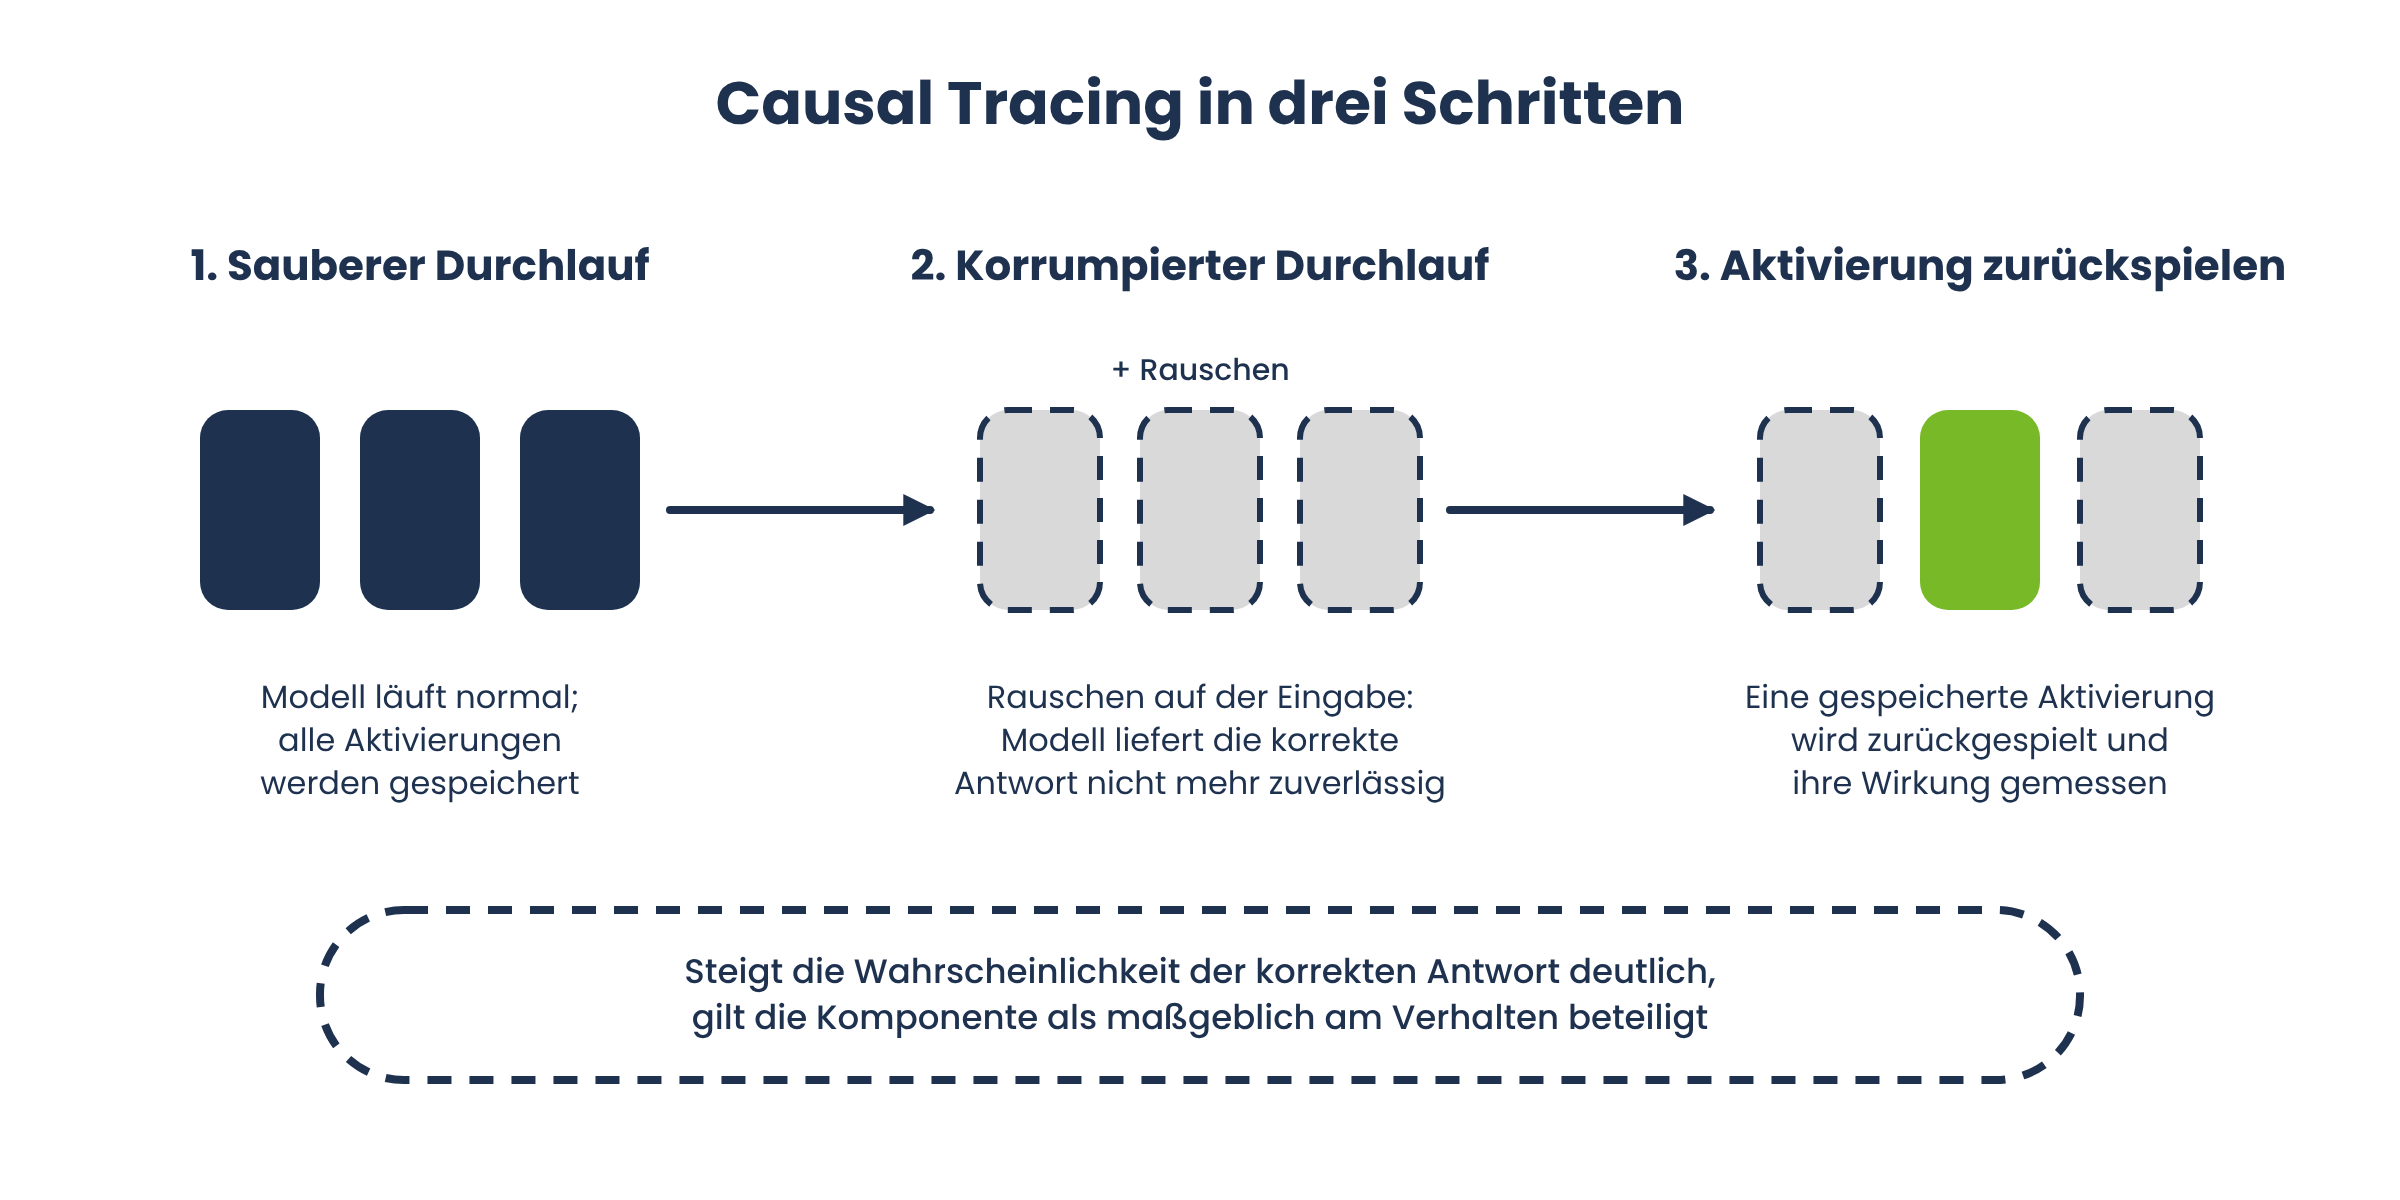
Bekannt wurde diese Methode vor allem durch die Forschungsarbeit von Kevin Meng und Team zur Untersuchung von Sprachmodellen (Meng et al., 2022). Das Verfahren funktioniert in drei Schritten: Zunächst wird ein „sauberer“ Durchlauf mit dem Modell durchgeführt, bei dem alle internen Aktivierungen gespeichert werden. Anschließend wird ein „korrumpierter“ Durchlauf gestartet, bei dem gezielt Rauschen auf die Eingaben addiert wird, sodass das Modell die korrekte Antwort nicht mehr zuverlässig vorhersagt. Im dritten Schritt wird jeweils eine einzelne gespeicherte Aktivierungen aus dem sauberen in den korrumpierten Durchlauf zurückgespielt. Steigt dadurch die Wahrscheinlichkeit der korrekten Vorhersage deutlich, gilt diese Komponente als maßgeblich am untersuchten Verhalten beteiligt.
Auf diese Weise lässt sich beispielsweise zeigen, welche Komponenten eines Sprachmodells beim Abruf von Faktenwissen maßgeblich beteiligt sind. Diese Erkenntnisse sind nicht nur akademisch interessant: Auf ihnen bauen Verfahren zur gezielten Modellkorrektur auf, mit denen sich veraltete oder fehlerhafte Fakten in den Gewichten anpassen lassen, ohne das gesamte Modell neu zu trainieren. Allerdings befinden sich diese Verfahren noch in der Forschung. So ist unklar, wie zuverlässig sich solche Änderungen auf verwandte Fakten auswirken und ob sie andere Modellfähigkeiten beeinträchtigen.
Für Unternehmen, die zunehmend Sprachmodelle in ihre Prozesse integrieren, ist Causal Tracing ein interessanter Ansatz. Es macht sichtbar, welche internen Komponenten eines Modells an einem bestimmten Verhalten beteiligt sind, und geht damit über die Bewertung einzelner Eingabemerkmale hinaus. Einsetzen lässt es sich nur bei Modellen, auf deren interne Aktivierungen man zugreifen kann, also nicht bei Modellen, die nur über eine API genutzt werden. Causal Tracing gehört zur sogenannten mechanistischen Interpretierbarkeit. Dieses Forschungsfeld steht noch am Anfang ihrer praktischen Anwendung, gilt vielen Forschenden aber als vielversprechender Weg, das Innenleben komplexer Modelle besser zu verstehen.
Symbolische Regression: Formeln statt Black Box
Ein grundlegend anderer Weg zu Explainable AI führt nicht über nachträgliche Erklärungsmethoden, sondern über von vornherein interpretierbare Modelle. Ein Beispiel dafür ist die symbolische Regression.
Anders als viele klassische Modelle des maschinellen Lernens, die die Parameter einer vorgegebenen Modellstruktur optimiert, sucht die symbolische Regression selbst nach einer mathematischen Gleichung, die einen Datensatz gut beschreibt und dabei möglichst einfach bleibt. Das Ergebnis ist keine Vielzahl von Gewichten in einem neuronalen Netz, sondern im besten Fall eine kompakte, für Fachleute lesbare Formel – etwa ein Zusammenhang der Form „Ausfallrisiko steigt proportional zum Verschuldungsgrad und sinkt mit der Dauer der Kundenbeziehung“.
Der große Vorteil liegt auf der Hand: Eine kompakte Gleichung lässt sich im besten Fall ohne zusätzliche Erklärungsmethode direkt lesen und nachvollziehen. In wissenschaftlichen Disziplinen wird symbolische Regression schon lange eingesetzt, um aus Messdaten physikalische Zusammenhänge abzuleiten, die Fachleute anschließend prüfen. Der Nachteil: Bei sehr komplexen, hochdimensionalen Problemen liefert symbolische Regression oft nicht dieselbe Vorhersagegenauigkeit wie komplexere Black-Box-Modelle, weil sich die Zusammenhänge nicht immer in einer kompakten Formel abbilden lassen. Hinzu kommt, dass die Suche nach geeigneten Formeln rechenaufwendig ist und bei vielen Eingabemerkmalen schnell an Grenzen stößt.
Für Unternehmen bedeutet das: Ob symbolische Regression infrage kommt, hängt zuerst von Daten und Aufgabe ab. Sie eignet sich bei überschaubaren, numerischen Datensätzen, bei denen sich der Zusammenhang plausibel als Formel darstellen lässt, etwa bei regulatorisch sensiblen Anwendungen oder in Forschung und Entwicklung. Ist zusätzlich Nachvollziehbarkeit gefordert, etwa bei regulierten Anwendungen, kann sie dort eine Option neben anderen interpretierbaren Modellen wie linearen Regressionen oder kleinen Entscheidungsbäumen sein.
Welche gesetzlichen Anforderungen gibt es an erklärbare KI?
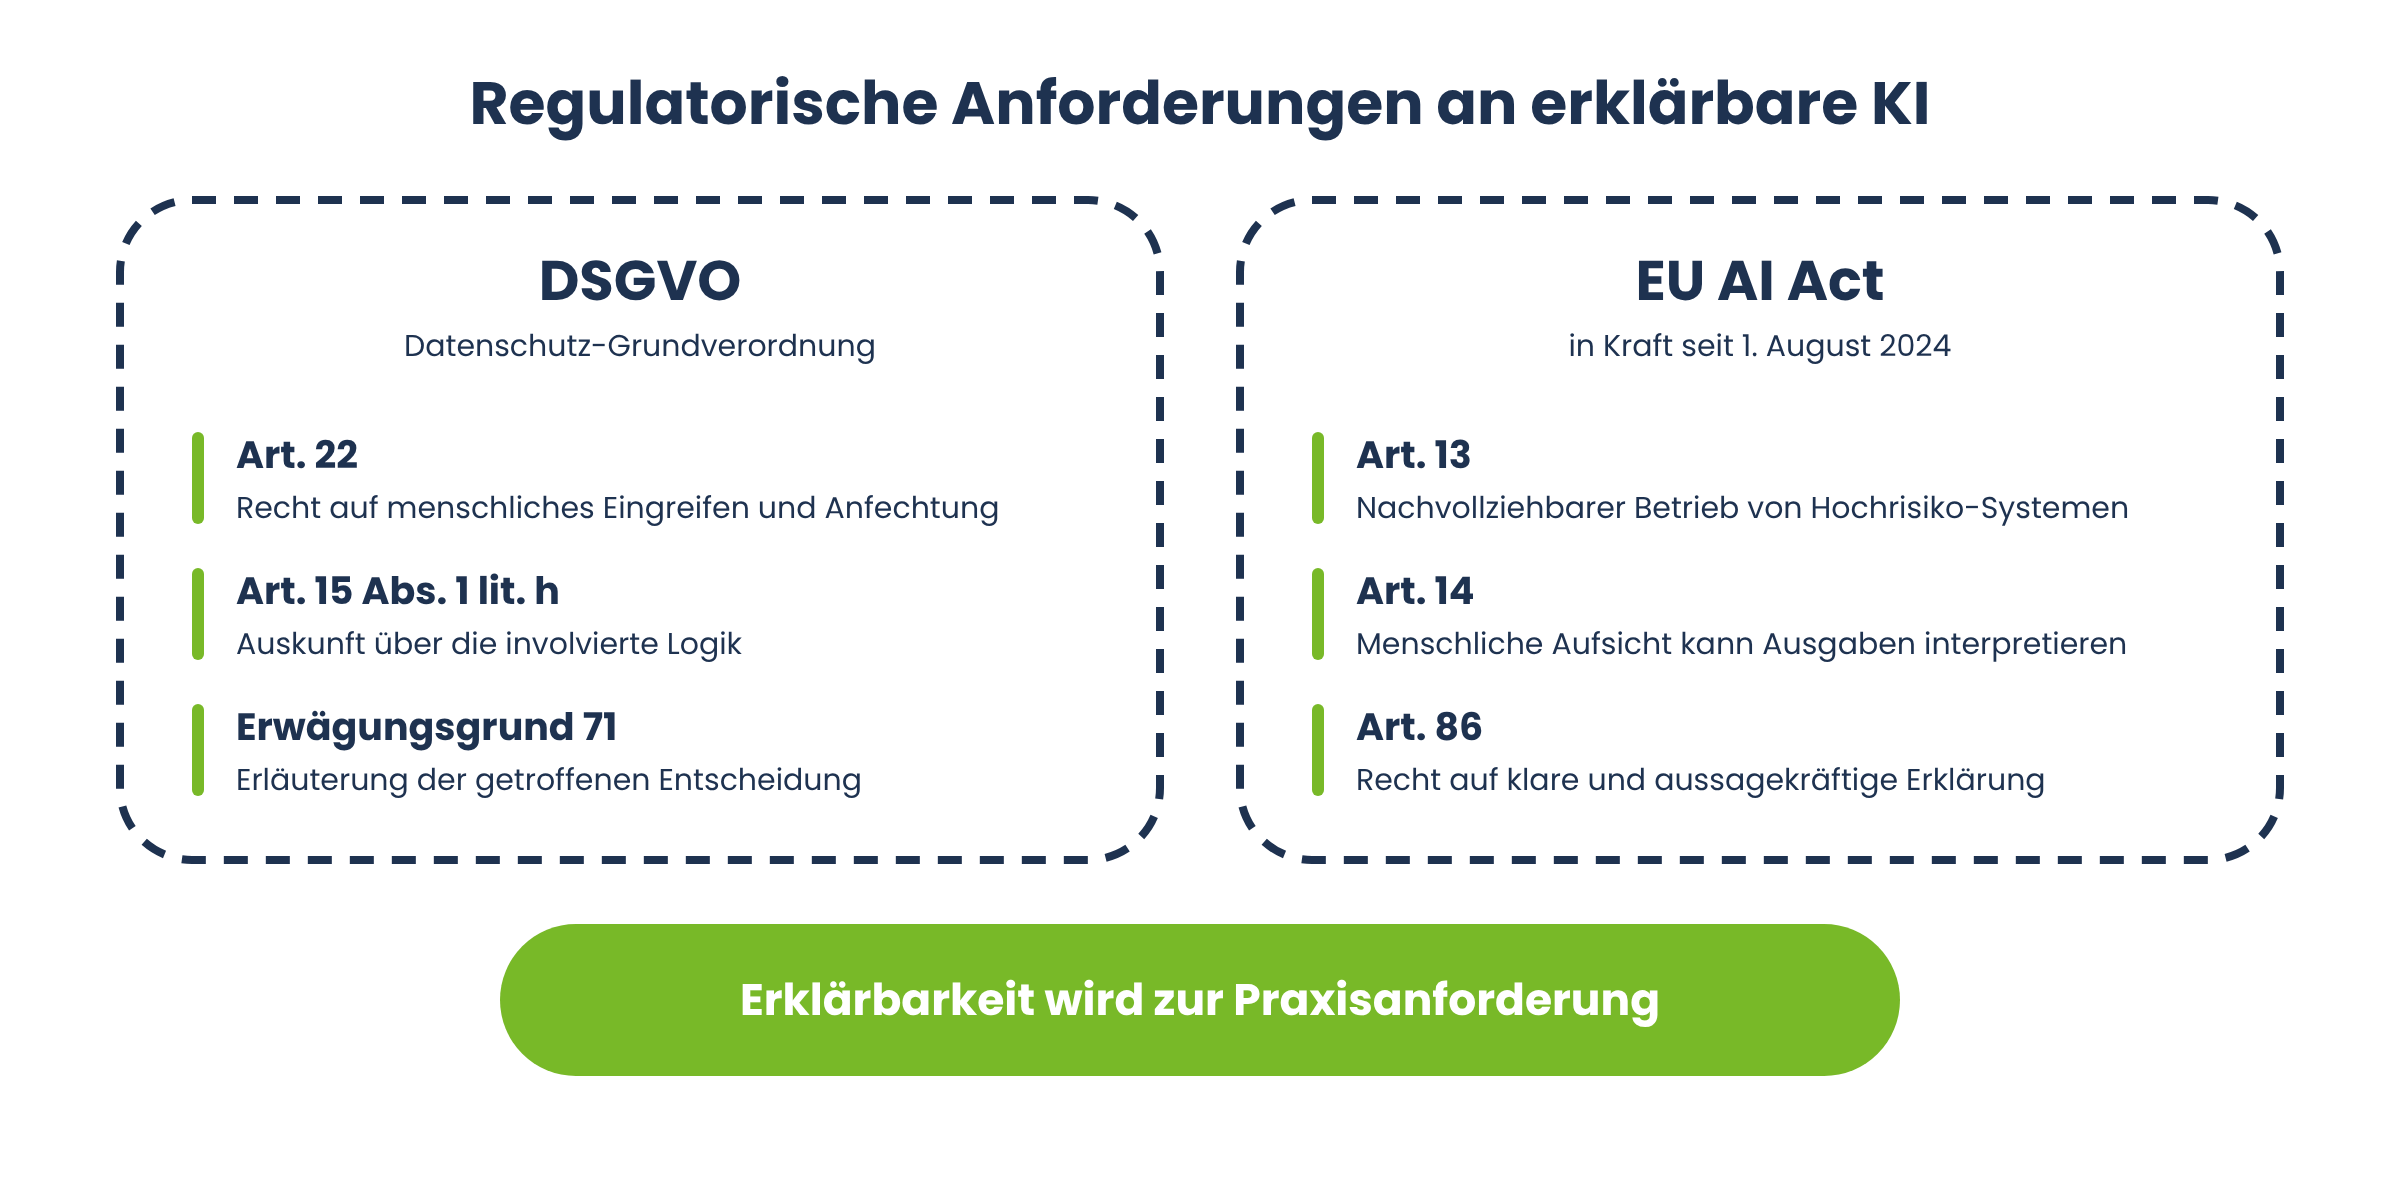
Explainable AI ist längst nicht mehr nur eine technische Best Practice, sondern in der Europäischen Union zunehmend gesetzlich verankert. Zwei Regelwerke sind dabei besonders relevant: die DSGVO und der EU AI Act.
Die DSGVO und das Recht auf Erklärung
Artikel 22 der Datenschutz-Grundverordnung regelt automatisierte Einzelentscheidungen, einschließlich Profiling. Grundsätzlich haben betroffene Personen das Recht, nicht ausschließlich einer automatisierten Verarbeitung unterworfen zu werden. Das gilt, wenn diese rechtliche Wirkung entfaltet oder sie in ähnlicher Weise erheblich beeinträchtigt (DSGVO, Art. 22). Wo automatisierte Entscheidungen dennoch zulässig sind, etwa auf Grundlage einer ausdrücklichen Einwilligung, sieht Artikel 22 Absatz 3 vor, dass Unternehmen geeignete Maßnahmen ergreifen müssen, um die Rechte der betroffenen Person zu schützen – darunter mindestens das Recht auf menschliches Eingreifen, auf Darlegung des eigenen Standpunkts und auf Anfechtung der Entscheidung.
Ob die DSGVO damit ein explizites „Recht auf Erklärung“ begründet, wird in der juristischen Fachliteratur unterschiedlich beurteilt. Ein ausdrücklicher Begriff dieser Art taucht im verbindlichen Gesetzestext nicht auf, wohl aber in Erwägungsgrund 71, der nahelegt, dass betroffene Personen eine Erläuterung der getroffenen Entscheidung erhalten sollen. Ein weiterer Anknüpfungspunkt ist das Auskunftsrecht, das aussagekräftige Informationen über die involvierte Logik umfasst (Art. 15 Abs. 1 lit. h). In der Praxis führt diese Kombination aus Auskunftsrechten, Widerspruchsrechten und dem Anspruch auf menschliches Eingreifen dazu, dass Unternehmen faktisch erklärbare KI-Systeme benötigen, um DSGVO-konform zu handeln.
Der EU AI Act und seine Transparenzpflichten
Deutlich konkreter wird der EU AI Act, der am 1. August 2024 in Kraft getreten ist und dessen Pflichten seither schrittweise gelten. Für sogenannte Hochrisiko-KI-Systeme, etwa im Bereich der Kreditwürdigkeitsprüfung, Personalauswahl oder kritischen Infrastruktur, schreibt Artikel 13 Transparenz vor. Diese Systeme müssen so gestaltet sein, dass ihr Betrieb ausreichend nachvollziehbar ist. Betreiber sollen die Ausgaben des Systems damit angemessen interpretieren und nutzen können (EU AI Act, Schlüsselthema Transparenzpflichten).
Konkret verlangt der EU AI Act unter anderem verständliche Betriebsanleitungen, in denen Fähigkeiten und Grenzen des Systems dokumentiert sind, sowie Mechanismen, die eine wirksame menschliche Aufsicht ermöglichen. Artikel 14 legt zudem fest, dass Personen, die ein Hochrisiko-System beaufsichtigen, dessen Ausgaben korrekt interpretieren können sollen. Diese Anforderung lässt sich ohne geeignete Explainable-AI-Werkzeuge in der Praxis kaum erfüllen. Ergänzend gewährt Artikel 86 betroffenen Personen künftig das Recht auf eine klare und aussagekräftige Erklärung, wenn eine Entscheidung eines Hochrisiko-KI-Systems erhebliche Auswirkungen auf ihr Leben hat. Diese Regelung tritt zwar erst später vollständig in Kraft, zeigt aber die Richtung, in die sich die europäische KI-Regulierung entwickelt: hin zu einem expliziten Erklärungsanspruch.
Für Unternehmen ergibt sich daraus eine klare Handlungsempfehlung: Wer heute KI-Systeme für risikobehaftete Anwendungsfälle entwickelt oder einsetzt, sollte nicht erst kurz vor Inkrafttreten weiterer Pflichten Explainable-AI-Methoden nachrüsten. Besser ist es, Erklärbarkeit von Beginn an einzuplanen, bei der Modellwahl ebenso wie in der Systemarchitektur.
Wie hilft XAI dabei, Verzerrungen (Bias) in KI-Modellen zu erkennen?
Verzerrungen, im Englischen Bias, entstehen häufig unbemerkt. Ein Grund ist, dass Trainingsdaten immer aus der Vergangenheit stammen und damit historische Ungleichheiten widerspiegeln. Wenn Frauen etwa seltener Führungspositionen besetzt oder Kredite erhalten haben, kann ein Modell dieses Muster als vermeintlich gültige Regel lernen. Hinzu kommt, dass viele Datensätze überwiegend aus westlichen Ländern stammen, sodass andere Bevölkerungsgruppen und Regionen unterrepräsentiert sind. Ein Modell, das auf solchen Daten trainiert wurde, kann diese Verzerrungen übernehmen und systematisch verstärken, ohne dass dies an der reinen Trefferquote erkennbar wäre.
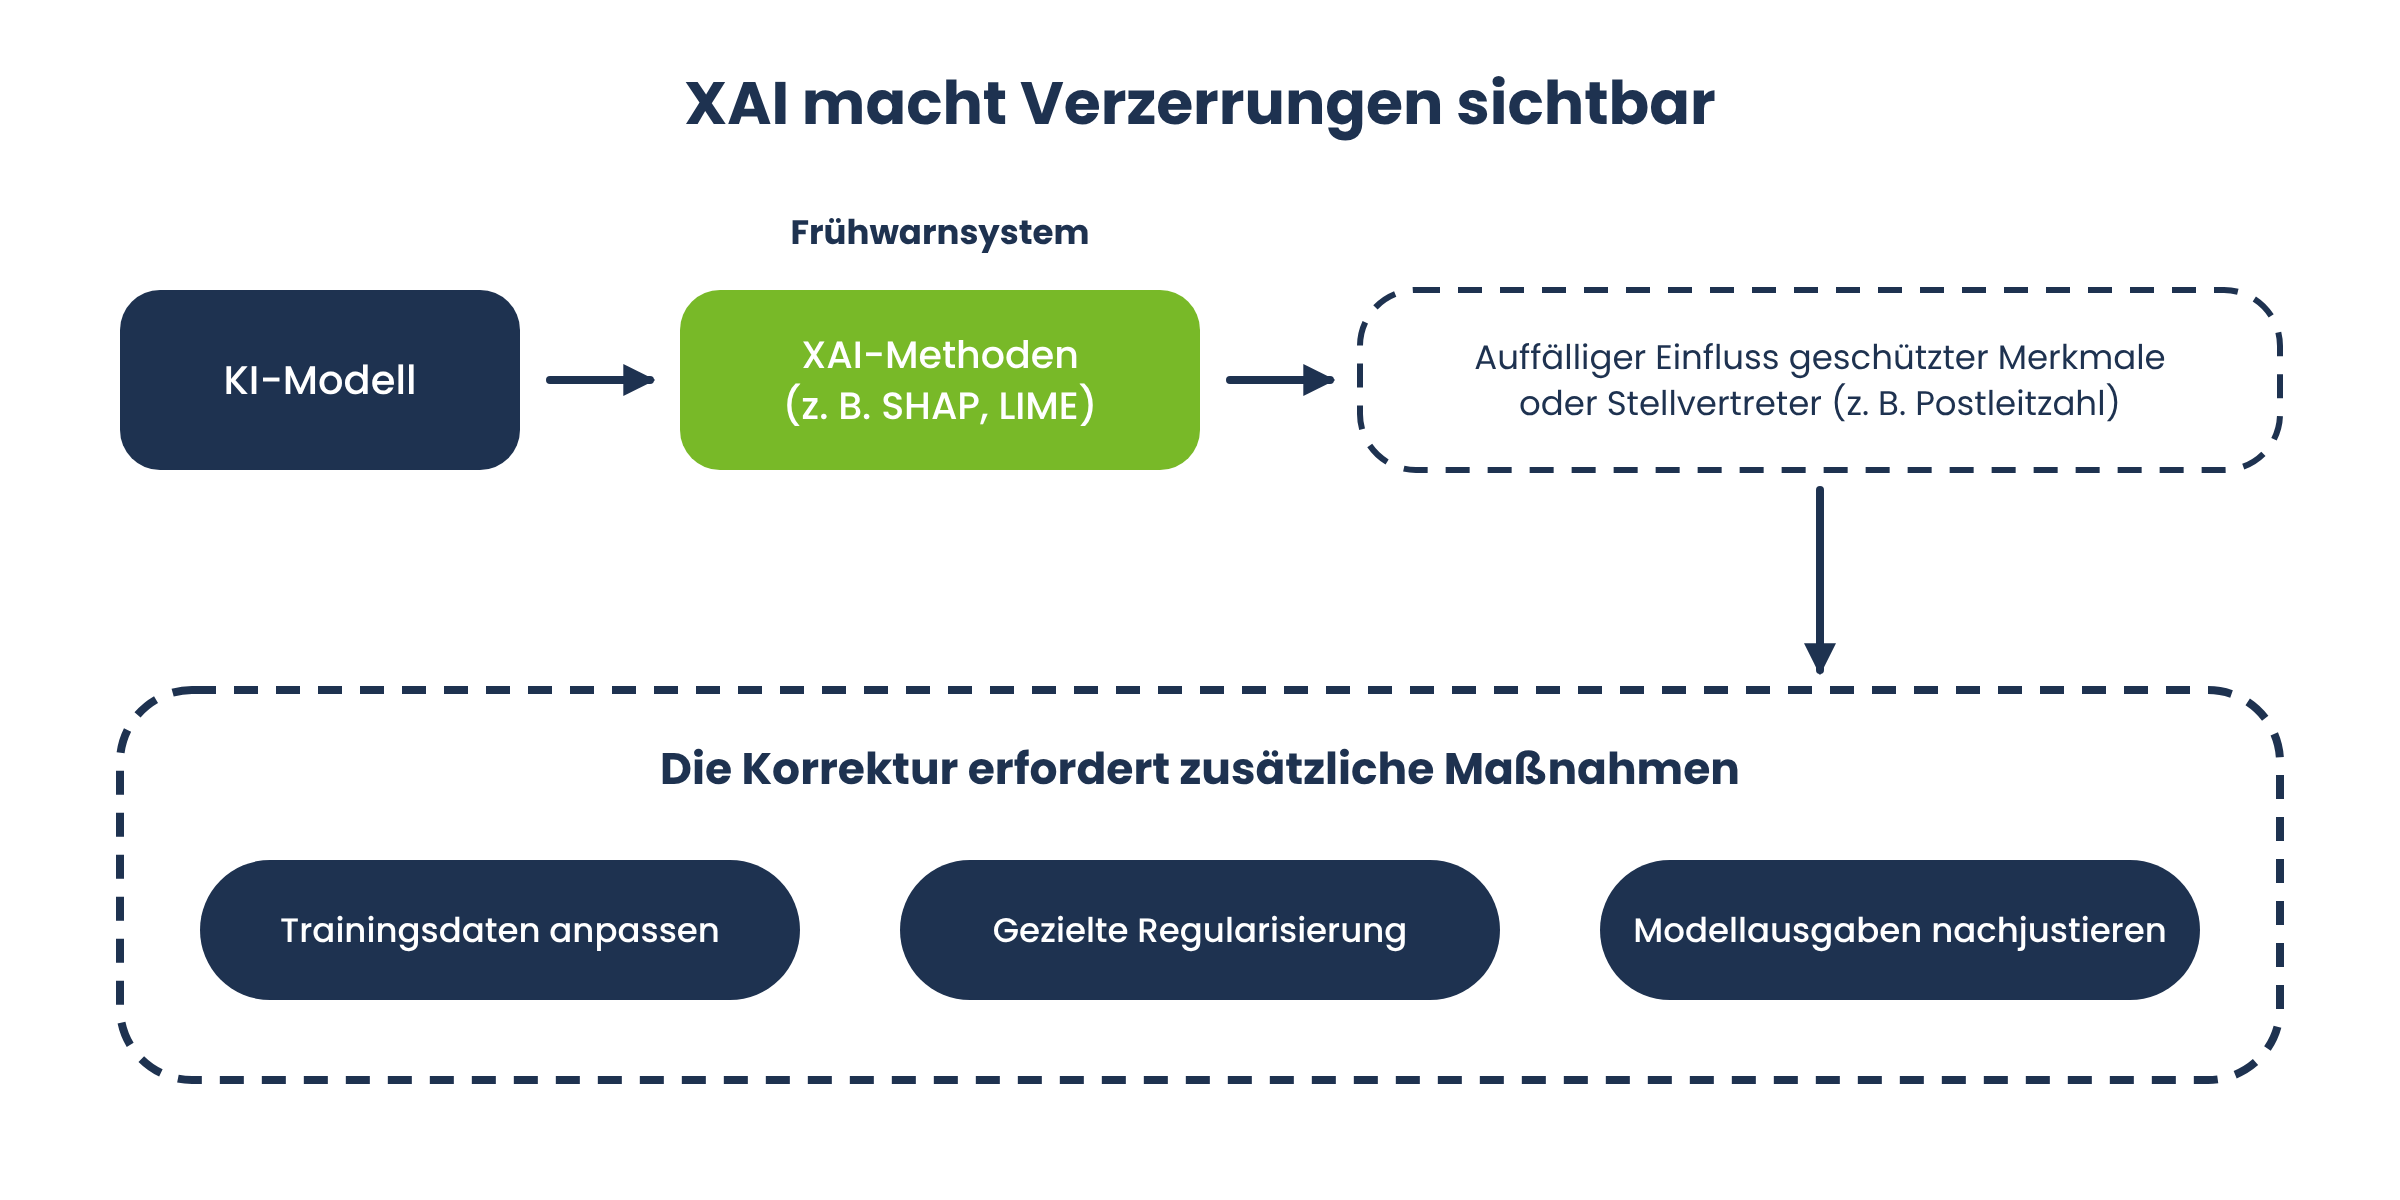
Explainable AI spielt bei der Aufdeckung solcher Verzerrungen eine zentrale Rolle. Indem Methoden wie SHAP oder LIME offenlegen, welche Merkmale eine Vorhersage tatsächlich beeinflussen, lässt sich prüfen, ob geschützte Merkmale wie Geschlecht, Herkunft oder Alter – oder eng damit korrelierte Stellvertretermerkmale wie Postleitzahl oder Vorname – einen unangemessen hohen Einfluss auf Entscheidungen haben. Erklärungen fungieren damit als eine Art Frühwarnsystem, das Muster sichtbar macht, die in aggregierten Genauigkeitswerten verborgen bleiben.
In der Praxis kombinieren Unternehmen dazu häufig lokale Erklärungen einzelner Vorhersagen mit globalen Analysen über größere Datenmengen hinweg. So lässt sich nicht nur ein Einzelfall prüfen, sondern auch systematisch untersuchen, ob bestimmte Gruppen im Durchschnitt schlechter bewertet werden als andere. Wichtig ist dabei jedoch eine Einschränkung: Erklärbarkeit allein beseitigt keine Verzerrung. Sie macht sie sichtbar – die eigentliche Korrektur erfordert zusätzliche Maßnahmen wie eine Anpassung der Trainingsdaten, gezielte Regularisierung oder Nachjustierung der Modellausgaben. Lässt sich eine Verzerrung damit nicht ausreichend beheben, kann es sinnvoller sein, auf den Einsatz des Modells für diesen Anwendungsfall zu verzichten.
Welche Herausforderungen bringt Explainable AI mit sich?
So wertvoll Explainable AI ist, sie bringt auch eigene Herausforderungen mit sich, die Unternehmen bei der Einführung berücksichtigen sollten.
Der Kompromiss zwischen Genauigkeit und Transparenz
Wie bereits beim Thema Black-Box-Modelle beschrieben, stehen Genauigkeit und Interpretierbarkeit häufig in einem gewissen Spannungsverhältnis zueinander. Die leistungsfähigsten Modelle sind oft die am schwersten zu erklärenden, während besonders transparente Modelle mitunter bei komplexen Zusammenhängen an Grenzen stoßen. Unternehmen müssen deshalb bewusst abwägen, welches Maß an Erklärbarkeit für den jeweiligen Anwendungsfall notwendig ist – und welchen Preis an Genauigkeit oder Rechenaufwand sie dafür in Kauf nehmen.
Wenn Erklärungen selbst angreifbar werden: adversarielle Angriffe auf XAI
Eine weniger bekannte, aber wachsende Herausforderung betrifft die Robustheit von Erklärungsmethoden selbst. Forschungsarbeiten zeigen, dass sich Erklärungen gezielt manipulieren lassen, ohne dass sich die zugrunde liegende Modellvorhersage ändert. So lässt sich beispielsweise ein Bild minimal und für das menschliche Auge kaum wahrnehmbar verändern, sodass eine Erklärungsmethode plötzlich völlig andere, irreführende Bildregionen als entscheidend markiert (Übersichtsarbeit zu adversariellen Angriffen auf XAI). Werden Erklärungen gezielt eingesetzt, um tatsächlich vorhandene Verzerrungen eines Modells zu verschleiern, spricht man in der Fachliteratur von „Fairwashing".
Diese Erkenntnis relativiert ein verbreitetes Missverständnis: Eine Erklärung ist kein unumstößlicher Beweis für die Vertrauenswürdigkeit eines Modells, sondern selbst ein Werkzeug, das sorgfältig validiert werden muss. Unternehmen, die XAI-Methoden in Bereichen einsetzen, in denen mit gezielten Angriffen zu rechnen ist, sollten deshalb auch die Robustheit der Erklärungsmethoden selbst im Blick behalten, etwa im Bereich der Betrugserkennung oder der Cybersicherheit, wo Angreifende ein direktes Interesse daran haben können, Erklärungen gezielt zu manipulieren.
Erklärungen, die Endnutzerinnen und Endnutzer nicht verstehen
Eine dritte Herausforderung ist eher menschlicher als technischer Natur: Viele Erklärungsmethoden liefern Ergebnisse, die zwar mathematisch fundiert, für Laien aber wenig intuitiv sind. Eine Liste von SHAP-Werten oder eine Heatmap voller Farbverläufe hilft einem Data Scientist weiter, überfordert Endkundinnen und Endkunden aber eher, als dass sie sie aufklärt. Erklärbarkeit ist deshalb kein rein technisches Problem, sondern auch eine Frage der verständlichen Kommunikation. Wer XAI im Kundenkontakt einsetzt, sollte technische Erklärungen in eine für die jeweilige Zielgruppe passende Sprache übersetzen, etwa durch kontrafaktische Erklärungen im Klartext statt durch abstrakte Zahlenwerte.
Best Practices: Wie Unternehmen Explainable AI erfolgreich einführen
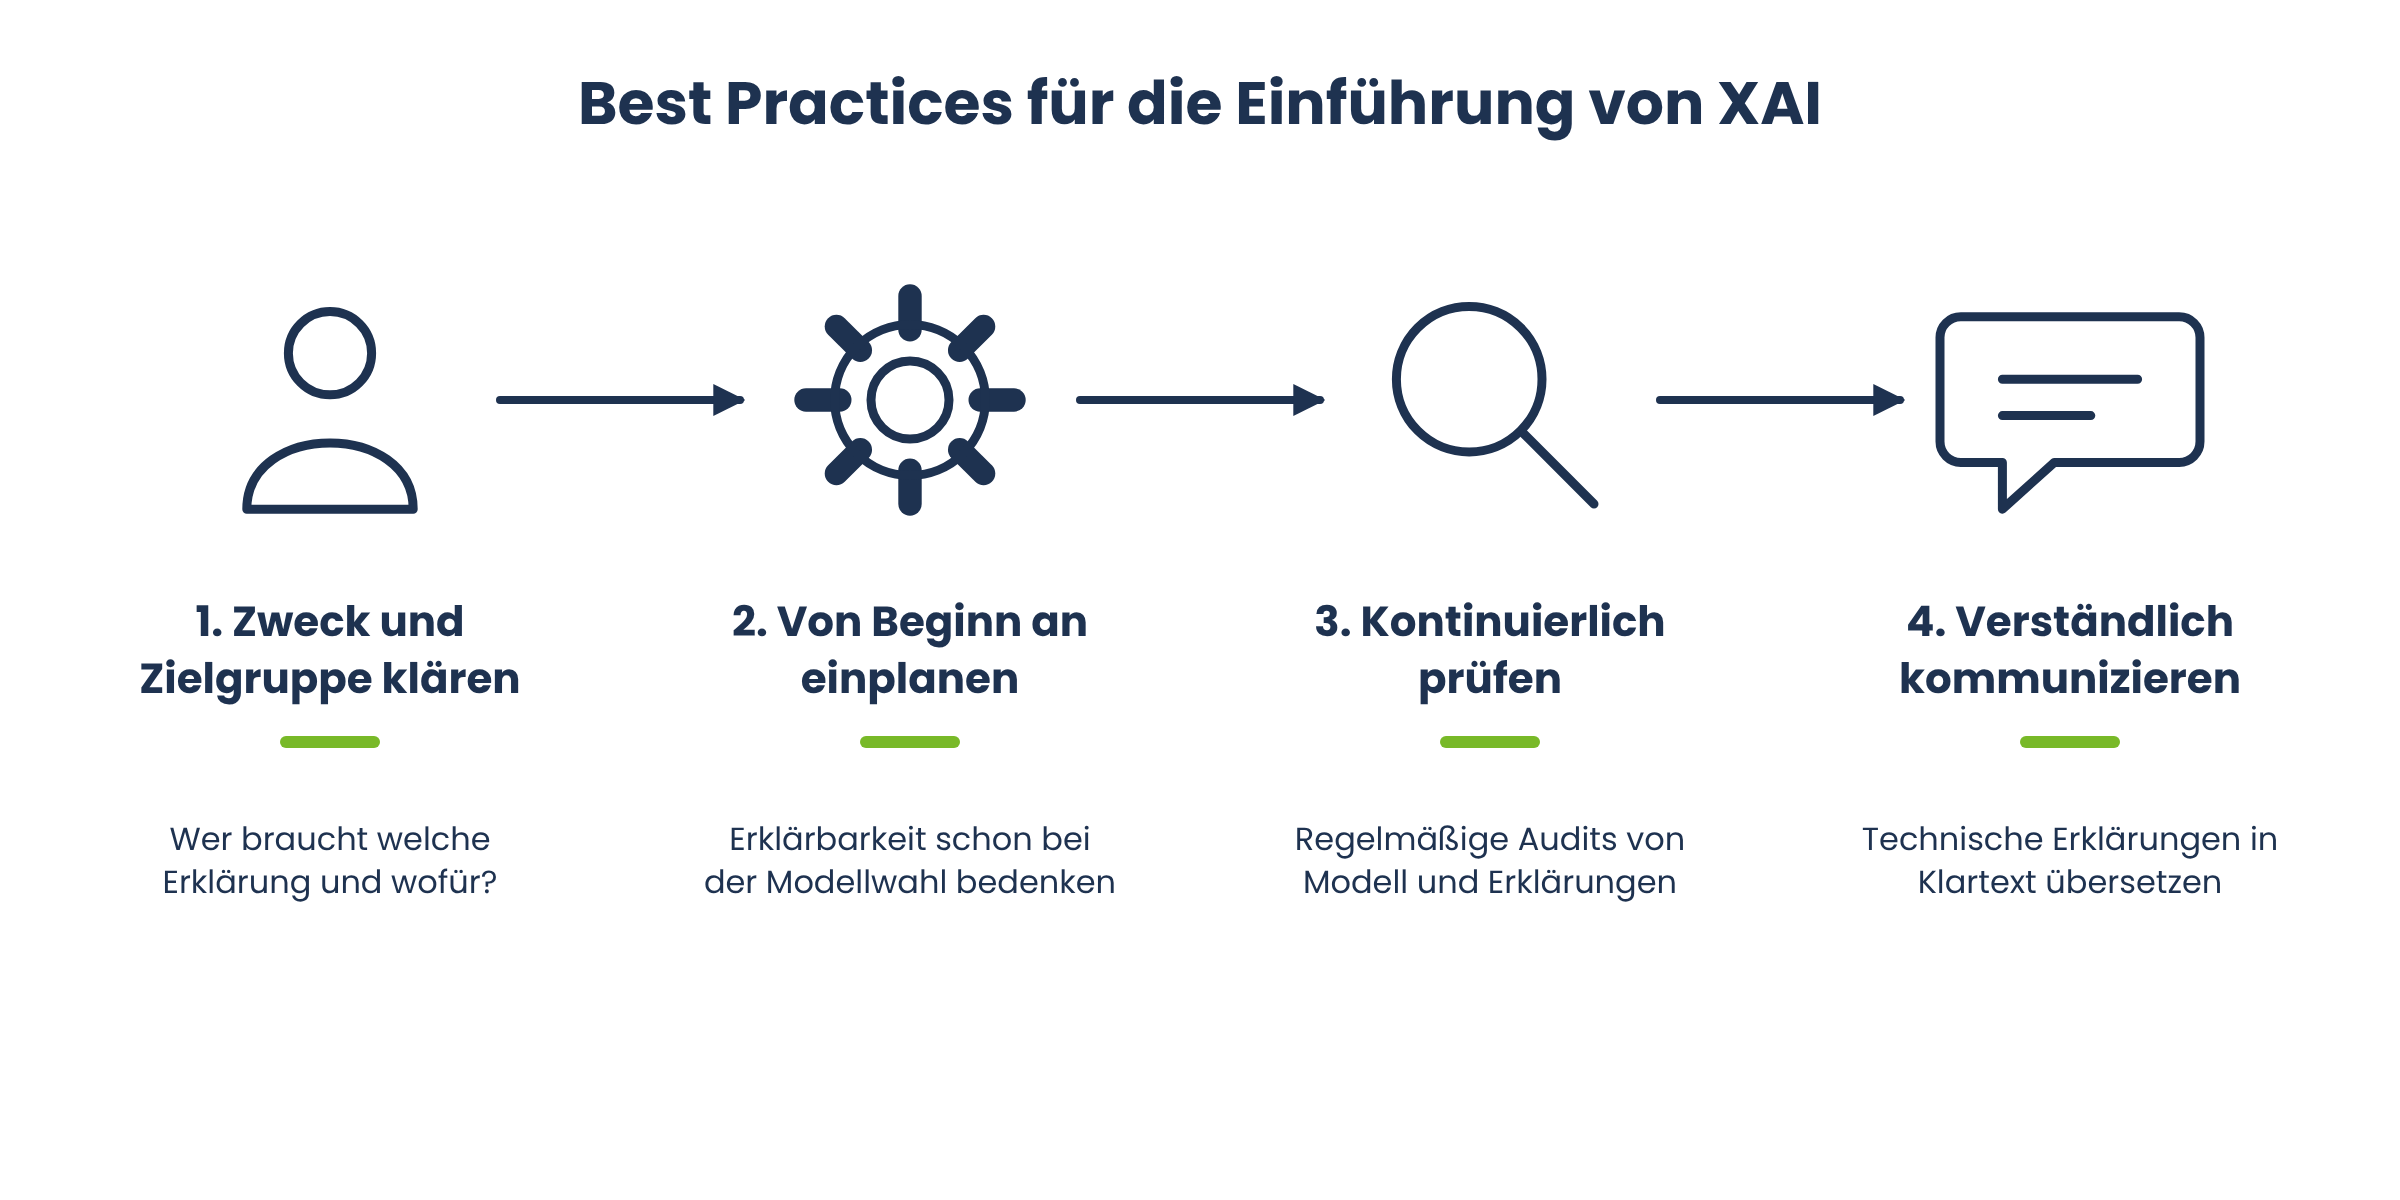
Die Einführung von Explainable AI gelingt selten als reines IT-Projekt. Stattdessen braucht es einen strukturierten Ansatz, der technische, organisatorische und kommunikative Aspekte gleichermaßen berücksichtigt.
Am Anfang steht die Frage nach dem Zweck: Wer soll eine Erklärung erhalten, und wofür wird sie benötigt? Ein Data Scientist, der die Ursachen von Fehlvorhersagen eines Modells untersucht, braucht andere Informationen als eine Kundin oder ein Kunde, der eine abgelehnte Kreditanfrage verstehen möchte, oder eine Aufsichtsbehörde, die ein System im Rahmen eines Audits prüft. Diese unterschiedlichen Zielgruppen erfordern unterschiedliche Formen von Erklärungen – von detaillierten technischen Reports bis zu einfachen, verständlichen Sätzen.
Sinnvoll ist außerdem, Explainable AI nicht erst am Ende eines Projekts, sondern von Beginn an mitzudenken. Wird die Wahl des Modells von vornherein auch unter dem Gesichtspunkt der Erklärbarkeit getroffen, lassen sich spätere Nachbesserungen vermeiden. In manchen Anwendungsfällen ist ein intrinsisch interpretierbares Modell mit leicht geringerer Genauigkeit die bessere Wahl als ein Black-Box-Modell, das nachträglich aufwendig erklärbar gemacht werden muss.
Ebenso wichtig ist die kontinuierliche Überprüfung: Erklärbarkeit ist kein einmaliger Haken, der abgearbeitet wird, sondern ein fortlaufender Prozess. Modelle werden regelmäßig neu trainiert, Datenverteilungen verändern sich, und mit ihnen potenziell auch die Relevanz einzelner Merkmale. Regelmäßige Audits, die sowohl die Modellleistung als auch die Qualität und Robustheit der Erklärungen prüfen, sollten deshalb fest im Betrieb verankert sein.
Schließlich lohnt sich die Investition in verständliche Kommunikation. Die technisch beste Erklärung nützt wenig, wenn sie ihre Zielgruppe nicht erreicht. Unternehmen, die Explainable AI erfolgreich einsetzen, übersetzen technische Erklärungen konsequent in eine Sprache, die für die jeweiligen Nutzerinnen und Nutzer verständlich ist – ob Kunden, Sachbearbeiter oder Regulierungsbehörde.
Welche Rolle spielen Data Scientists und Machine Learning Engineers bei XAI?
Explainable AI ist keine Aufgabe, die sich allein technisch lösen lässt – sie erfordert enge Zusammenarbeit unterschiedlicher Rollen. Data Scientists und Machine Learning Engineers tragen dabei die zentrale Verantwortung für die technische Umsetzung: Sie wählen geeignete Modelle aus, implementieren Erklärungsmethoden wie SHAP oder LIME und validieren, ob die erzeugten Erklärungen das tatsächliche Modellverhalten widerspiegeln.
Diese Aufgabe geht über reine Programmierarbeit hinaus. Data Scientists übersetzen den fachlichen Kontext in ein Machine-Learning-Problem und entwickeln das Modell: Sie wählen geeignete Modelle aus, trainieren und optimieren sie. Anschließend analysieren sie das Modell, und hier kommen Erklärungsmethoden wie SHAP oder LIME zum Einsatz. Sie prüfen, ob die Erklärungen das reale Modellverhalten widerspiegeln, und ordnen sie im jeweiligen Fachkontext ein, etwa im Finanzwesen oder in der Medizin. Zudem übersetzen sie die technischen Ergebnisse zurück für Personen ohne technischen Hintergrund, etwa Fachabteilungen oder Aufsichtsbehörden.
Machine Learning Engineers verantworten die Implementierung des Modells und der Erklärungsmethoden sowie den laufenden Betrieb. Sie müssen abwägen, welchen Rechenaufwand Erklärungen in Produktivumgebungen verursachen und wie sie sich in bestehende Systeme integrieren lassen, ohne den Betrieb spürbar zu verlangsamen. Im laufenden Betrieb überwachen sie nicht nur das Modell, sondern auch die Qualität und Robustheit der Erklärungen. Außerdem kontrollieren sie die Qualität neuer Daten, erkennen Datenverschiebungen (Data Drift) und führen bei Bedarf ein erneutes Training samt neuem Tuning durch. Darüber hinaus stellen sie sicher, dass Nutzerinnen und Nutzer Zugriff auf das Modell und seine Erklärungen haben.
Da sich die Aufgabenfelder überschneiden, sind interdisziplinäre Teams sinnvoll, die die Perspektiven beider Rollen verbinden. In vielen Unternehmen entstehen deshalb zunehmend solche Teams, in denen technisches Fachwissen, Domänenwissen und regulatorisches Verständnis zusammengeführt werden, um Explainable AI wirksam im Betrieb zu verankern.
Erklärbare KI als Grundlage für vertrauenswürdige Entscheidungen
Explainable AI ist längst kein Nischenthema mehr, sondern ein zentraler Baustein für den verantwortungsvollen Einsatz künstlicher Intelligenz in Unternehmen. Ob Kreditvergabe, medizinische Diagnostik oder Betrugserkennung: Überall dort, wo KI-Modelle Entscheidungen mit realen Konsequenzen treffen, wächst der Bedarf, diese Entscheidungen nachvollziehbar zu machen.
Die vorgestellten Methoden – von SHAP über LIME und kontrafaktische Erklärungen bis hin zu Layer-wise Relevance Propagation und Causal Tracing - zeigen, dass es für nahezu jeden Anwendungsfall geeignete Werkzeuge gibt. Wichtig ist dabei, die jeweilige Methode zum Ziel passend auszuwählen, ihre Grenzen zu kennen und Erklärbarkeit als kontinuierlichen Prozess zu verstehen statt als einmalige technische Maßnahme.
Mit der DSGVO und dem EU AI Act verschärfen sich zudem die regulatorischen Rahmenbedingungen kontinuierlich. Unternehmen, die schon heute in erklärbare KI-Systeme investieren, schaffen damit nicht nur Rechtssicherheit, sondern auch die Vertrauensbasis, die für eine breite Akzeptanz von KI-gestützten Entscheidungen notwendig ist.
Suchst du Unterstützung bei der Einführung eines Explainable AI Modells oder bist auf der Suche nach einer passenden Schulung? Wir unterstützen dich bei der Einführung von KI-Systemen in deinem Unternehmen!
Häufig gestellte Fragen zu Explainable AI (FAQ)
Explainable AI bezeichnet Methoden, die nachvollziehbar machen, wie und warum ein KI-Modell zu einer bestimmten Entscheidung oder Vorhersage gelangt ist. Statt nur ein Ergebnis auszugeben, gibt es zusätzlich eine Erklärung, etwa welche Faktoren besonders stark ins Gewicht gefallen sind.
Die Begriffe werden nicht einheitlich verwendet. Häufig beschreibt Interpretierbarkeit, wie transparent ein Modell von seiner Struktur her ist. Explainability beschreibt, wie gut sich die Entscheidungen eines Modells – auch nachträglich, mit zusätzlichen Methoden – erklären lassen, unabhängig davon, wie transparent das Modell selbst aufgebaut ist.
Es gibt keine pauschal „beste“ Methode. SHAP liefert theoretisch fundiertere und konsistentere Ergebnisse, ist in der modellagnostischen Variante aber rechenintensiver. LIME ist schneller und intuitiv verständlich, bietet jedoch keine formalen Konsistenzgarantien, und seine Erklärungen können von Durchlauf zu Durchlauf leicht schwanken. Viele Unternehmen setzen je nach Anwendungsfall beide Methoden ergänzend ein.
Direkt vorgeschrieben ist XAI selten als eigenständige Pflicht. Indirekt ergibt sich der Bedarf jedoch sowohl aus Artikel 22 der DSGVO als auch aus den Transparenz- und Aufsichtspflichten des EU AI Act für Hochrisiko-KI-Systeme. Wer diese Vorgaben in der Praxis erfüllen will, braucht nachvollziehbare Modelle. Das gelingt entweder mit von vornherein interpretierbaren Modellen wie linearen Regressionen oder kleineren Entscheidungsbäumen oder, bei komplexeren Modellen, mit zusätzlichen Explainable-AI-Methoden.
Deep-Learning-Modelle bestehen aus vielen Schichten und Millionen bis Milliarden Parametern, die während des Trainings automatisch angepasst werden. Durch die vielen nichtlinearen Zusammenhänge zwischen diesen Parametern entstehen verschachtelte Berechnungen, bei denen einzelne Gewichte keine für Menschen lesbare Bedeutung mehr haben. Diese hohe Komplexität ermöglicht zwar präzise Vorhersagen, macht die interne Logik aber nicht mehr direkt nachvollziehbar – anders als bei einfachen, von Natur aus interpretierbaren Modellen wie linearen Regressionen.
Nein. Explainable AI verhindert Verzerrungen nicht, sie kann aber dabei helfen, sie zu erkennen, indem sie zeigt, welche Merkmale eine Vorhersage beeinflussen. Die eigentliche Beseitigung von Bias erfordert zusätzliche Maßnahmen, etwa die Anpassung der Trainingsdaten oder gezielte Fairness-Korrekturen im Modell selbst.
Nachvollziehbare Erklärungen sind eine wesentliche Voraussetzung dafür, dass Menschen KI-gestützten Entscheidungen vertrauen. Wer versteht, warum ein Modell zu einem bestimmten Ergebnis gekommen ist, kann dieses Ergebnis besser einordnen, kritisch hinterfragen und im Zweifel auch anfechten – das stärkt die Akzeptanz von KI-Systemen sowohl bei Mitarbeitenden als auch bei Kundinnen und Kunden.
Nicht zwangsläufig. Nachträgliche (Post-hoc-) Erklärungsmethoden liefern Annäherungen an das tatsächliche Modellverhalten, keine absolute Wahrheit. Forschungsarbeiten zeigen zudem, dass sich Erklärungen gezielt manipulieren lassen, ohne die zugrunde liegende Vorhersage zu verändern. Erklärungen sollten deshalb stets kritisch geprüft und nicht unreflektiert als Beweis für die Vertrauenswürdigkeit eines Modells verstanden werden.


