
Intelligenza artificiale spiegabile (XAI): come rendere comprensibili le decisioni dell’IA
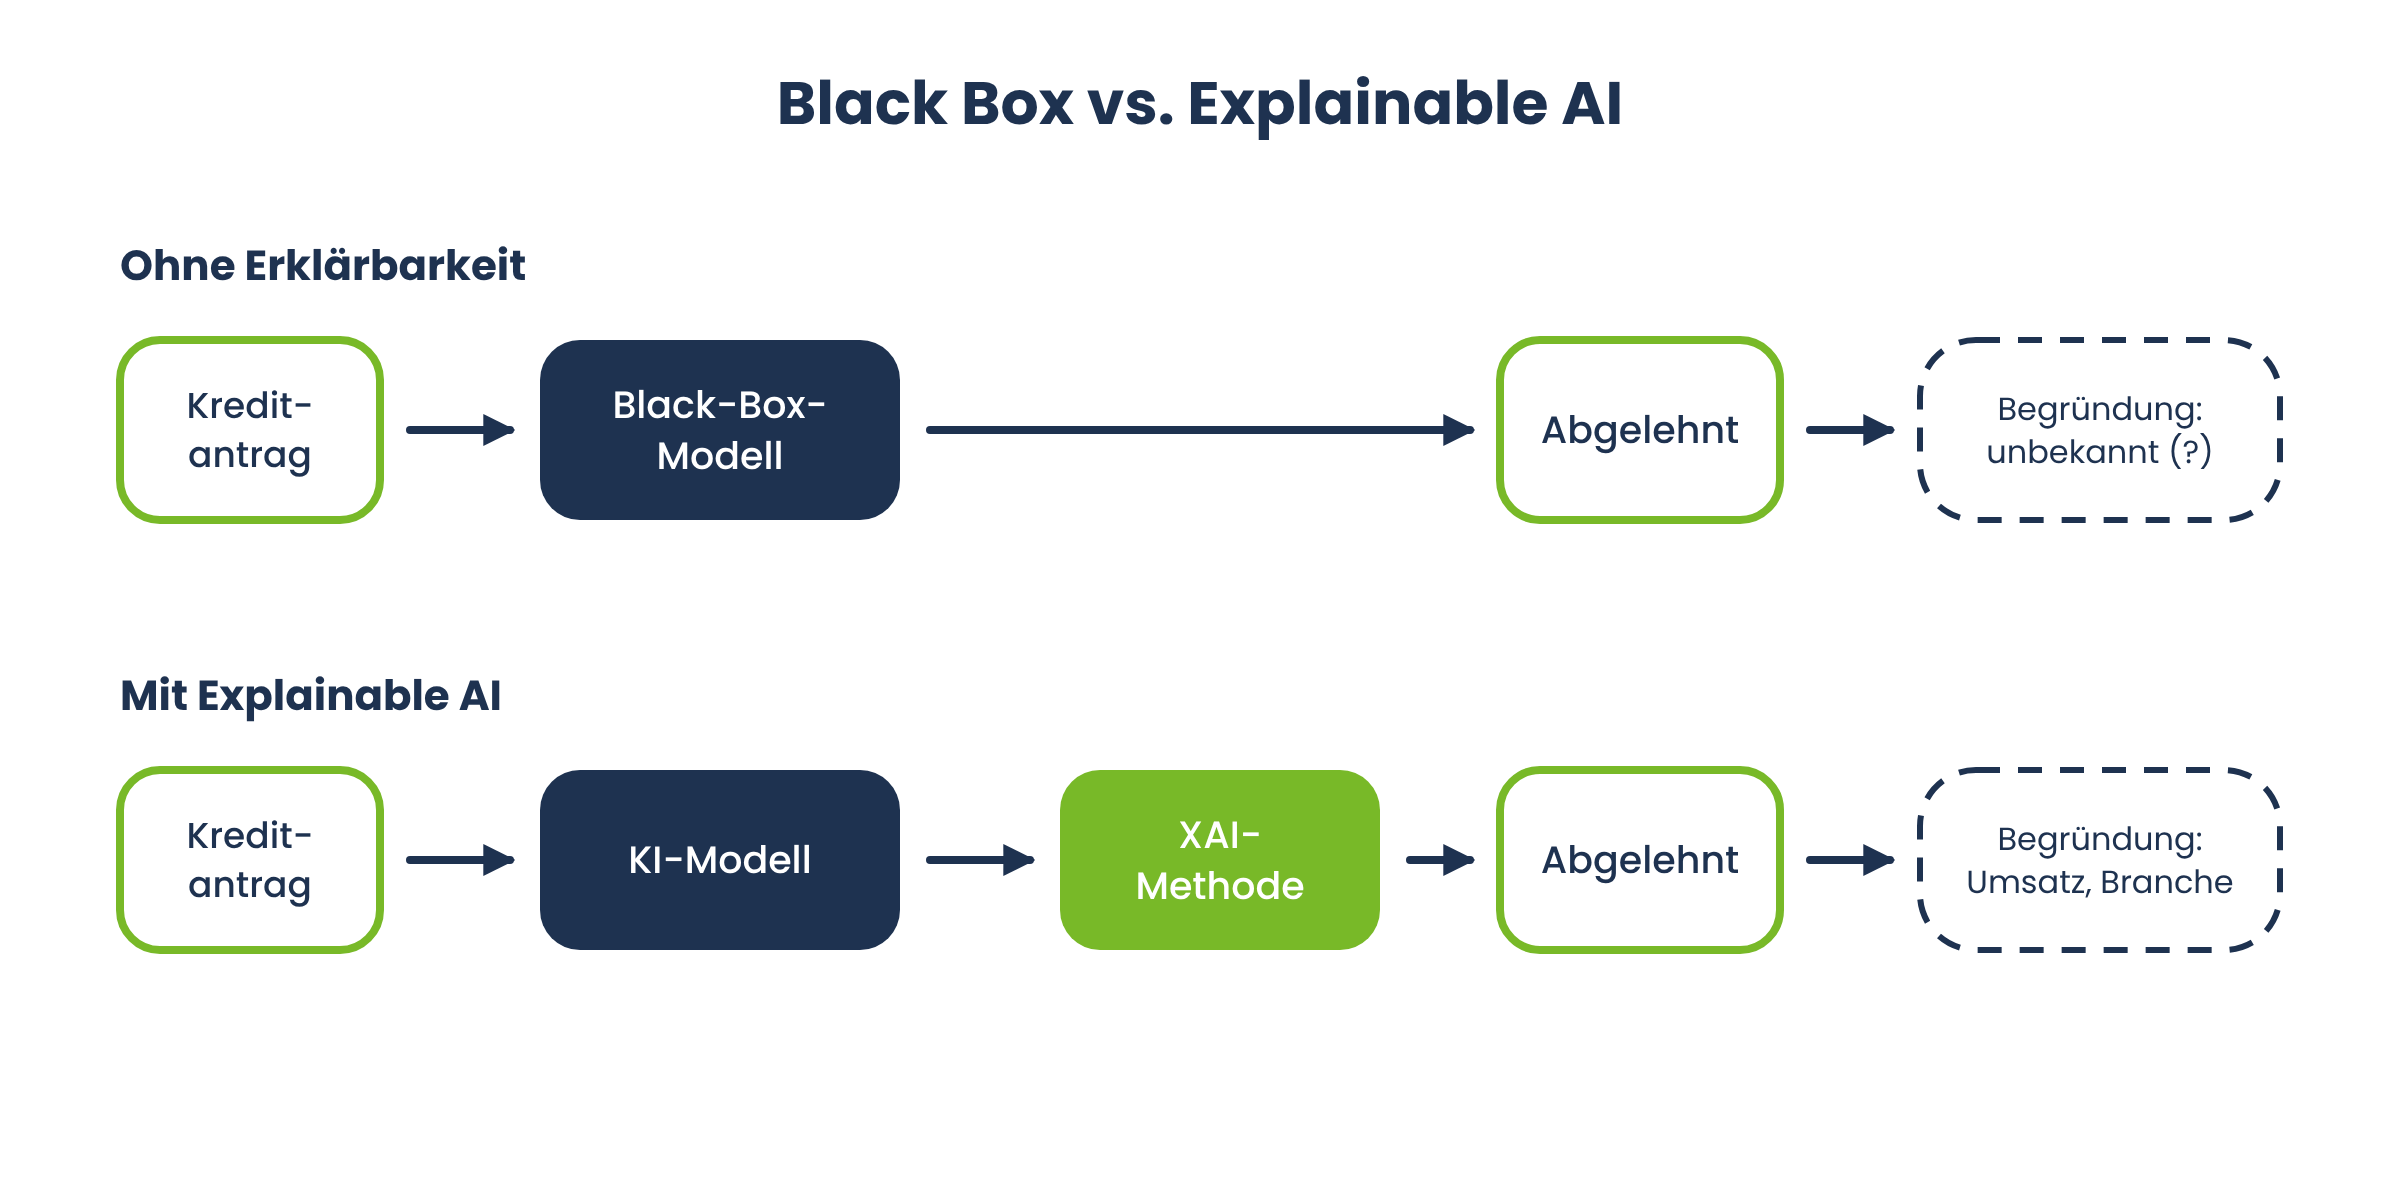
Un’azienda presenta una richiesta di prestito. La banca utilizza un modello di intelligenza artificiale per valutare automaticamente le richieste. In pochi secondi arriva la risposta: respinta. Ma perché? Né l’addetto alla pratica né il richiedente riescono a capire quali fattori abbiano portato a questa decisione. È stato l’andamento del fatturato, il settore di attività, un singolo dato anomalo nei registri contabili? Senza una risposta, rimane solo la frustrazione – e, nel peggiore dei casi, il sospetto di un trattamento ingiusto.
Questo scenario illustra perché l’Intelligenza Artificiale Spiegabile (XAI) sia oggi indispensabile per le aziende. Più decisioni vengono delegate ai sistemi di IA, più diventa importante capire come questi sistemi giungano ai propri risultati. Ciò vale tanto per la concessione di crediti quanto per le diagnosi mediche, le procedure di selezione del personale o la verifica automatizzata dei sinistri assicurativi. L’Intelligenza Artificiale Spiegabile fornisce gli strumenti per aprire proprio questa “scatola nera”.
In questo articolo scoprirai cosa significa concretamente l’Intelligenza Artificiale Spiegabile, quali metodi ne costituiscono la base e perché l’XAI non è più solo un dettaglio tecnico, ma una necessità normativa ed economica.
Che cos’è l’IA spiegabile (XAI)? Una definizione:
L'Intelligenza Artificiale Spiegabile, abbreviata in XAI, indica un insieme di metodi e processi che consentono di rendere comprensibili alle persone le decisioni e le previsioni dei modelli di IA. Il termine comprende sia procedure tecniche che spiegano singole previsioni, sia concetti di livello superiore come la trasparenza dei modelli e la documentazione.
Per comprendere l’XAI, è utile esaminare il problema di fondo: l’intelligenza artificiale moderna si basa spesso sull’apprendimento automatico (ML), in particolare sulle reti neurali artificiali profonde (deep learning). Questi modelli apprendono da grandi quantità di dati, riconoscendo al loro interno modelli e correlazioni e ricavandone previsioni. Il risultato è spesso un’accuratezza predittiva straordinariamente elevata, ma anche un modello la cui logica interna è difficilmente comprensibile persino per gli stessi sviluppatori. Si parla allora di un modello «black box».
L’intelligenza artificiale spiegabile (XAI) interviene proprio in questo ambito. Fornisce risposte a domande quali: quali caratteristiche di un set di dati sono state determinanti per una determinata previsione? Come sarebbe cambiato il risultato se un dato di input fosse stato diverso? E il comportamento complessivo del modello può essere sintetizzato in regole comprensibili? È importante sottolineare che l’XAI non sostituisce le prestazioni di un modello, ma le integra con una seconda dimensione altrettanto importante: la comprensione.
Esempi pratici: dove viene utilizzata oggi l’IA spiegabile?
I concetti teorici dell’IA spiegabile rivelano il loro valore solo nel contesto applicativo concreto. Tre settori mostrano in modo particolarmente chiaro quanto possano variare i requisiti di spiegabilità a seconda del settore.
Esempio n. 1: settore finanziario e concessione di crediti
Nel settore finanziario, l’IA spiegabile fa ormai parte da tempo degli strumenti standard. Le banche utilizzano modelli di IA per valutare l’affidabilità creditizia, i rischi di frode o fornire consigli di investimento. Poiché queste decisioni hanno conseguenze finanziarie immediate per i clienti e sono soggette a una vigilanza normativa particolarmente rigorosa, le motivazioni comprensibili sono praticamente indispensabili. I valori SHAP aiutano in questo caso a scomporre a posteriori ogni singola decisione di credito in fattori specifici comprensibili – un requisito fondamentale sia per i processi di revisione interna che per la comunicazione con le autorità di vigilanza.
Esempio n. 2: Medicina e diagnostica
In medicina, la sicurezza del paziente è al centro di ogni diagnosi supportata dall'intelligenza artificiale. Un modello che ricava una diagnosi da una radiografia o da un campione di tessuto deve essere in grado di mostrare ai medici su cosa si basi tale valutazione. Metodi come la Layerwise Relevance Propagation vengono utilizzati molto spesso in questo contesto, poiché possono essere sovrapposti direttamente ai dati delle immagini mediche sotto forma di mappe di calore intuitive. In questo modo, il personale medico può confrontare la raccomandazione dell’IA con le proprie conoscenze specialistiche, invece di accettarla ciecamente o ignorarla in modo indiscriminato.
Esempio n. 3: Rilevamento delle frodi e analisi forense delle immagini con Fraudify
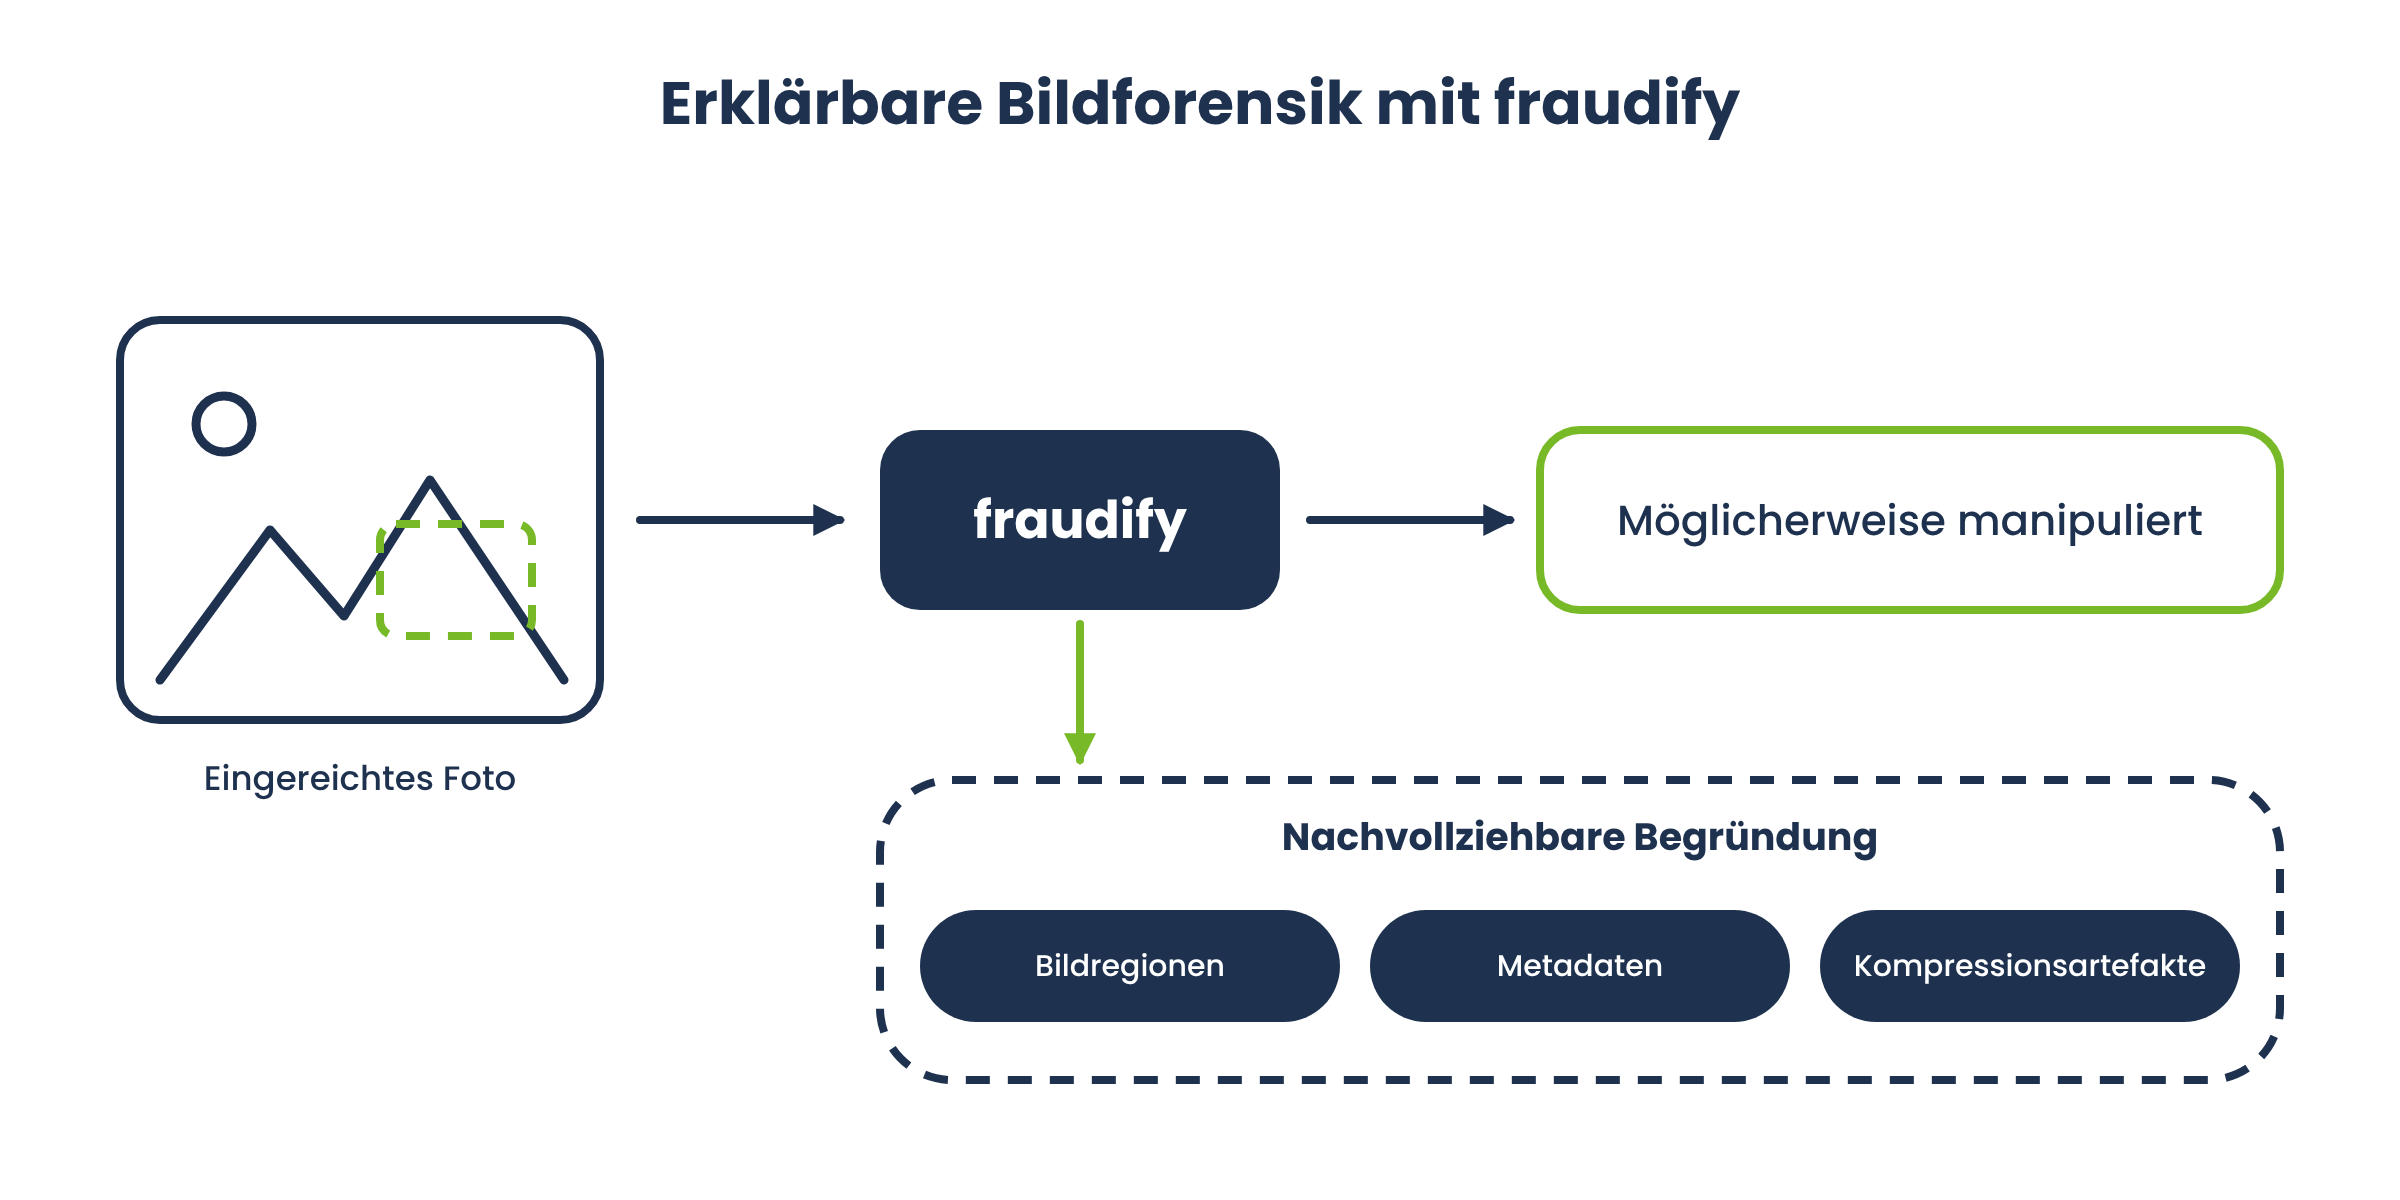
Anche nell’analisi automatizzata di immagini e documenti con il nostro software di analisi forense delle immagini fraudify, la spiegabilità assume sempre maggiore importanza. Se una foto inviata viene classificata da fraudify come potenzialmente manipolata, nella pratica raramente è sufficiente una semplice risposta sì/no. Gli addetti alla gestione hanno bisogno di una motivazione comprensibile, ad esempio quali aree dell’immagine, metadati o artefatti di compressione abbiano portato a tale valutazione, per poter contestualizzare la decisione dal punto di vista tecnico e giustificarla nei confronti dei clienti. In questo contesto, la spiegabilità diventa un fattore decisivo affinché l’analisi forense delle immagini basata sull’intelligenza artificiale venga accettata e utilizzata in modo produttivo nella pratica quotidiana.
Perché la spiegabilità è così importante nei sistemi di IA?
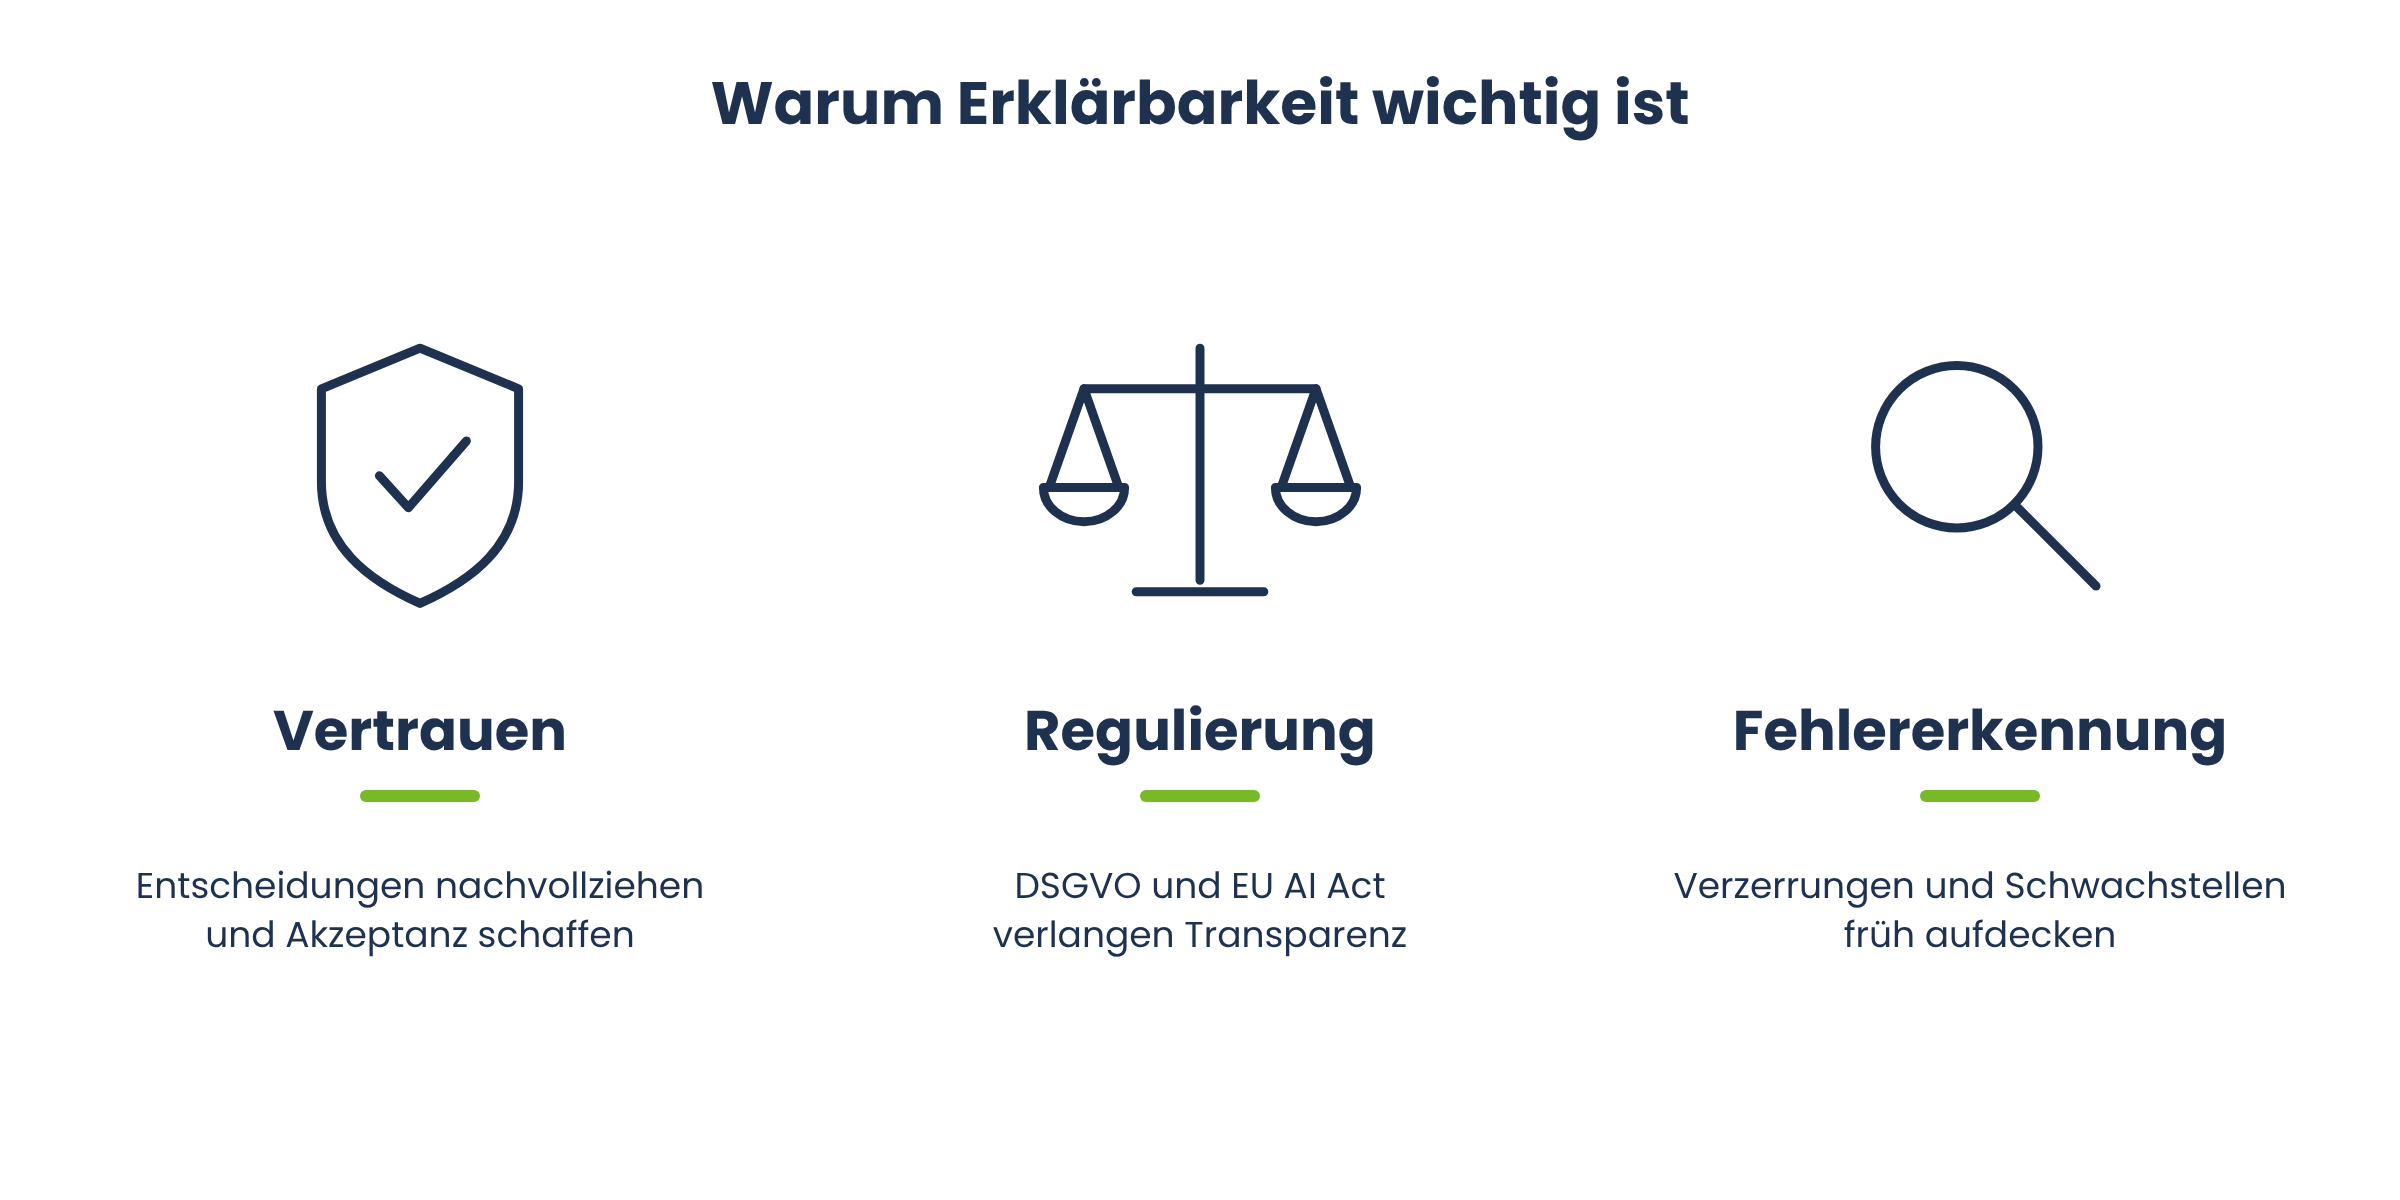
L'importanza dell'IA spiegabile può essere ricondotta a tre motivi fondamentali: fiducia, regolamentazione e individuazione degli errori. Ciascuno di questi aspetti riguarda direttamente le aziende non appena i modelli di IA vengono impiegati in processi critici per l'attività aziendale.
Motivo n. 1: infondere fiducia nelle decisioni supportate dall’IA
Le persone tendono a fidarsi maggiormente delle decisioni quando ne comprendono il processo decisionale. Ciò vale sia per la comunicazione interpersonale che per l’uso della tecnologia. Un sistema di IA che si limita a fornire un risultato senza alcuna motivazione appare come un oracolo – e ciò ne mina l’accettazione, anche se le previsioni sono oggettivamente corrette.
Per i collaboratori che utilizzano sistemi basati sull’IA, la tracciabilità è addirittura un presupposto fondamentale per una collaborazione efficace. Chi non comprende una raccomandazione dell’IA non può né convalidarla in modo sensato né difenderla nei confronti dei clienti. L’IA spiegabile crea qui la base necessaria: trasforma un semplice strumento di previsione in un assistente decisionale comprensibile.
Motivo n. 2: Rispettare i requisiti legali e normativi
La trasparenza nelle decisioni basate sull’IA non è più solo una buona idea, ma in molti casi è prescritta dalla legge. Il Regolamento generale sulla protezione dei dati (GDPR) e l’AI Act dell’UE stabiliscono requisiti concreti in materia di tracciabilità dei processi decisionali automatizzati. Approfondiremo entrambi i quadri normativi più avanti. Per le aziende ciò significa già oggi che chi utilizza sistemi di IA per casi d’uso ad alto rischio, come la concessione di crediti, la selezione del personale o la diagnostica medica, non può più fare a meno dei metodi di IA spiegabile.
Motivo n. 3: individuare tempestivamente errori, distorsioni e punti deboli
Un modello di IA può funzionare in modo errato anche se, sulla carta, la sua precisione è elevata. Un esempio classico: un classificatore di immagini ha il compito di distinguere tra lupi e husky e riconosce in modo affidabile il «lupo» – finché non si scopre che in realtà non ha imparato a riconoscere l’animale, ma ha identificato la neve sullo sfondo come caratteristica determinante. Senza l’IA spiegabile, un simile comportamento errato sarebbe passato quasi inosservato, poiché i risultati dei test sarebbero comunque risultati corretti (Ribeiro et al., 2016).
Sono proprio queste correlazioni nascoste che l’XAI porta alla luce. I metodi di spiegabilità mostrano a quali caratteristiche un modello reagisce effettivamente. In questo modo, i punti deboli vengono resi visibili prima che portino, nella pratica, a decisioni errate o discriminatorie.
Come funzionano i modelli “black box” – e perché rappresentano un problema?
Il termine "modello black box" descrive quei sistemi di intelligenza artificiale il cui funzionamento interno non è più direttamente comprensibile per l’uomo. Ciò riguarda soprattutto architetture complesse come le reti neurali profonde, i modelli ensemble composti da numerosi alberi decisionali o i grandi modelli linguistici.
Questi modelli sono costituiti da milioni o miliardi di parametri che vengono adattati automaticamente durante l’addestramento. Le numerose relazioni non lineari tra questi parametri, che si estendono su numerosi livelli, danno origine a calcoli altamente interconnessi e interdipendenti. Il risultato finale è una struttura matematica che, pur fornendo previsioni precise, presenta singole operazioni di calcolo che non hanno più un significato intuitivo e comprensibile per l’uomo.
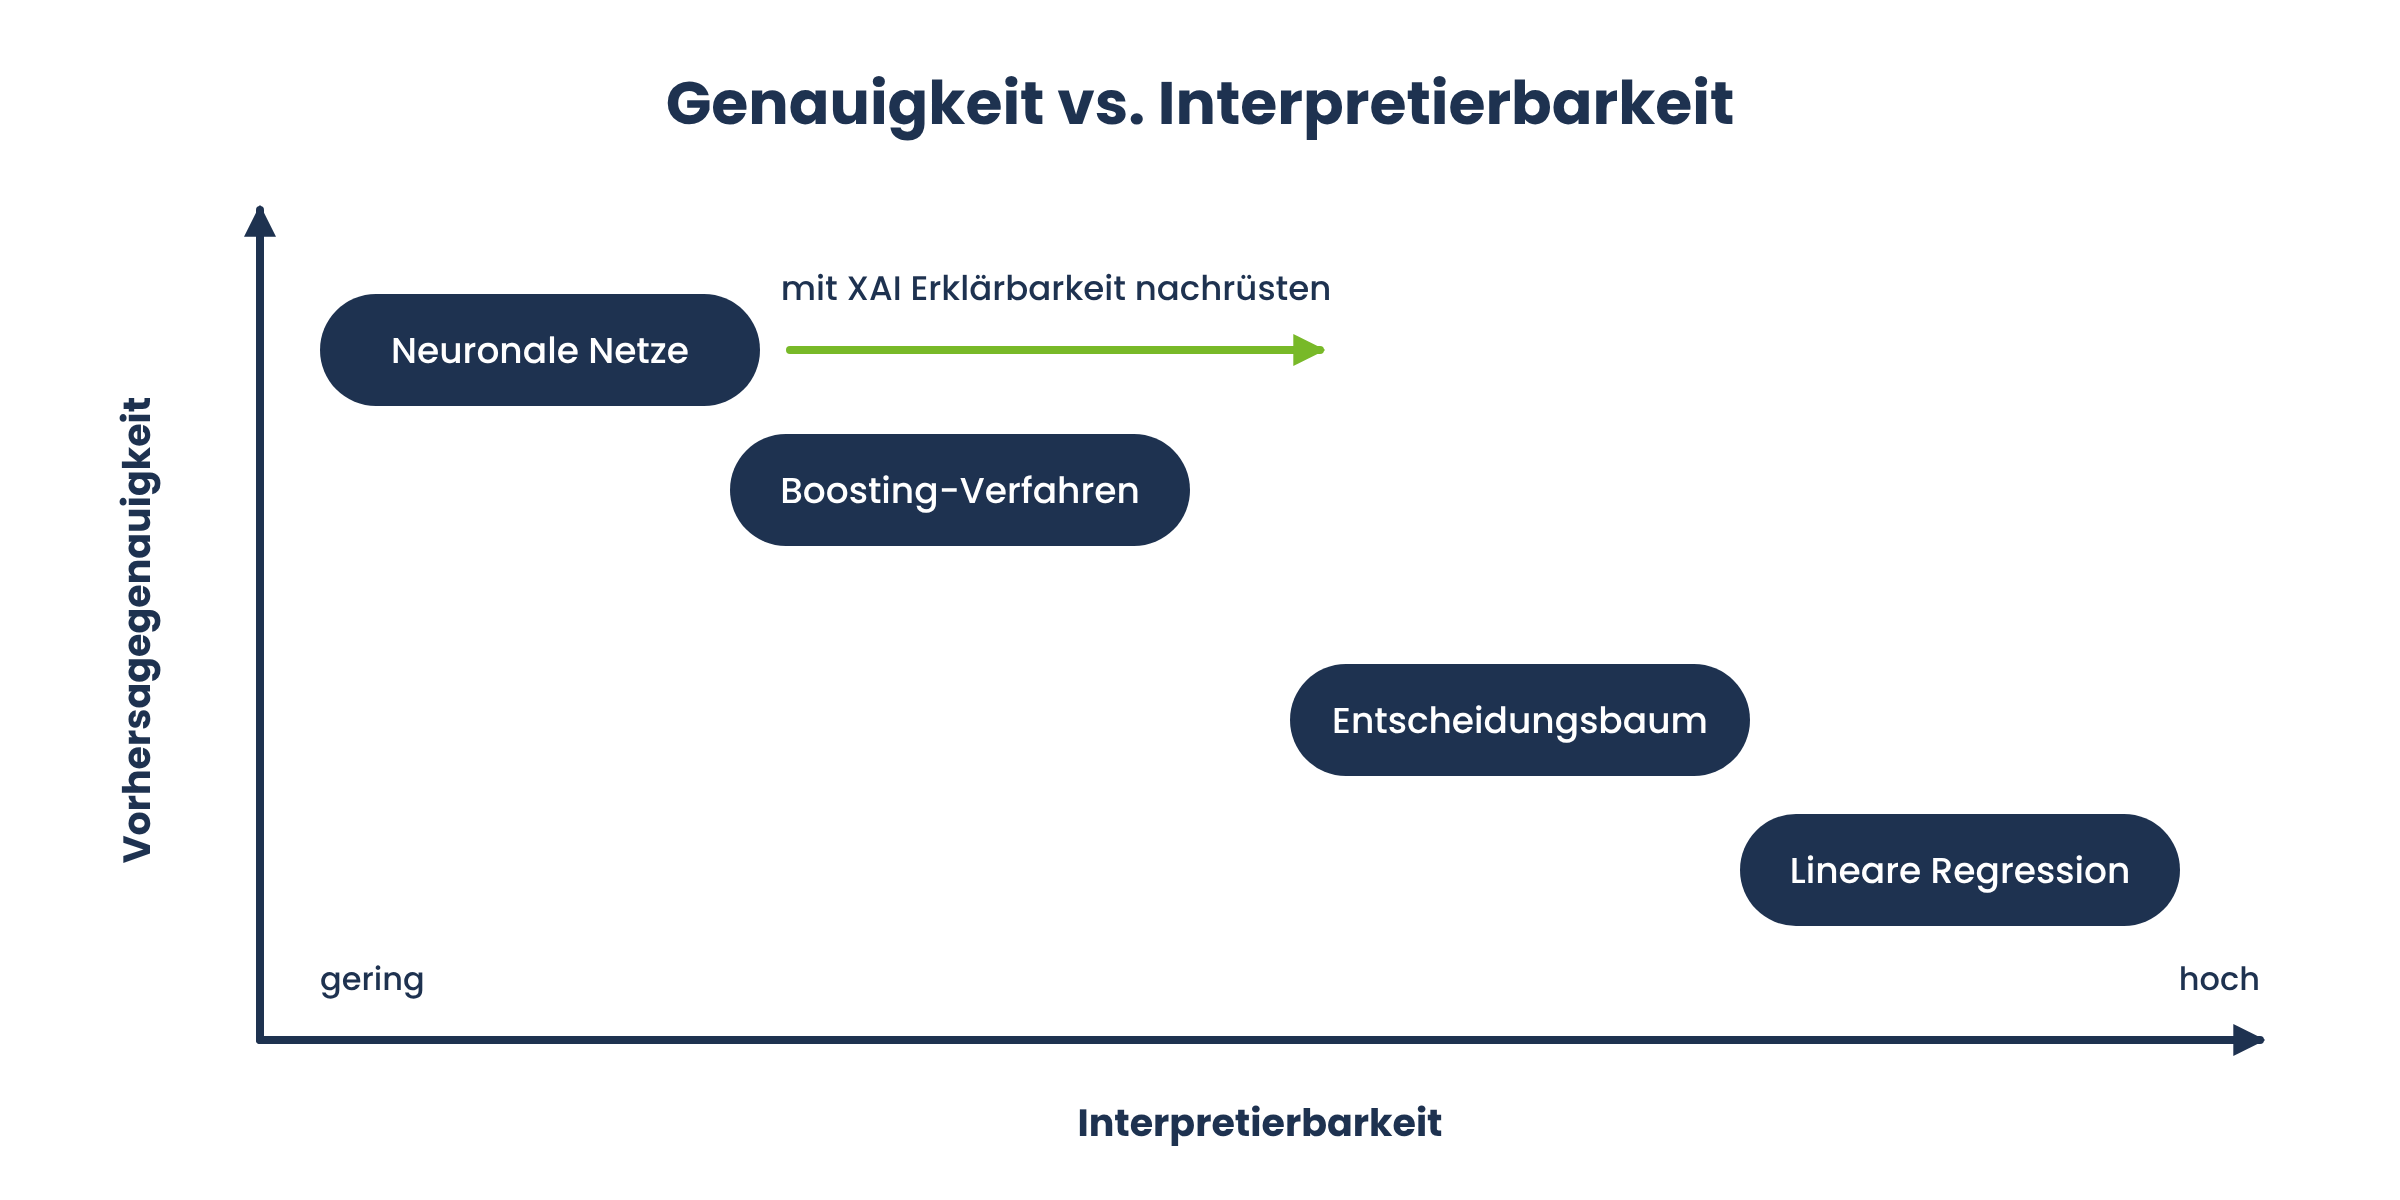
Il problema è questo: più un modello è potente, più la sua struttura diventa di norma complessa e più è difficile da spiegare. Questa osservazione porta a un conflitto che nella ricerca viene spesso descritto come un compromesso tra accuratezza e interpretabilità. Modelli semplici e di per sé comprensibili, come le regressioni lineari o i piccoli alberi decisionali, forniscono sì risultati comprensibili, ma raggiungono rapidamente i propri limiti quando si tratta di problemi complessi e ad alta dimensionalità.
In pratica, ciò significa che le aziende che puntano su modelli particolarmente potenti hanno bisogno di strumenti aggiuntivi per garantire comunque la trasparenza. Sono proprio i metodi dell’IA spiegabile a colmare questa lacuna.
Interpretabilità vs. spiegabilità: qual è la differenza?
Nella pratica, i termini "interpretabilità" (interpretability) e "spiegabilità" (explainability) vengono spesso utilizzati come sinonimi. Nella letteratura specialistica non esiste una definizione univoca. Tuttavia, viene spesso operata la seguente distinzione:
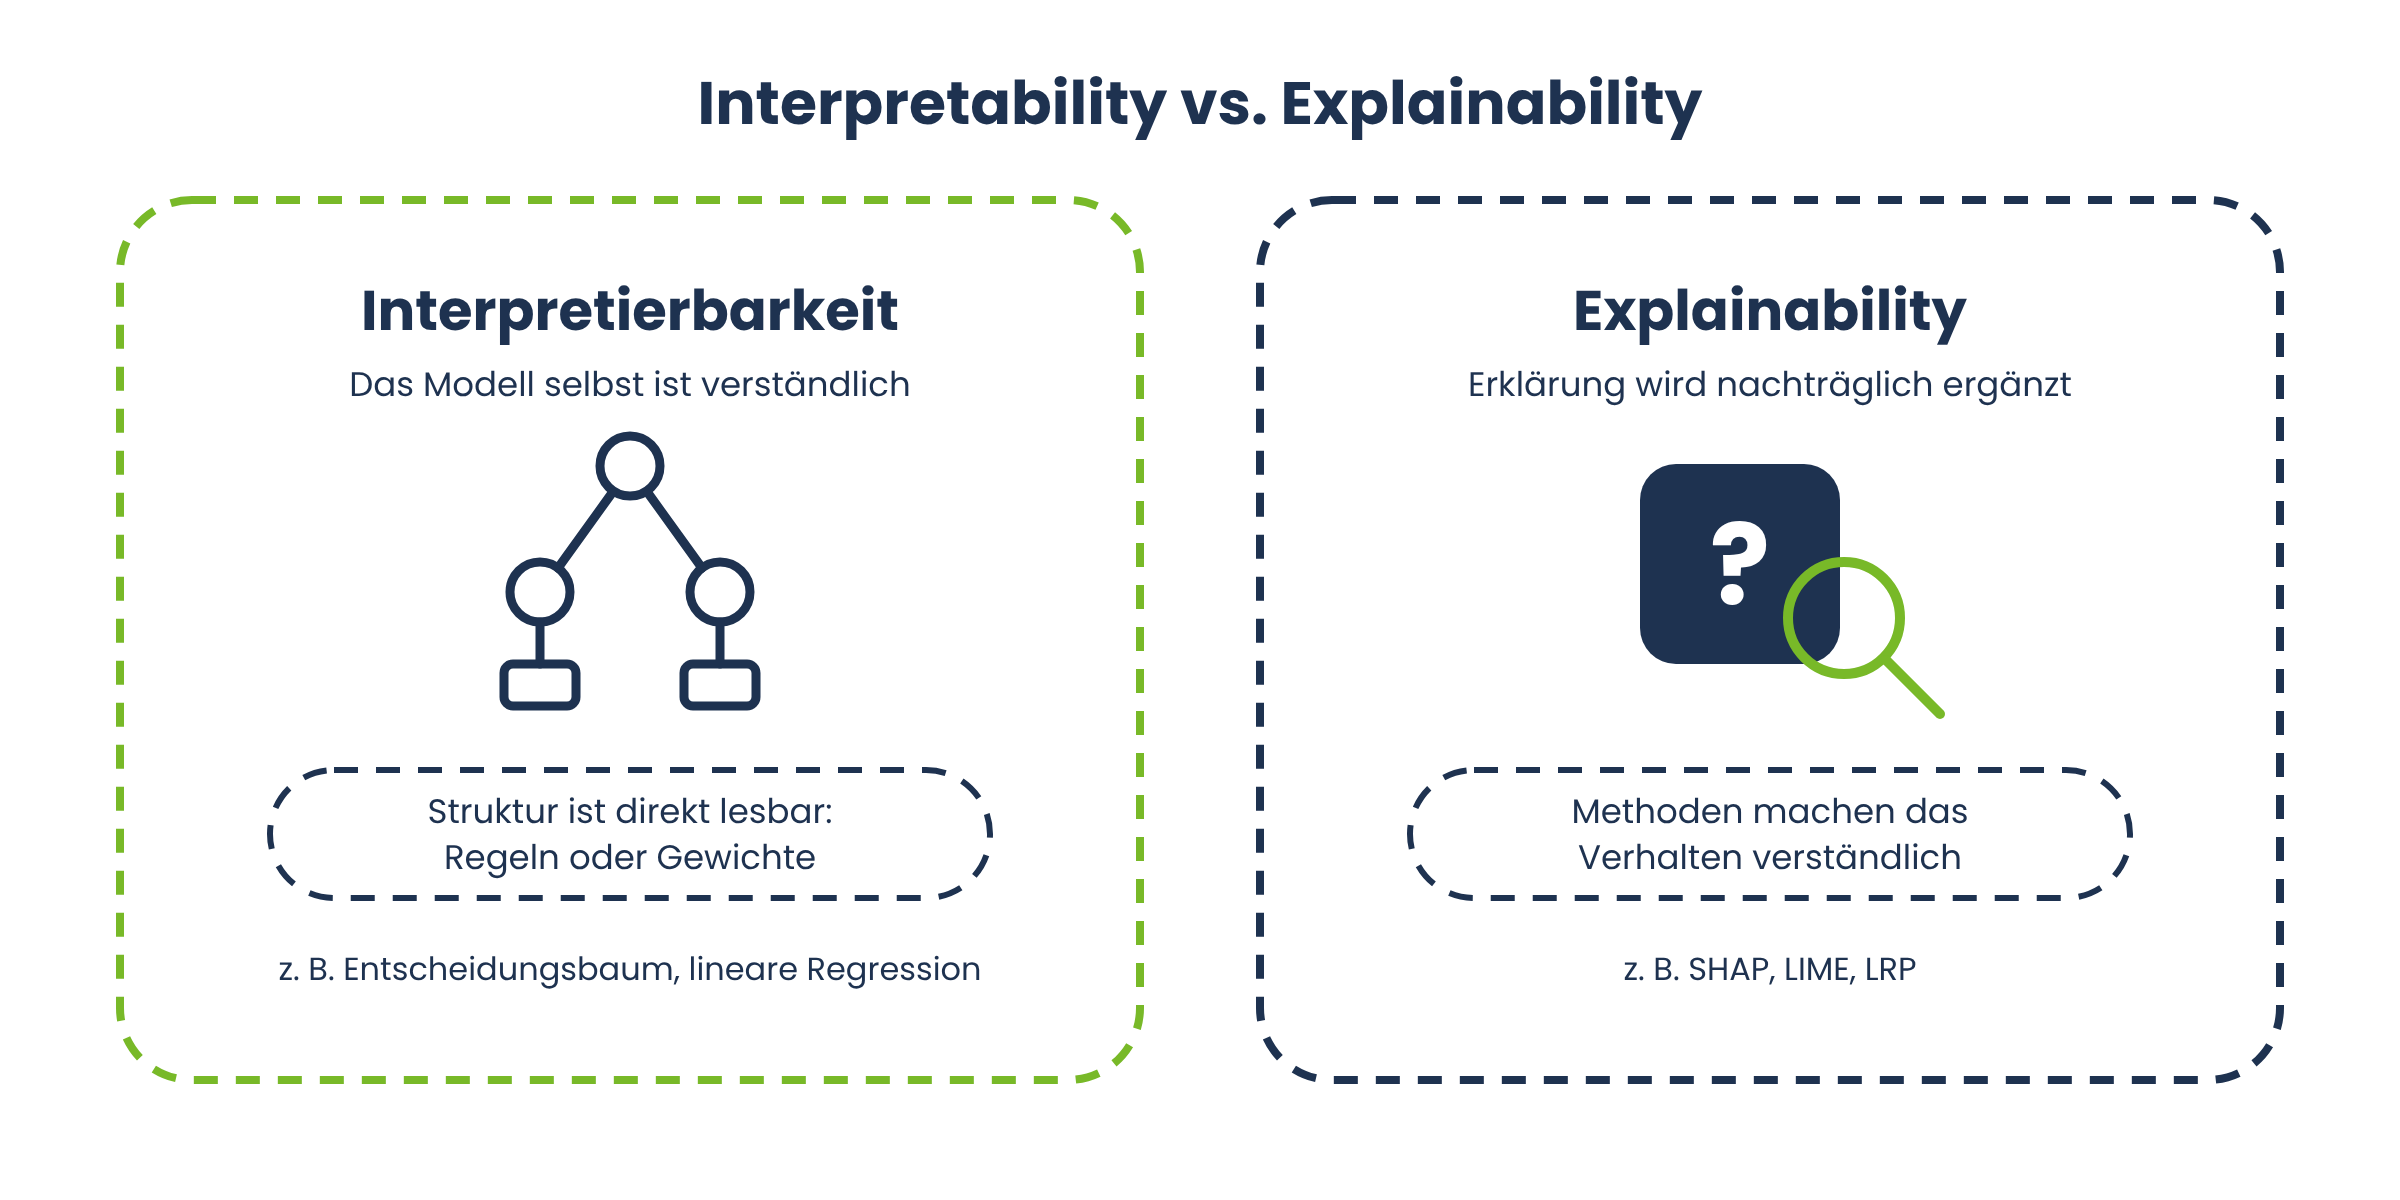
L’interpretabilità si riferisce alla trasparenza del modello stesso: quanto è facile comprendere come un modello giunga a un risultato a partire dai suoi input? Un modello interpretabile rivela la propria struttura interna – ad esempio le regole di un albero decisionale o i pesi di una regressione lineare – in modo diretto e senza strumenti aggiuntivi.
L’«explainability» (spiegabilità) va un passo oltre e mira alla giustificazione a posteriori: con metodi aggiuntivi è possibile rendere comprensibile il comportamento di un modello anche a posteriori, indipendentemente da quanto sia trasparente la sua struttura interna. Ciò è particolarmente rilevante nel caso di modelli complessi: una rete neurale per il riconoscimento delle immagini rimane internamente una «scatola nera», ma con un metodo esplicativo è comunque possibile mostrare quali regioni dell’immagine siano state determinanti per una determinata classificazione.
Sebbene i termini vengano utilizzati in modo non uniforme, la distinzione va ben oltre una sottigliezza accademica. Descrive due percorsi verso una maggiore trasparenza: scegliere modelli interpretabili fin dall’inizio oppure rendere comprensibili a posteriori modelli «scatola nera» più potenti utilizzando strumenti di spiegabilità. Quale percorso sia più sensato per un’azienda dipende soprattutto dalle prestazioni predittive richieste e dalla potenza di calcolo disponibile. I modelli interpretabili sono solitamente più veloci ed economici da addestrare e gestire, ma spesso non raggiungono la stessa precisione in contesti complessi. In questi casi, i modelli «black box», come i metodi di boosting o le reti neurali, possono offrire prestazioni migliori: i metodi di boosting sono spesso tra i modelli più efficaci con i dati tabulari, mentre le reti neurali danno il meglio di sé soprattutto con grandi volumi di dati e dati non strutturati, come immagini o testo. A tal fine richiedono maggiori risorse di calcolo e anche le spiegazioni a posteriori comportano un onere aggiuntivo.
Quali tipi di metodi XAI esistono?
Il panorama dei metodi di IA spiegabile può essere strutturato sulla base di due criteri: la portata di una spiegazione (globale o locale) e il momento in cui viene garantita la spiegabilità (fin dall’inizio o a posteriori).
Globale vs. locale: due prospettive su un modello
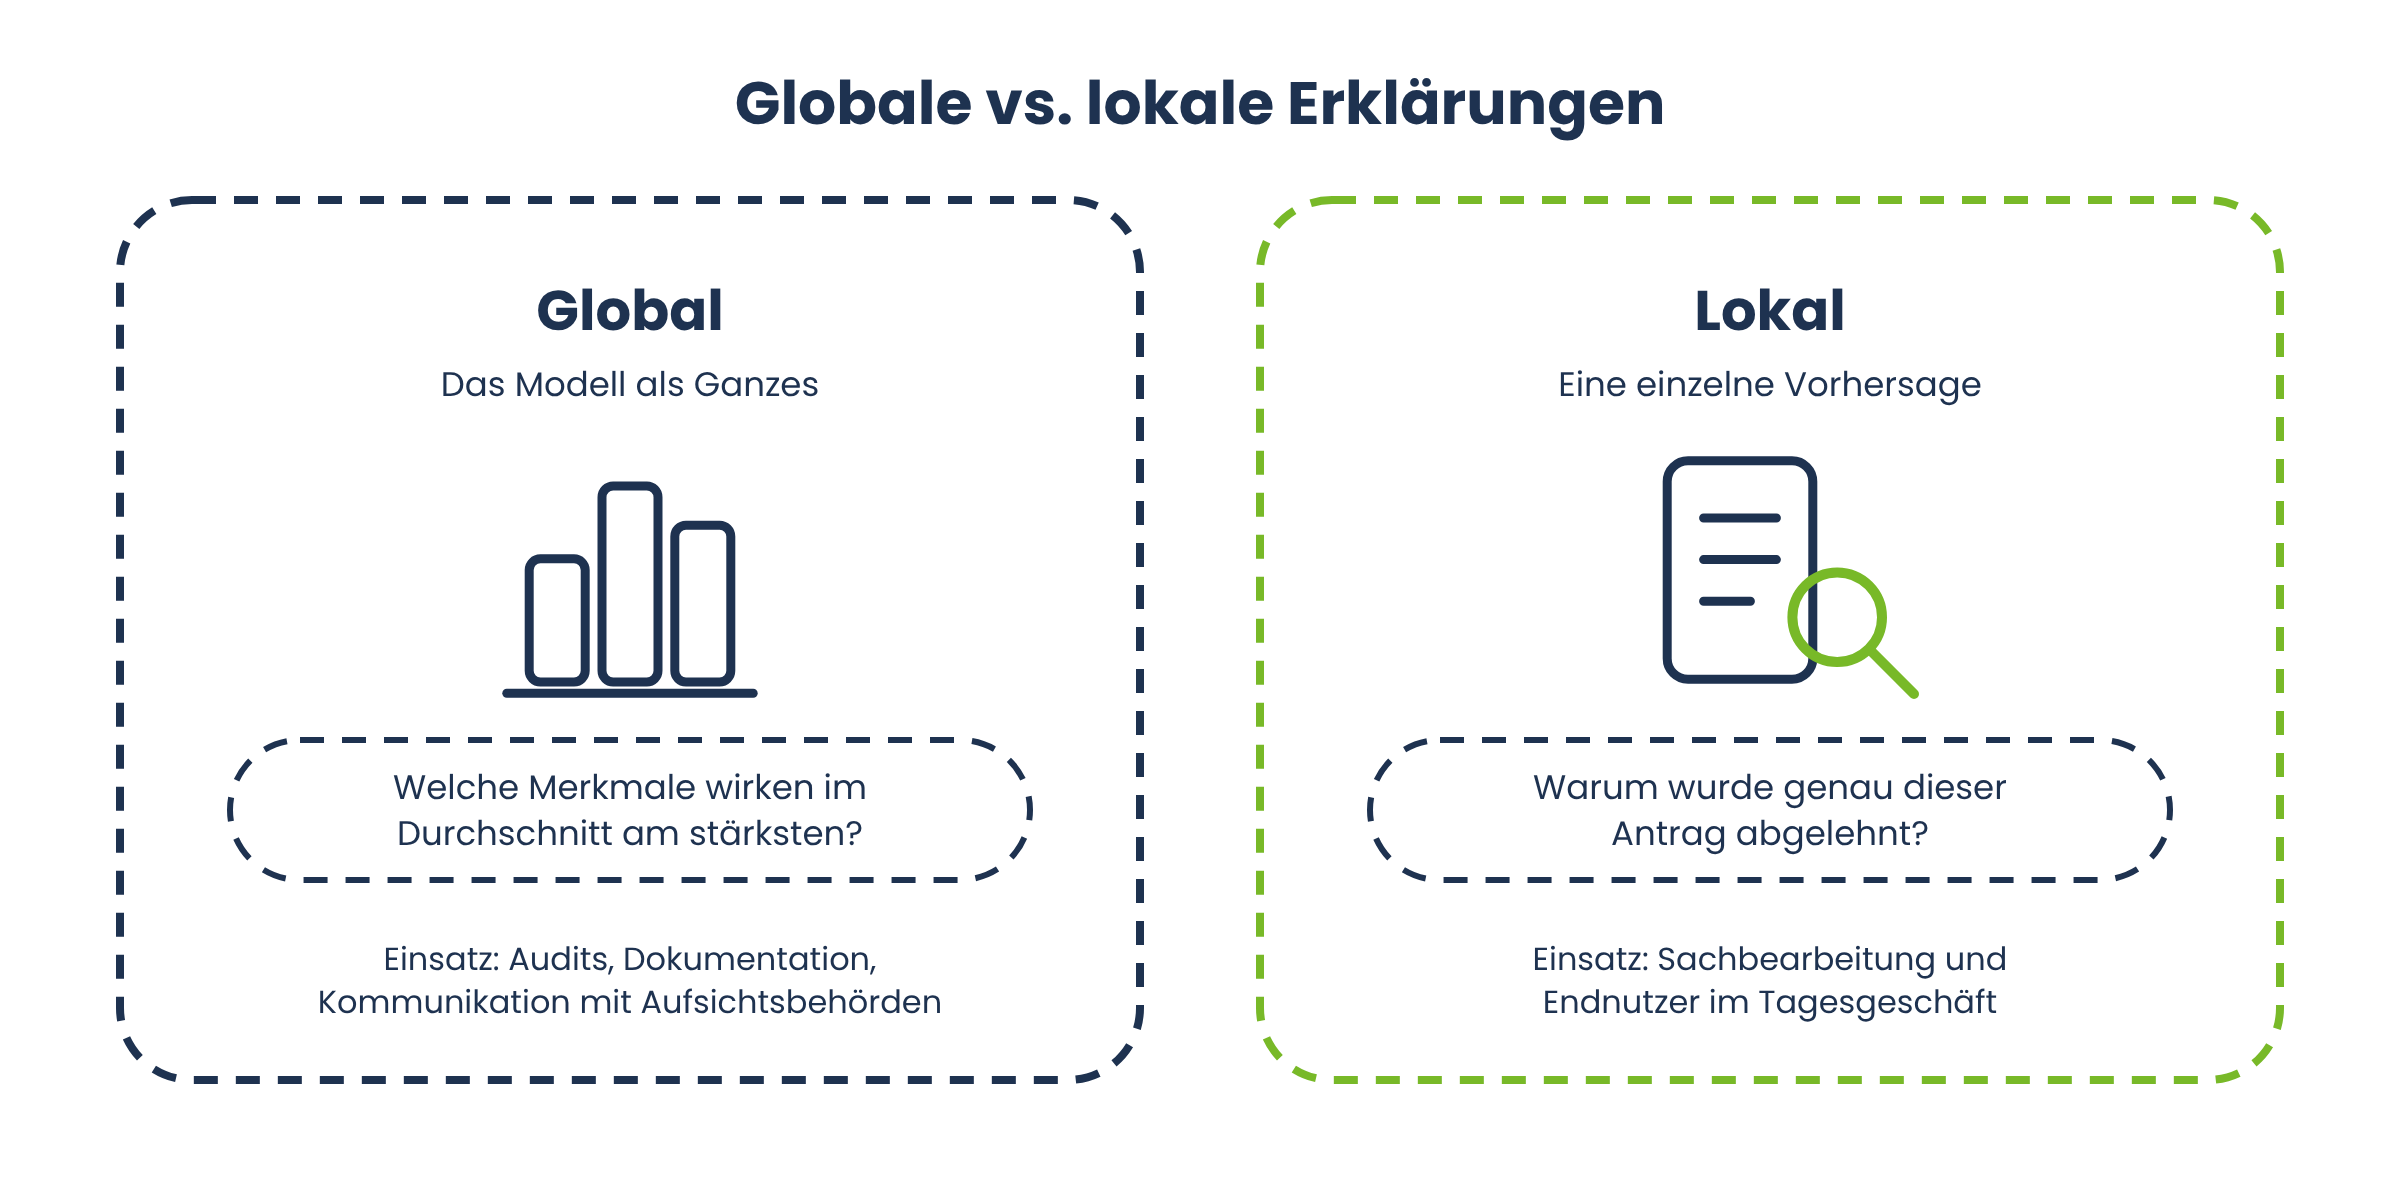
Le spiegazioni globali descrivono il comportamento di un modello nel suo complesso. Metodi tipici sono la permutazione dell’importanza delle caratteristiche (Permutation Feature Importance) e i grafici di dipendenza parziale (Partial Dependence Plots). Essi rispondono a domande quali: quali caratteristiche influenzano in media maggiormente le previsioni? Esistono modelli sistematici, come ad esempio un’eccessiva ponderazione di determinate caratteristiche demografiche? Esistono modelli sistematici, come ad esempio una ponderazione eccessiva di determinate caratteristiche demografiche quali l’età o il sesso? Oppure caratteristiche come il codice postale fungono da proxy per caratteristiche protette? Le spiegazioni globali sono particolarmente adatte per gli audit, la documentazione dei modelli e la comunicazione con le autorità di vigilanza.
Le spiegazioni locali, invece, si concentrano su una singola previsione. Rispondono alla domanda: perché proprio questa richiesta di credito è stata respinta, questa analisi è stata classificata come anomala o questo record di dati è stato contrassegnato come caso di frode? Per gli utenti finali e gli addetti alle operazioni quotidiane, le spiegazioni locali sono solitamente più rilevanti, poiché si riferiscono direttamente al singolo caso concreto.
Modelli intrinsecamente interpretabili vs. spiegazioni post hoc
Nei modelli intrinsecamente interpretabili, la tracciabilità è saldamente integrata nell'architettura del modello. Tra questi figurano, ad esempio, le regressioni lineari e logistiche, gli alberi decisionali di piccole dimensioni o i sistemi a regole. Il loro grande vantaggio: non vi è alcuna discrepanza tra ciò che il modello calcola effettivamente e la spiegazione fornita – entrambi sono identici.
Le spiegazioni post hoc, invece, intervengono dopo l’addestramento. Vengono applicate a modelli esistenti, solitamente più complessi, per rendere plausibile a posteriori il loro comportamento. Tra questi figurano la maggior parte dei metodi presentati di seguito, come SHAP, LIME o la Layerwise Relevance Propagation, nonché approcci ampiamente diffusi quali la Permutation Feature Importance e i Partial Dependence Plots. Il vantaggio risiede nella flessibilità: i metodi post hoc possono essere applicati a quasi tutti i modelli, indipendentemente dalla loro struttura interna. Lo svantaggio: la spiegazione generata è un’approssimazione del comportamento effettivo del modello, non il comportamento stesso.
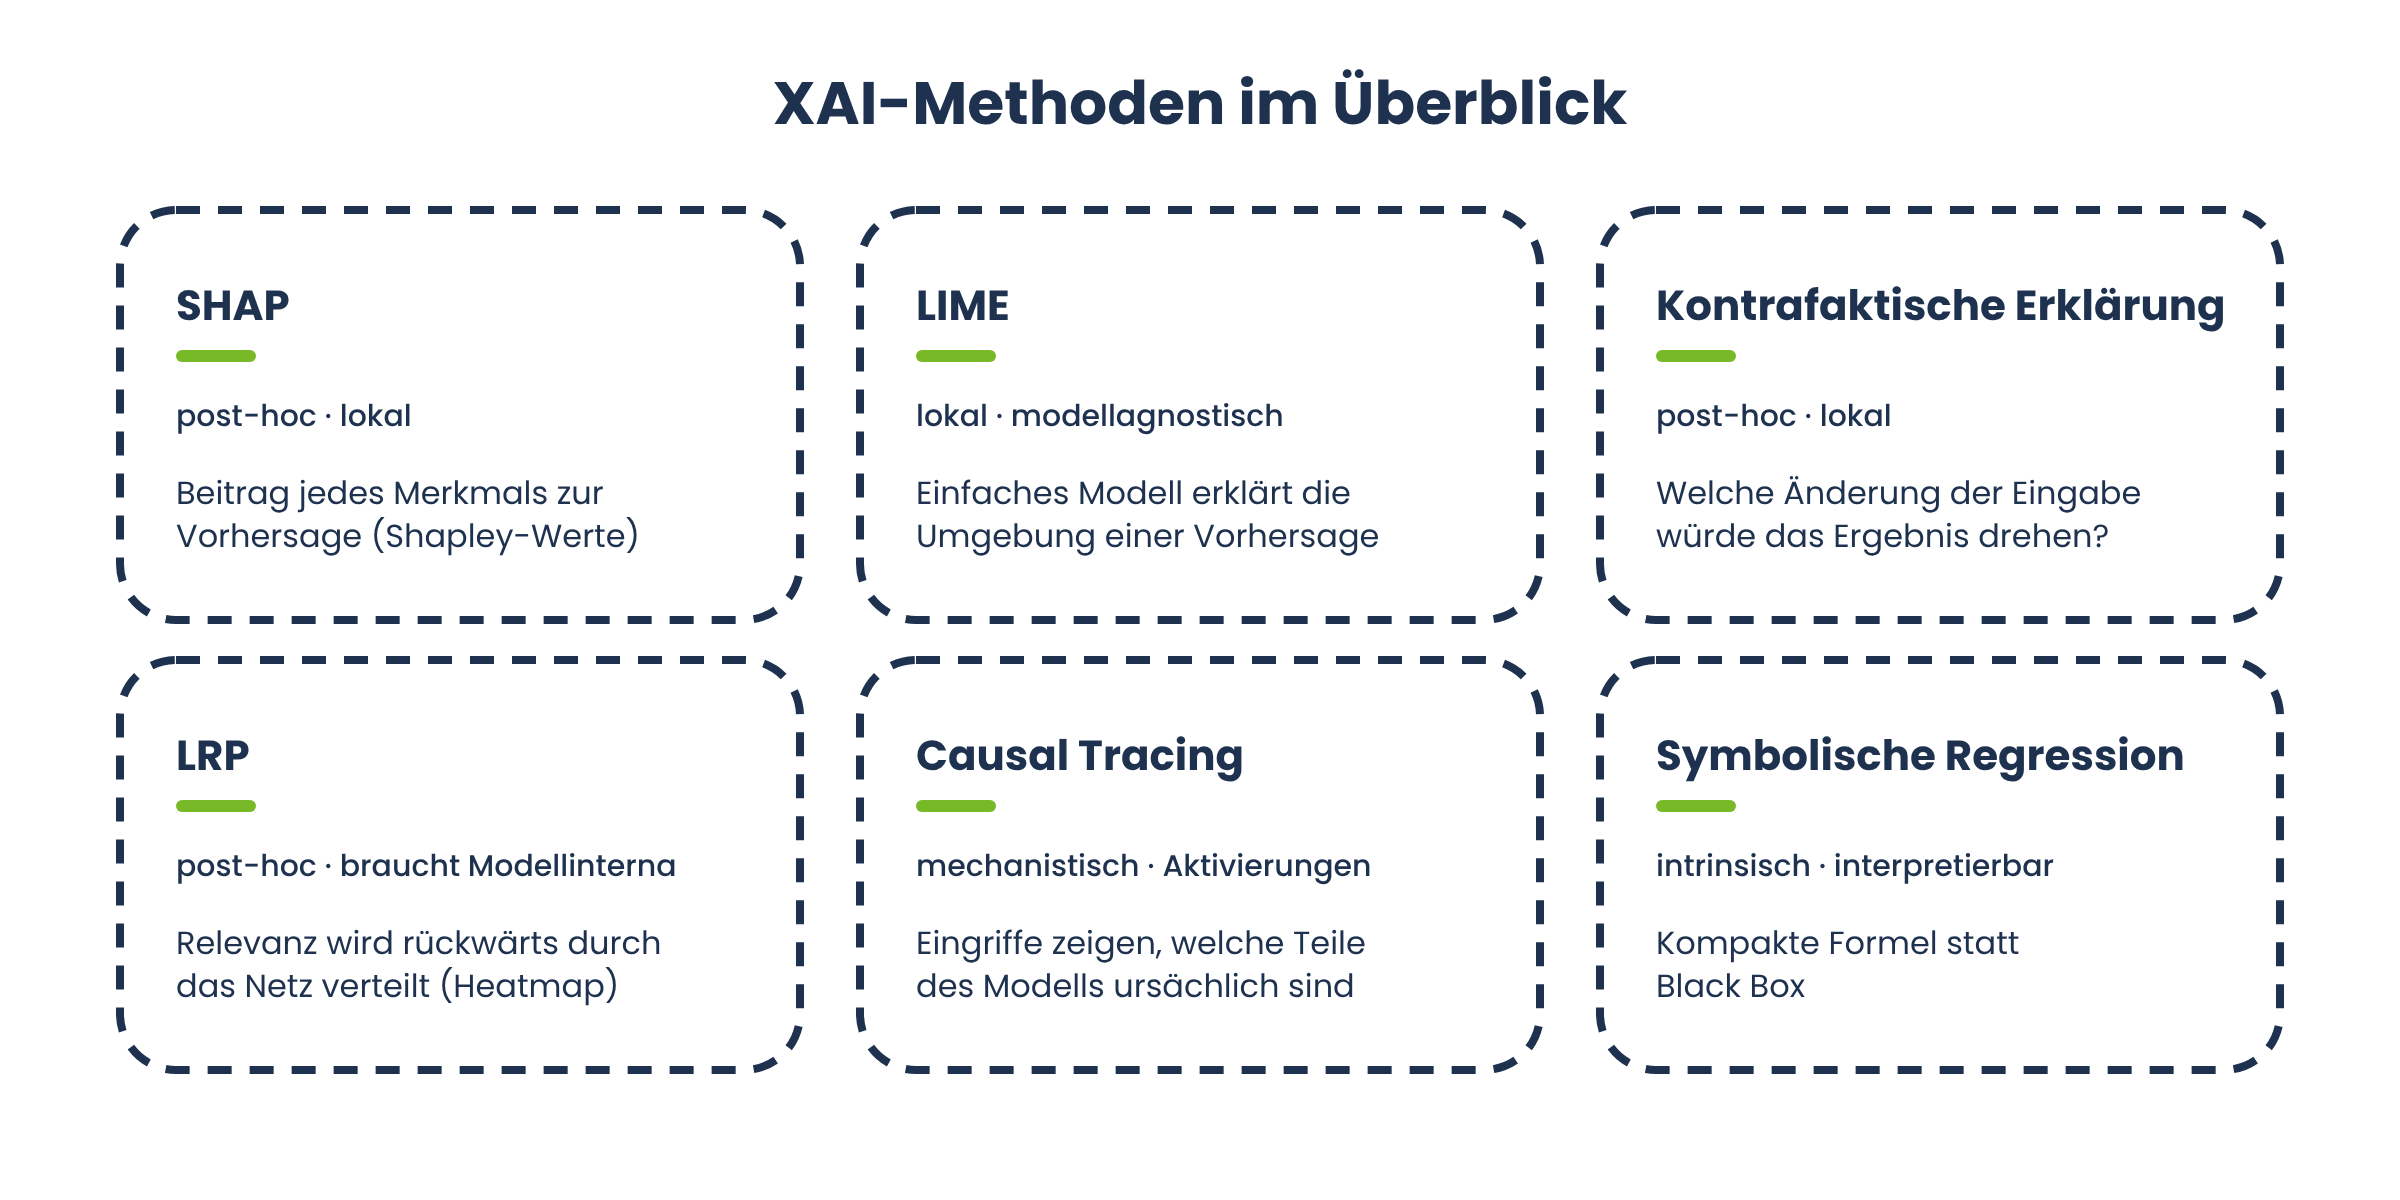
Come funziona SHAP (Shapley Additive Explanations)?
SHAP è l'acronimo di Shapley Additive Explanations ed è uno dei metodi più diffusi nel campo dell'IA spiegabile. L'approccio è stato sviluppato nel 2017 dai ricercatori Scott Lundberg e Su-In Lee, che hanno così presentato un quadro di riferimento unificato per l'interpretazione delle previsioni dei modelli (Lundberg & Lee, 2017).
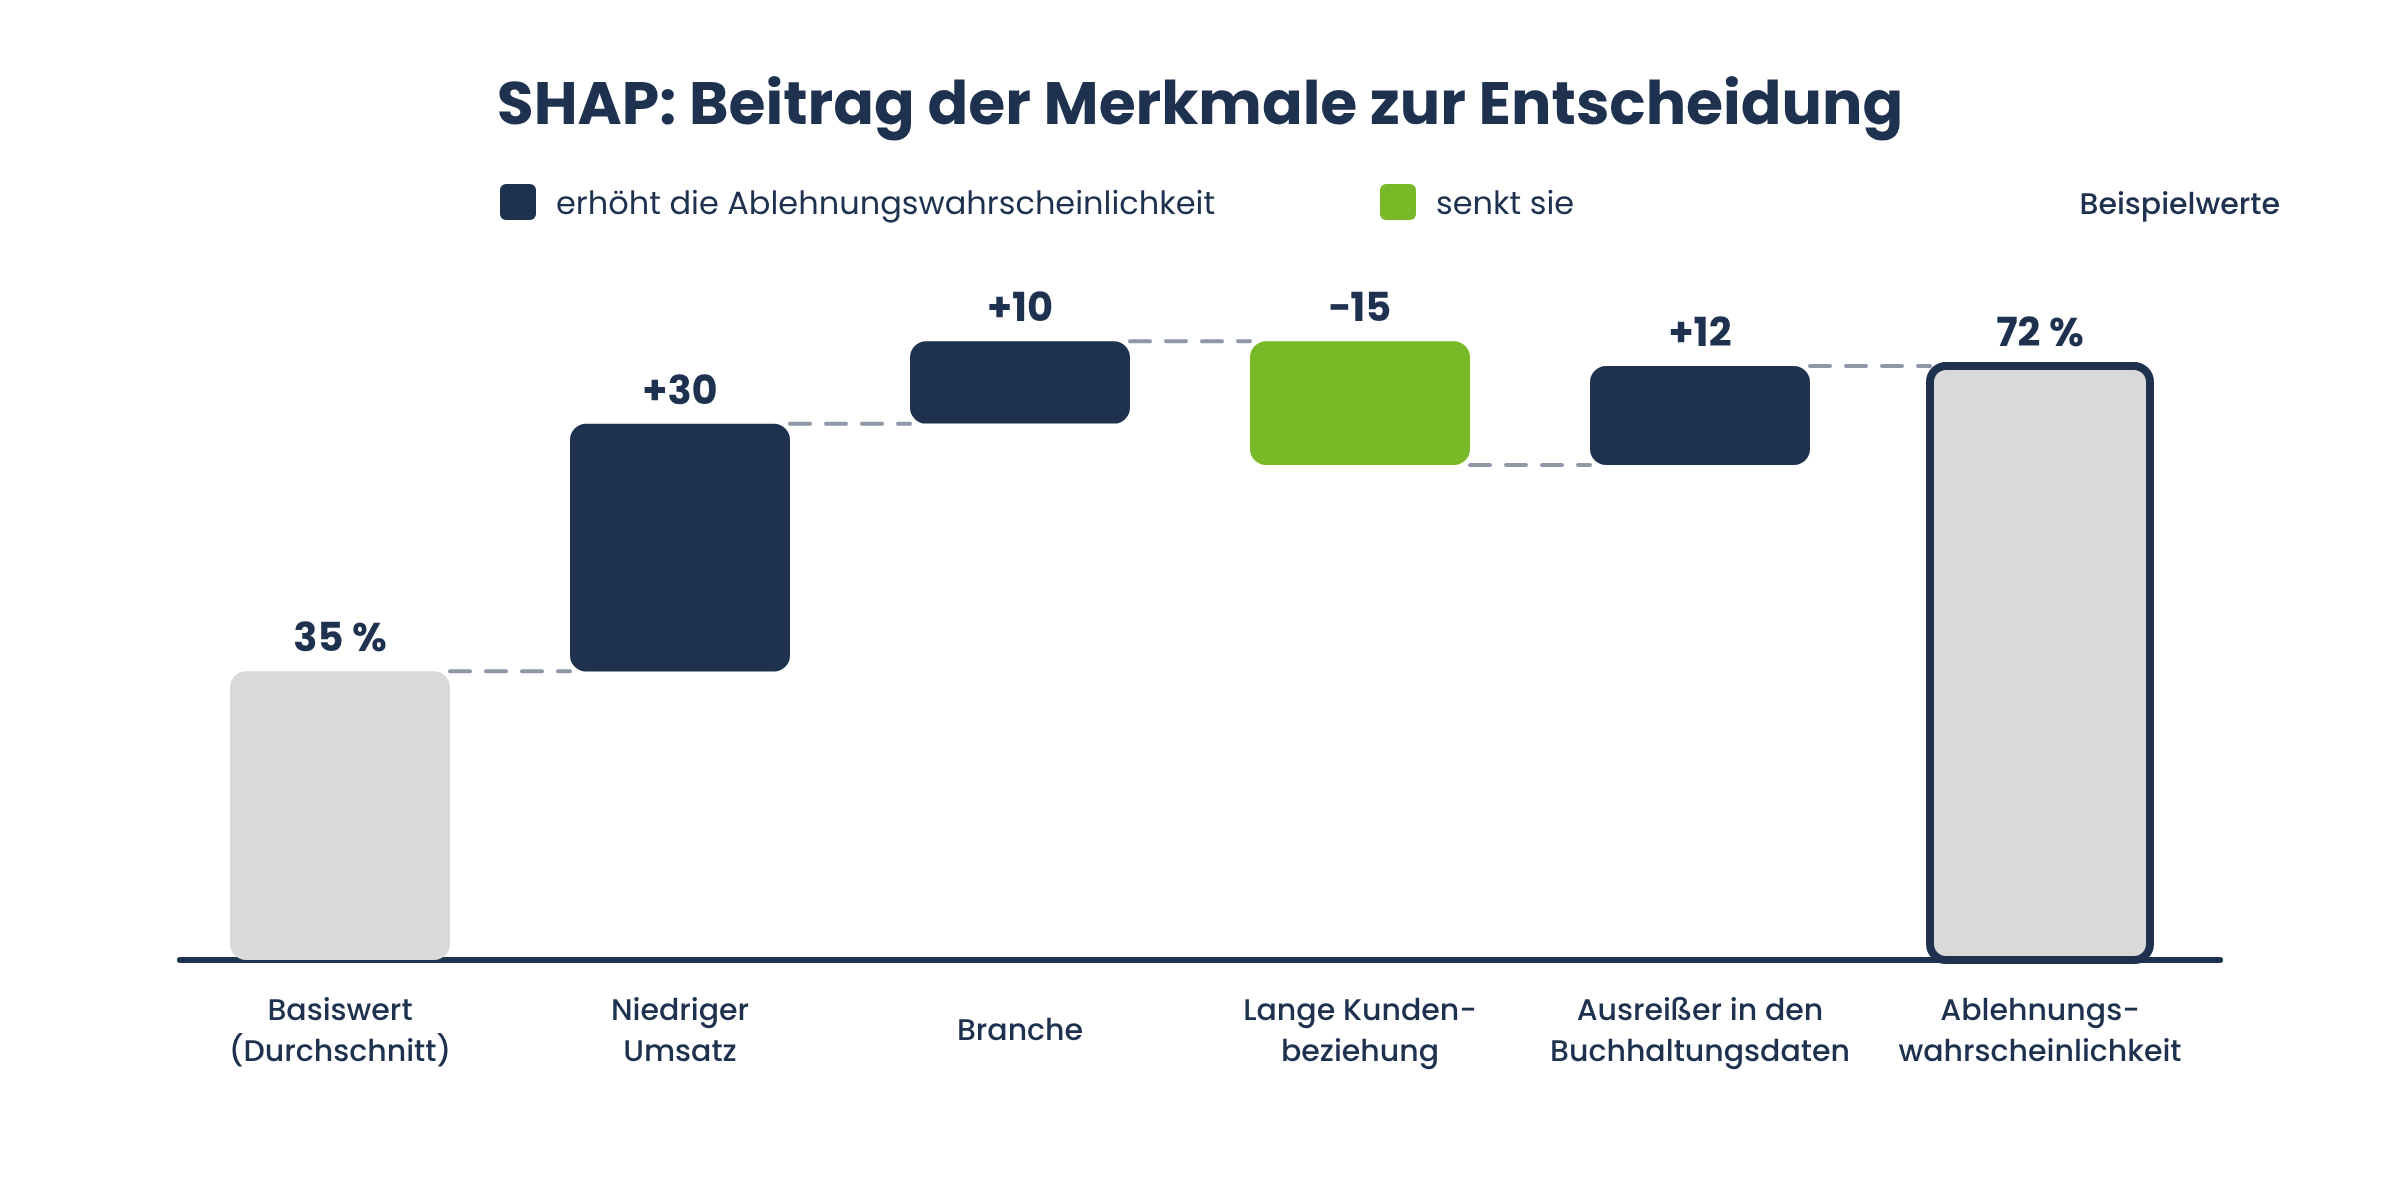
L’idea alla base di SHAP deriva dalla teoria dei giochi e si fonda sul cosiddetto valore di Shapley, che prende il nome dal matematico Lloyd Shapley. In origine, questo concetto serviva a calcolare la cosiddetta quota equa di ciascun giocatore nel profitto comune di una coalizione. SHAP trasferisce questo principio all’apprendimento automatico: ogni caratteristica di un set di dati viene trattata come un «giocatore» e SHAP calcola in che misura tale caratteristica abbia contribuito alla previsione specifica, rispetto al valore medio di tutte le possibili combinazioni di caratteristiche.
Il risultato è un valore SHAP per ogni caratteristica e previsione. I valori positivi indicano che una caratteristica ha spostato la previsione in una determinata direzione, mentre quelli negativi indicano il contrario. In pratica, ciò consente di scomporre in modo comprensibile la richiesta di credito menzionata all’inizio: il fatturato basso ha aumentato la probabilità di rifiuto di X punti percentuali, mentre la lunga relazione con il cliente l’ha invece ridotta di Y punti percentuali.
Un vantaggio particolare di SHAP risiede nelle sue proprietà teoriche: l’accuratezza locale, la coerenza e il corretto trattamento dei valori mancanti sono matematicamente garantiti. Ciò distingue SHAP da molti metodi di importanza delle caratteristiche più datati, che non soddisfano queste proprietà. Il prezzo da pagare è il carico computazionale: un calcolo esatto di tutte le possibili combinazioni di caratteristiche è praticamente impossibile in presenza di un numero elevato di caratteristiche, motivo per cui nella pratica si ricorre a metodi più efficienti come Kernel SHAP o Tree SHAP. Quest’ultimo è stato sviluppato appositamente per modelli basati su alberi, come le Random Forests o il Gradient Boosting.
Che cos’è LIME e in cosa si differenzia da SHAP?
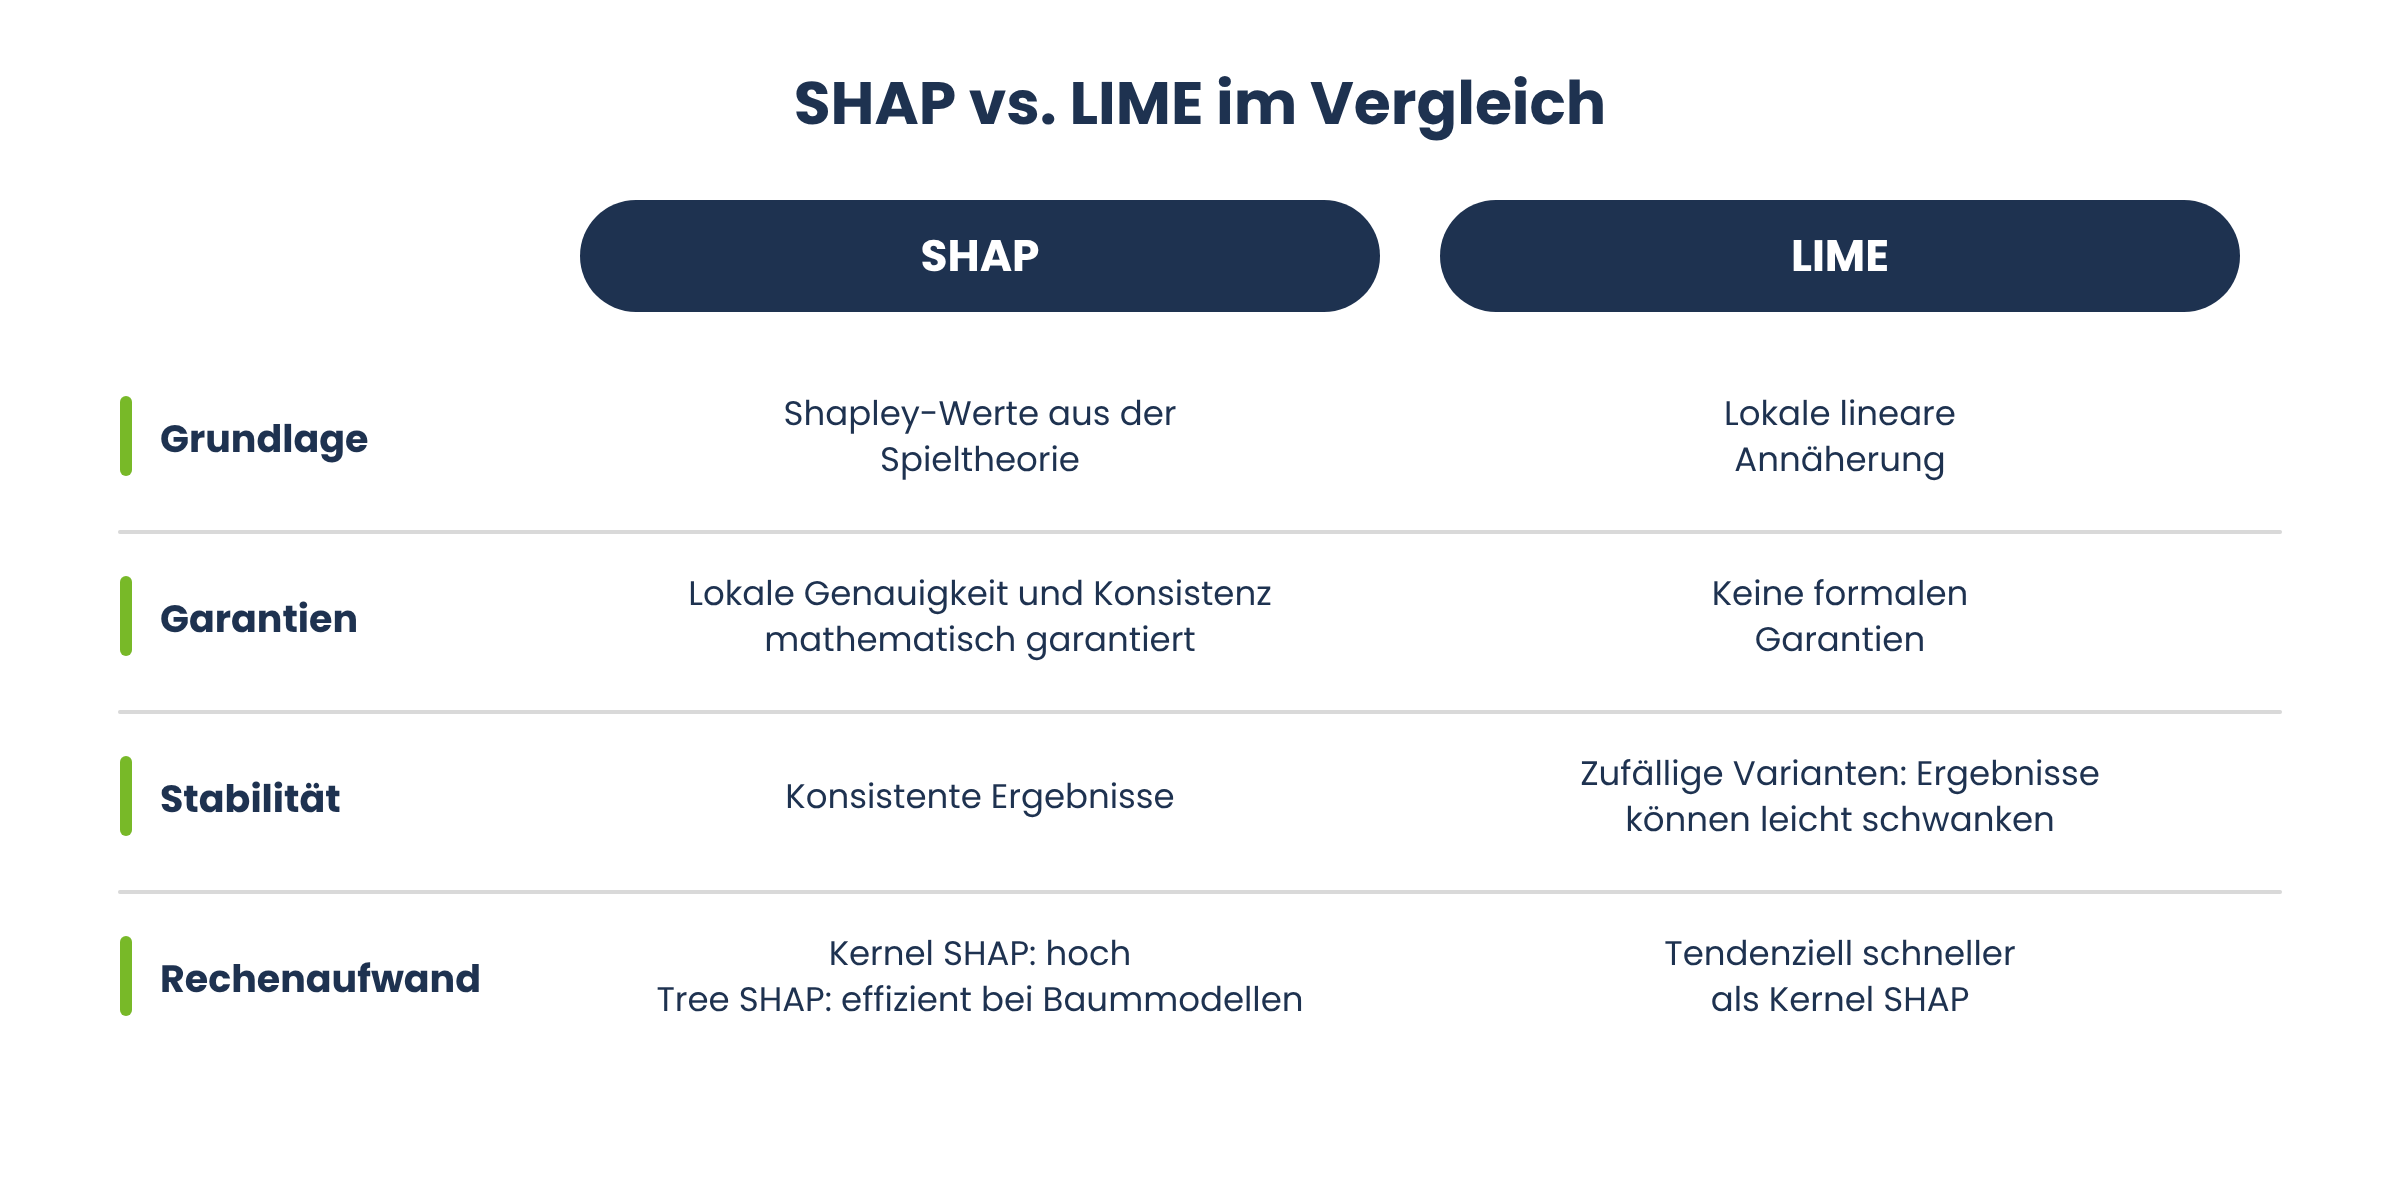
LIME è l'acronimo di Local Interpretable Model-agnostic Explanations ed è stato presentato nel 2016 da Marco Tulio Ribeiro, Sameer Singh e Carlos Guestrin (Ribeiro et al., 2016). Come suggerisce il nome, LIME è locale (spiega singole previsioni), interpretabile (la spiegazione stessa è di facile comprensione) e indipendente dal modello (richiede solo l’accesso alla funzione di previsione del modello, non alla sua struttura interna).
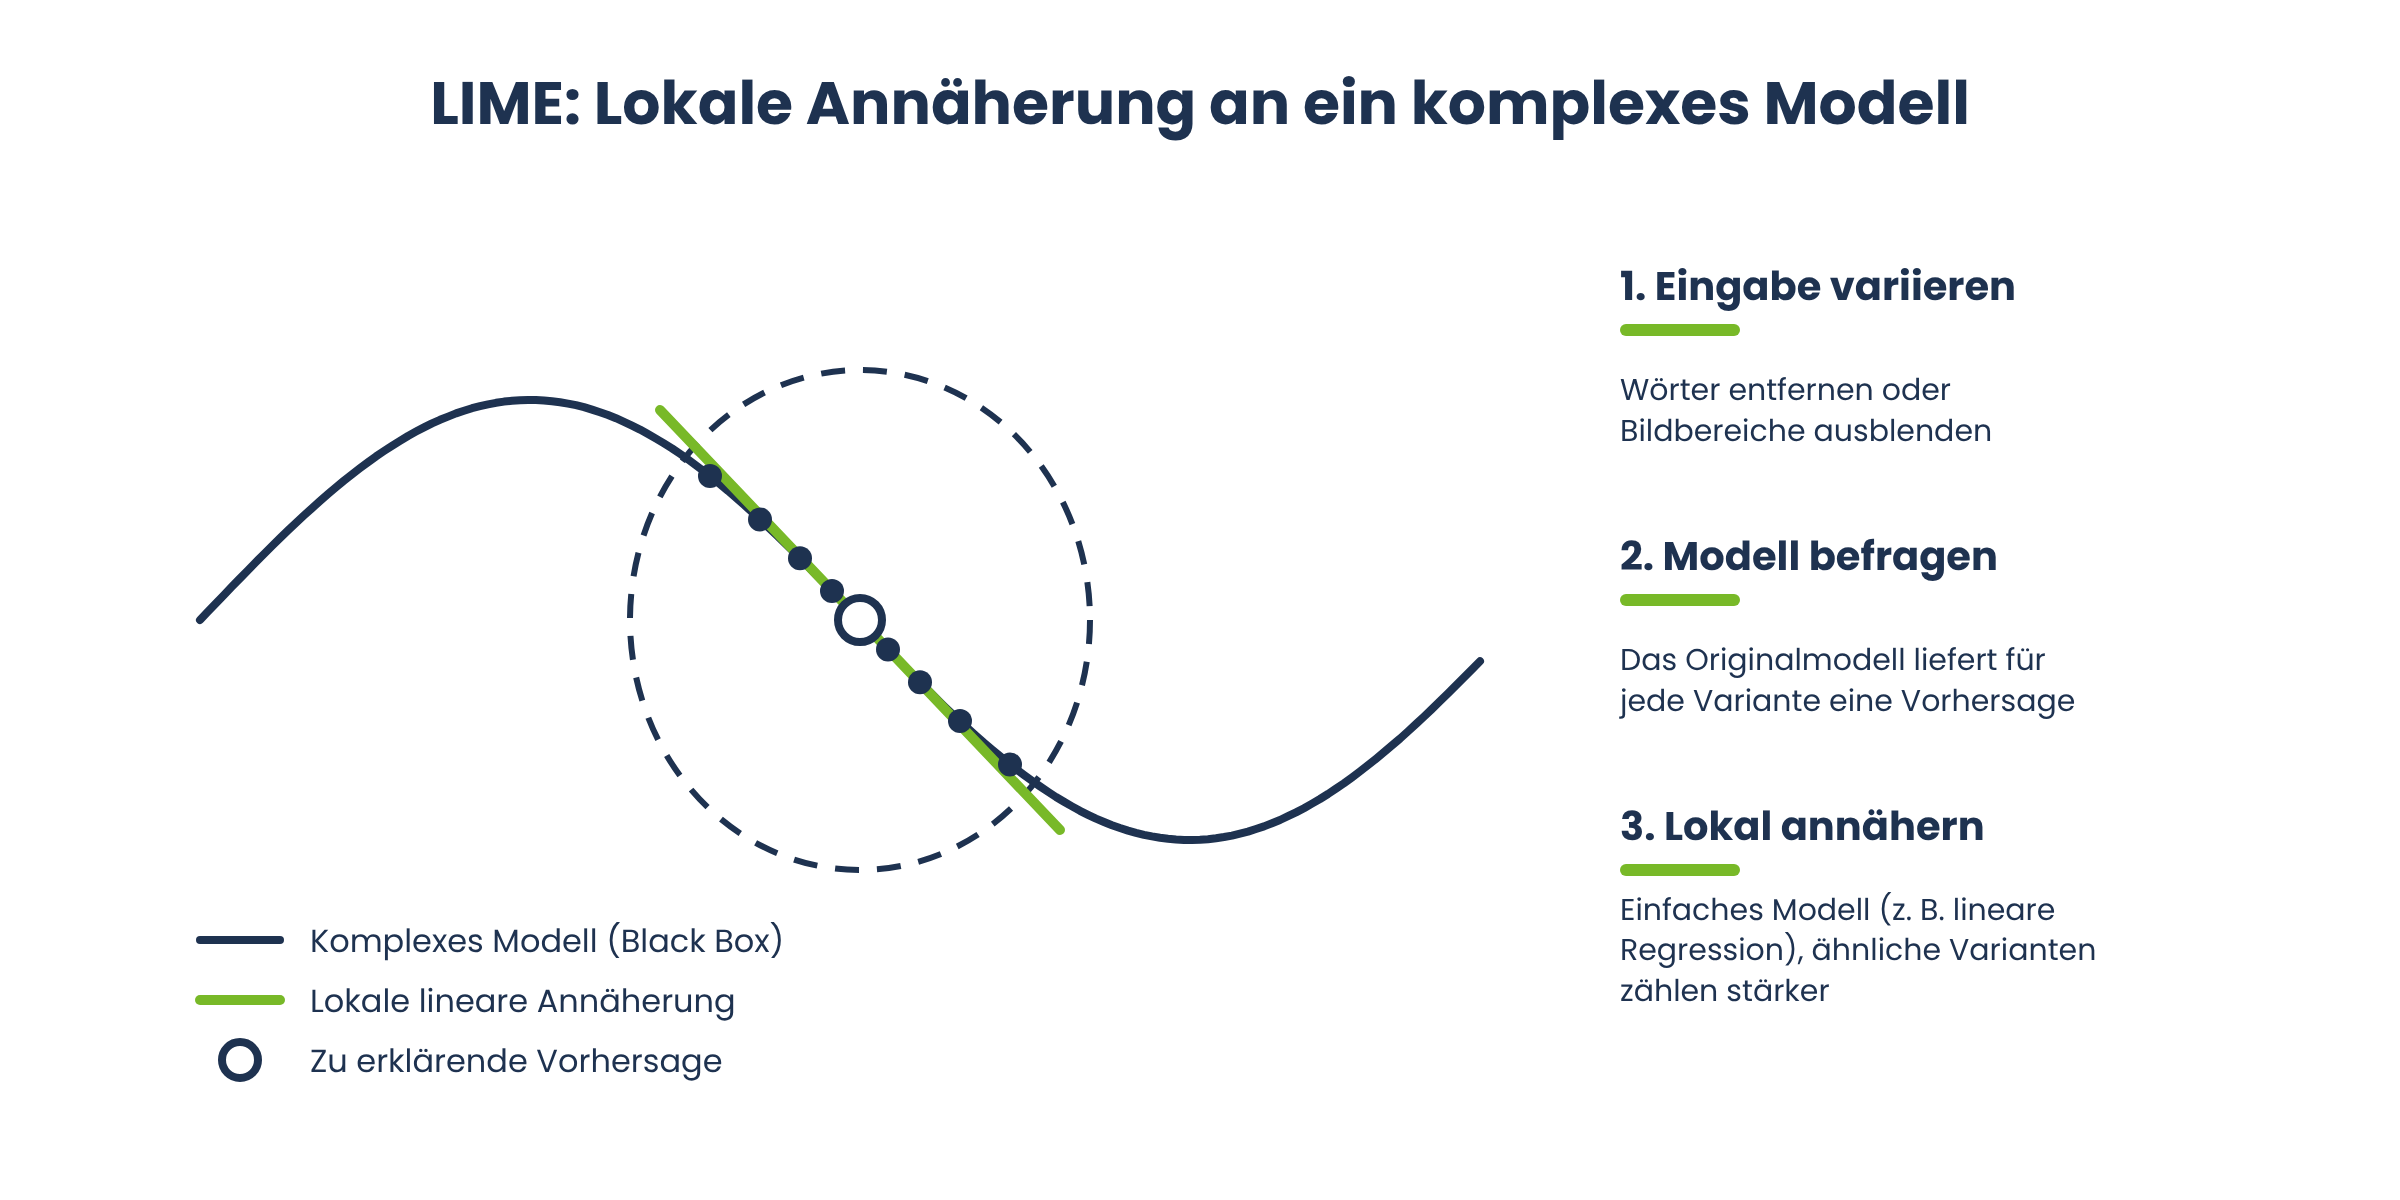
Il funzionamento di LIME può essere spiegato in modo chiaro: per spiegare una singola previsione, LIME genera innanzitutto varianti leggermente modificate dell’input originale – ad esempio, rimuovendo singole parole da un testo o nascondendo singole aree di un’immagine. Per ciascuna di queste varianti, LIME richiede al modello originale una previsione. Successivamente, su questi dati generati artificialmente viene addestrato un modello semplice e facilmente interpretabile, solitamente una regressione lineare. In questo processo, le varianti più simili all’input originale hanno un peso maggiore. Questo modello semplice approssima il comportamento del complesso modello originale, ma solo a livello locale, ovvero nell’immediata vicinanza della previsione da spiegare.
La differenza fondamentale rispetto a SHAP risiede nel fondamento teorico. Mentre SHAP si basa sui valori di Shapley, fondati sulla teoria dei giochi, e garantisce così determinate proprietà di coerenza, LIME opera con un’approssimazione locale e lineare senza queste garanzie formali. Poiché LIME genera in modo casuale le varianti dell’input, le spiegazioni possono inoltre variare leggermente da un’esecuzione all’altra. In pratica ciò significa che LIME tende ad essere più veloce da calcolare e intuitivamente comprensibile, mentre SHAP fornisce risultati più coerenti e teoricamente più fondati. Il vantaggio in termini di velocità di LIME vale tuttavia soprattutto rispetto al kernel SHAP, che non dipende dal modello. Nel caso dei modelli basati su alberi, Tree SHAP consente un calcolo molto efficiente. Molte aziende ricorrono quindi a entrambi i metodi in parallelo, a seconda del caso d’uso.
Cosa sono le spiegazioni controfattuali (Counterfactual Explanations)?
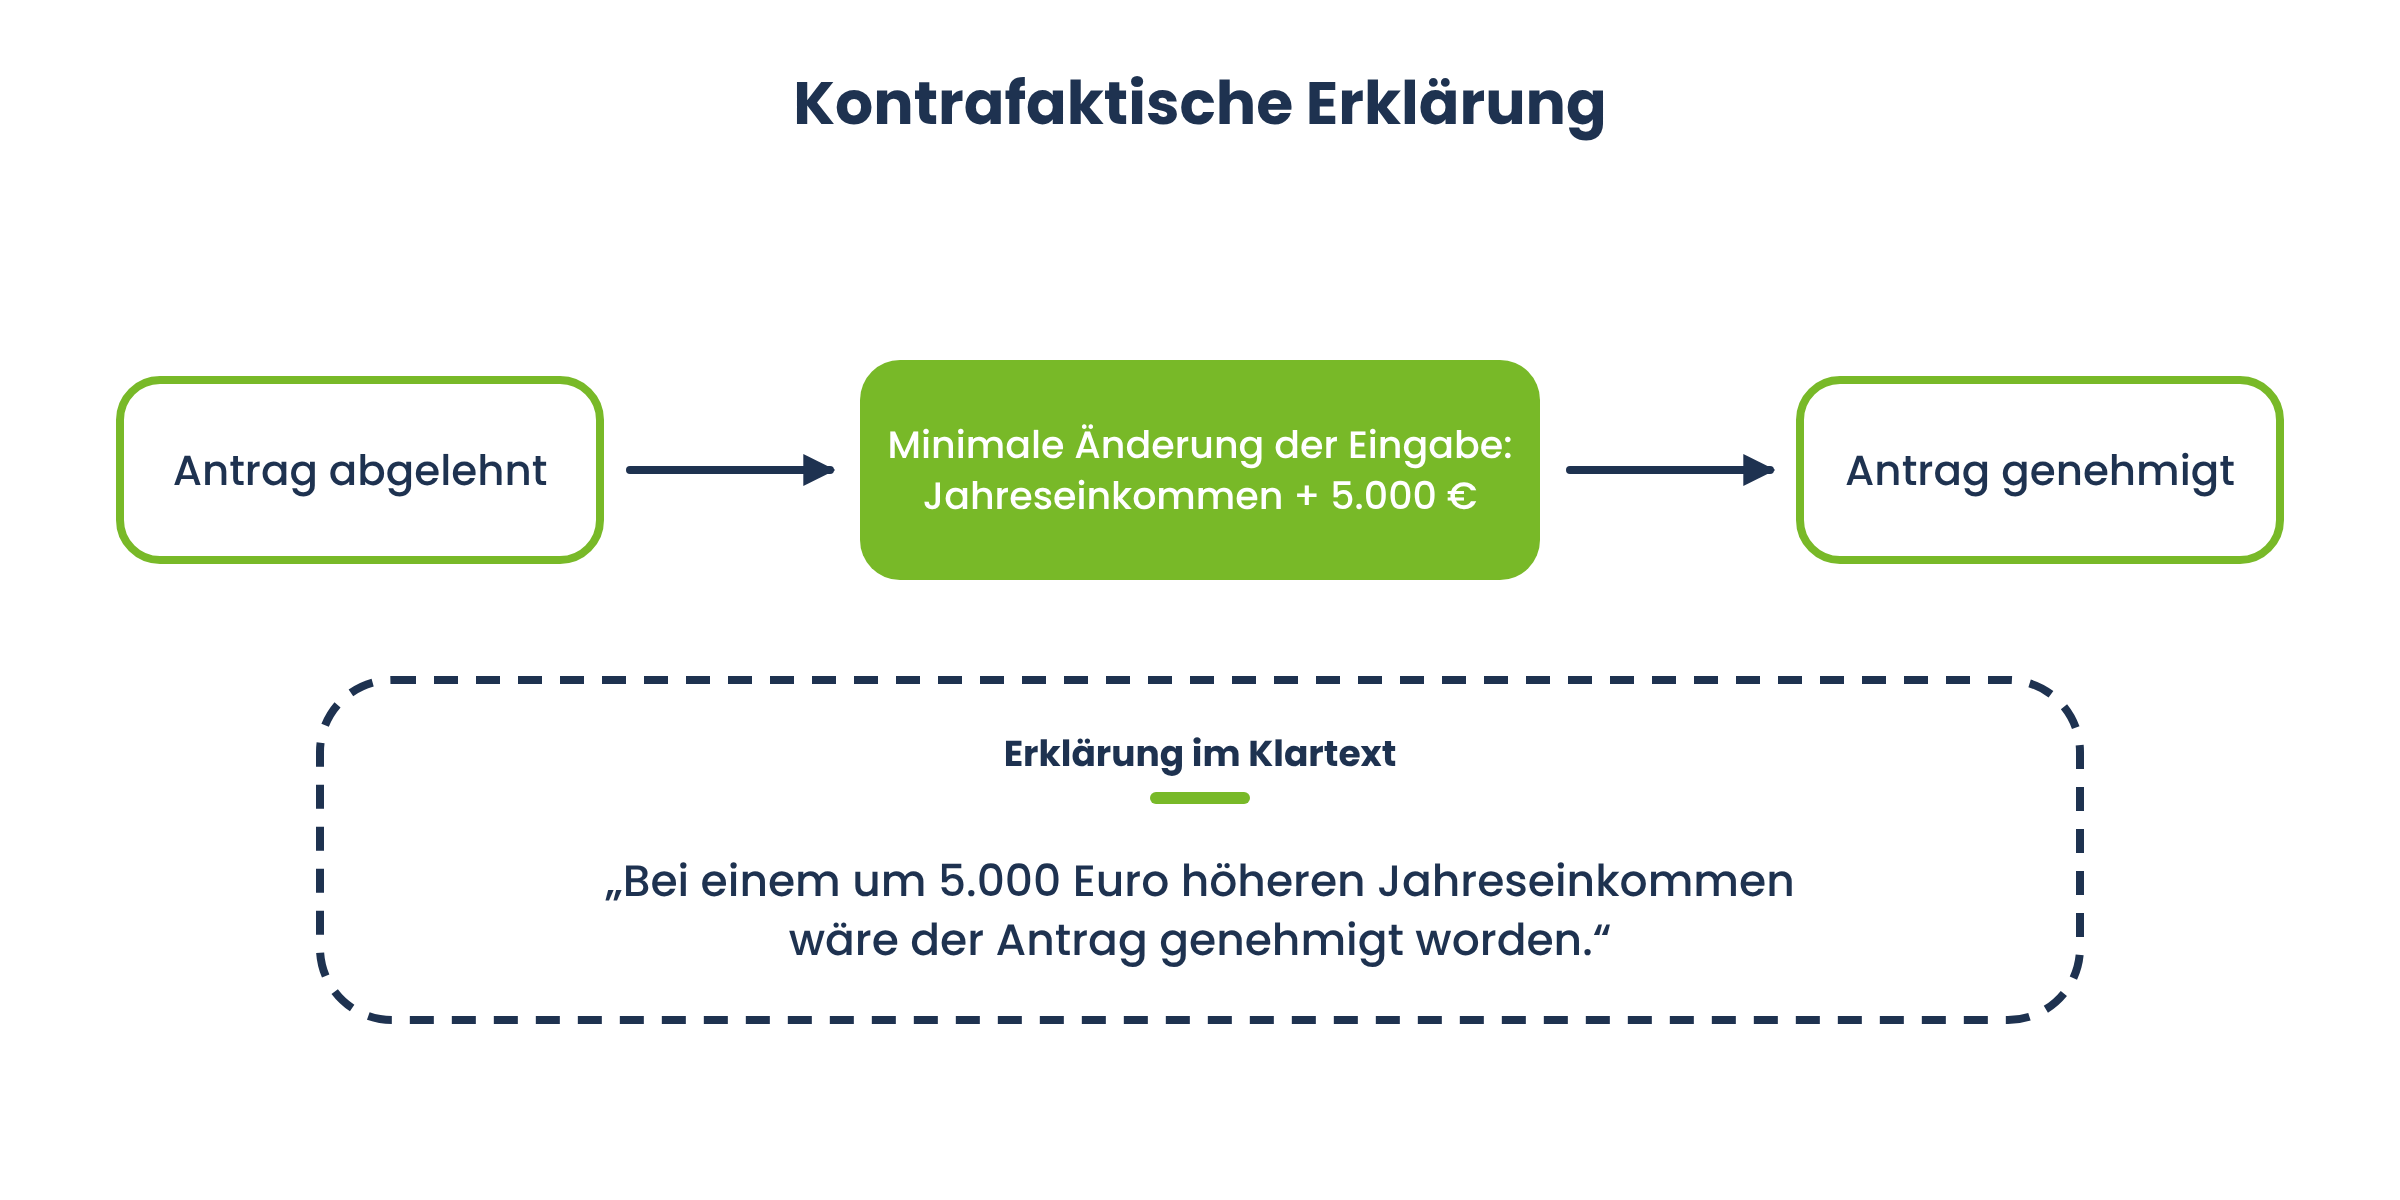
Le spiegazioni controfattuali, in inglese "Counterfactual Explanations", seguono un approccio diverso rispetto a SHAP o LIME: invece di mostrare in che misura le singole caratteristiche abbiano contribuito a una previsione, rispondono alla domanda su quale modifica minima dei dati di input avrebbe portato a un risultato diverso.
Un esempio chiarisce meglio il principio: se una richiesta di credito è stata respinta, una spiegazione controfattuale fornisce un’affermazione del tipo «Con un reddito annuo superiore di 5.000 euro, la richiesta sarebbe stata approvata». Questa forma di spiegazione è particolarmente preziosa perché non solo è comprensibile, ma, idealmente, induce anche all’azione: il richiedente viene a sapere concretamente quale parametro dovrebbe modificare per ottenere un risultato diverso.
Da un punto di vista tecnico, gli algoritmi per le spiegazioni controfattuali individuano il dato più simile che verrebbe classificato dal modello in modo diverso rispetto a quello originale. In questo contesto, si cerca in genere di modificare il minor numero possibile di caratteristiche, che siano il più realistiche possibile, affinché la spiegazione rimanga praticabile. Un’importante limitazione: le spiegazioni controfattuali mostrano sì quale modifica dell’input cambierebbe il risultato, ma non spiegano perché il modello reagisca in quel modo né quali processi interni ne siano alla base. A questa domanda risponde il «causal tracing», che verrà presentato nella sezione successiva.
Le spiegazioni controfattuali acquisiscono rilevanza pratica anche in ambito giuridico: i considerando del GDPR suggeriscono che gli interessati abbiano diritto a una spiegazione comprensibile delle decisioni automatizzate. Le spiegazioni controfattuali offrono una risposta praticabile, poiché sono comprensibili senza conoscenze tecniche preliminari.
Come funziona la Layer-wise Relevance Propagation (LRP)?
La Layer-wise Relevance Propagation, abbreviata in LRP, è stata sviluppata nel 2015 da Sebastian Bach e dal suo team ed è uno dei metodi più consolidati per la spiegazione delle reti neurali. Sviluppata inizialmente soprattutto per la classificazione delle immagini, oggi viene impiegata anche con altri tipi di dati, come il testo (Bach et al., 2015).
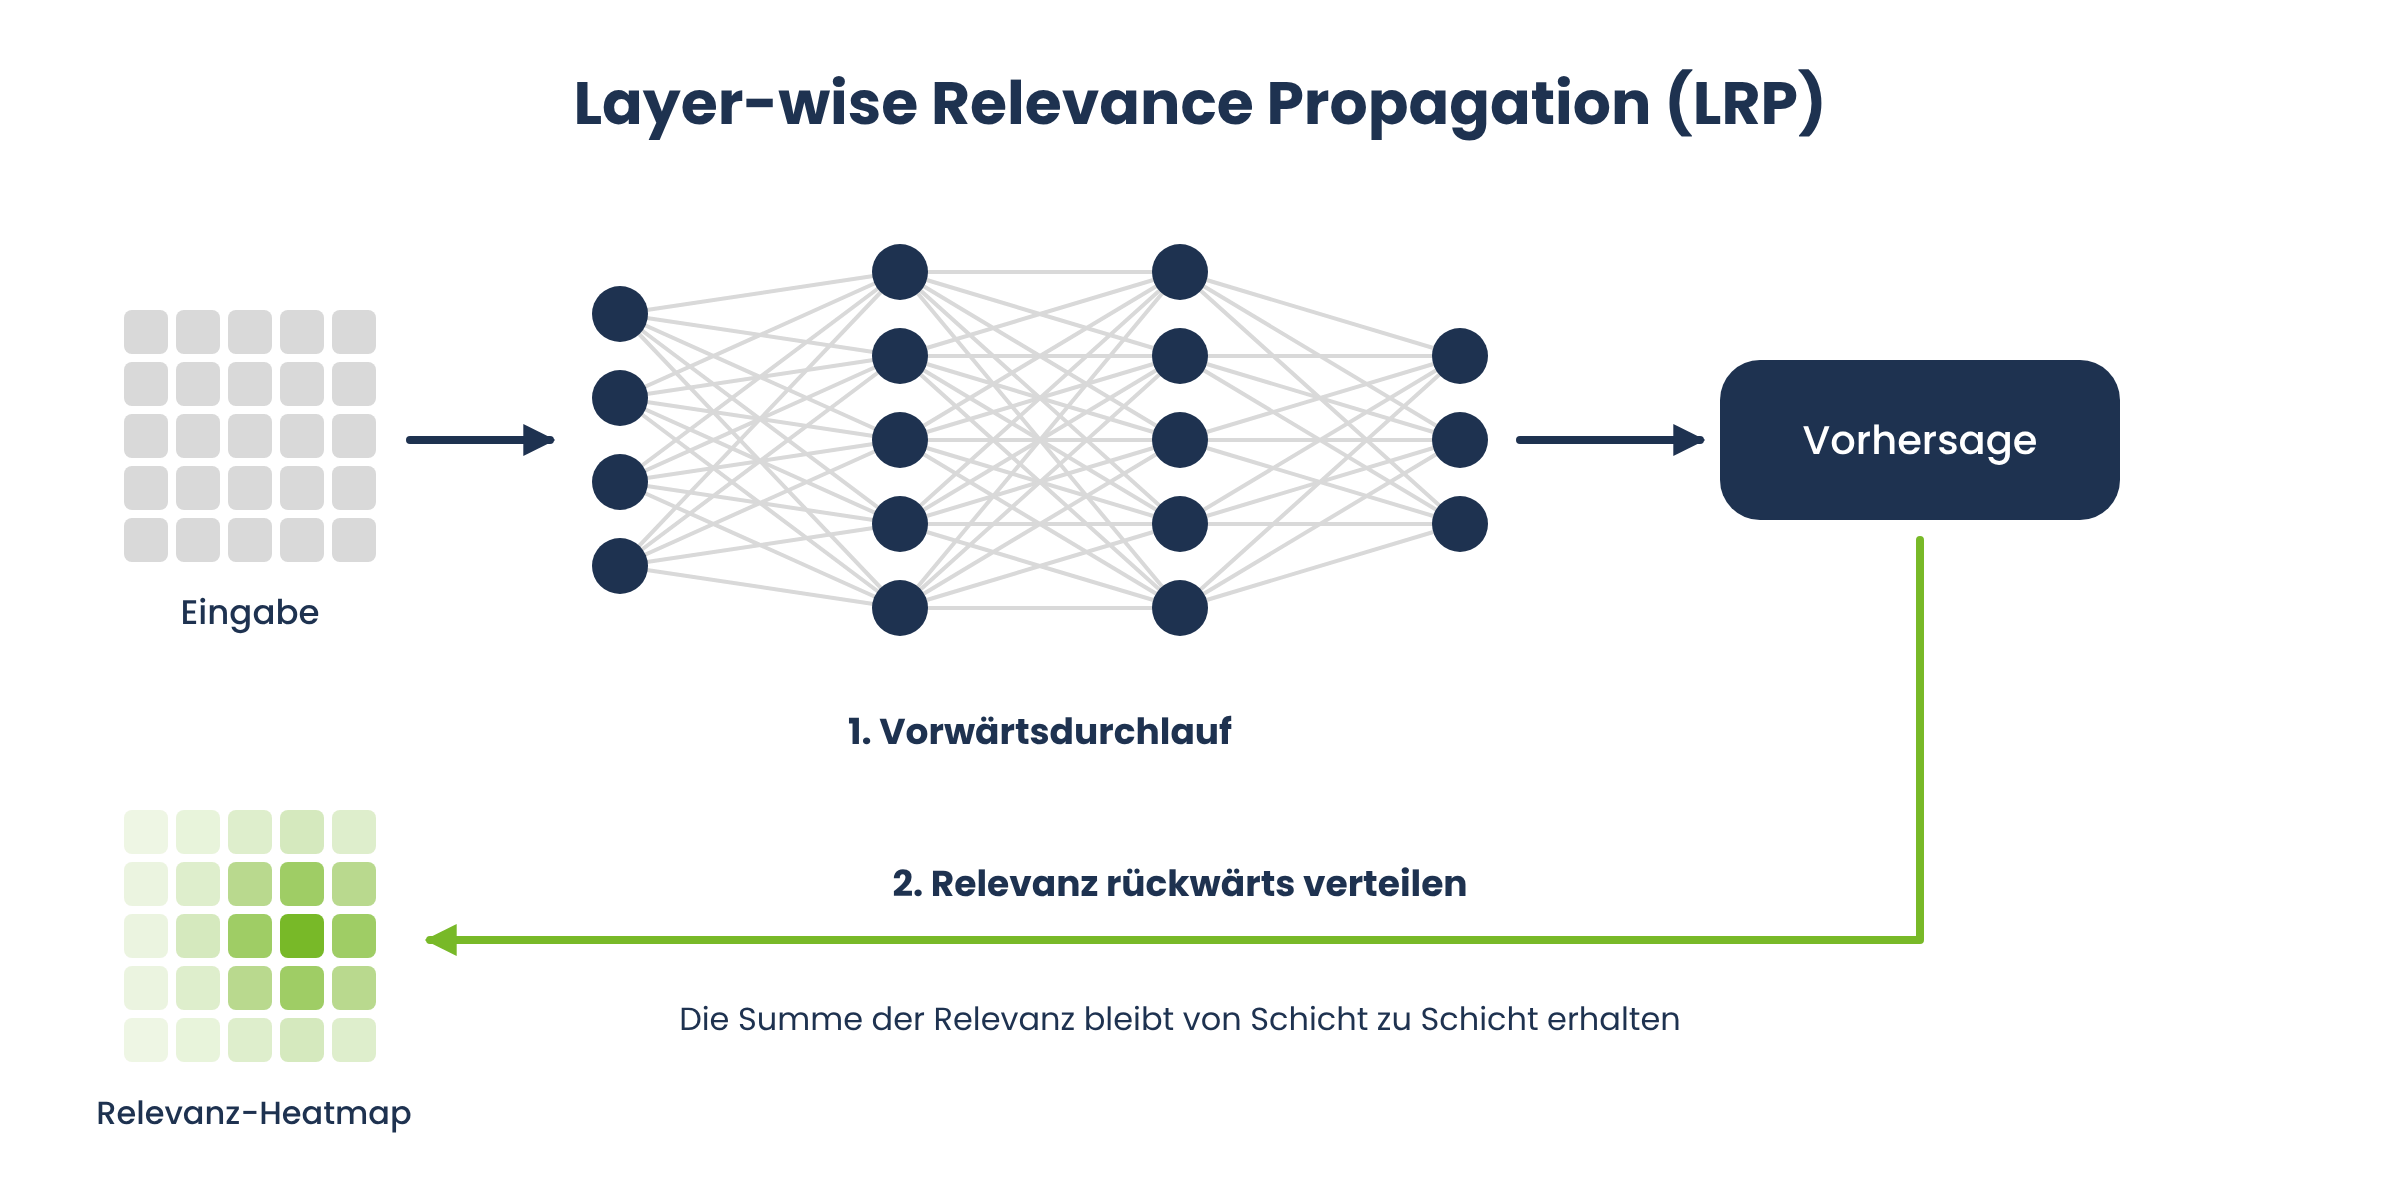
Il principio di base dell’LRP si differenzia nettamente dai metodi indipendenti dal modello, come LIME e Kernel SHAP: invece di osservare il modello dall’esterno e trarre conclusioni alterando i dati di input, l’LRP sfrutta la struttura interna della rete neurale stessa. Dopo una normale passata in avanti, durante la quale la rete calcola la propria previsione, il valore di output viene «ridistribuito» a ritroso attraverso la rete, strato per strato. In questo modo, ogni nodo riceve un valore di rilevanza che indica in che misura ha contribuito a quel valore di output. Questa rilevanza viene trasmessa di strato in strato secondo regole fisse, finché alla fine a ogni singolo pixel di input o a ogni singola caratteristica di input viene assegnato un valore di rilevanza.
Un principio fondamentale dell’LRP è la cosiddetta conservazione della rilevanza: la somma dei valori di rilevanza rimane sostanzialmente la stessa da uno strato all’altro e corrisponde al valore di output originale. Il risultato può essere visualizzato in modo particolarmente chiaro nei classificatori di immagini, sotto forma di mappa termica che mostra quali aree dell’immagine hanno influito maggiormente a favore o contro la decisione del modello. Nell’analisi delle immagini mediche, ad esempio, una tale mappa termica può mostrare quali regioni di una risonanza magnetica abbiano influenzato in modo determinante la valutazione del modello, consentendo ai medici una verifica immediata della plausibilità.
Rispetto ai semplici metodi basati sui gradienti, l’LRP è considerato meno soggetto a spiegazioni rumorose ed effetti di saturazione: i gradienti misurano quanto il valore di output reagisca a piccole variazioni dell’input, mentre l’LRP distribuisce il valore di output stesso sulle caratteristiche di input. L’efficacia di questo approccio nella pratica dipende tuttavia dalla regola di propagazione scelta. Lo svantaggio: l’LRP richiede l’accesso all’architettura interna e ai pesi del modello e, a differenza di LIME o Kernel SHAP, non può essere utilizzato in modo indipendente dal modello.
Che cos’è il causal tracing e in che modo aiuta a comprendere i modelli di IA?
Mentre SHAP, LIME e LRP mostrano principalmente quali caratteristiche di input contribuiscono a una previsione e in che misura, il causal tracing persegue un obiettivo diverso: attraverso interventi mirati su un modello, mira a chiarire quali componenti interne siano la causa di un determinato comportamento del modello, e non solo quali caratteristiche siano correlate alla previsione.
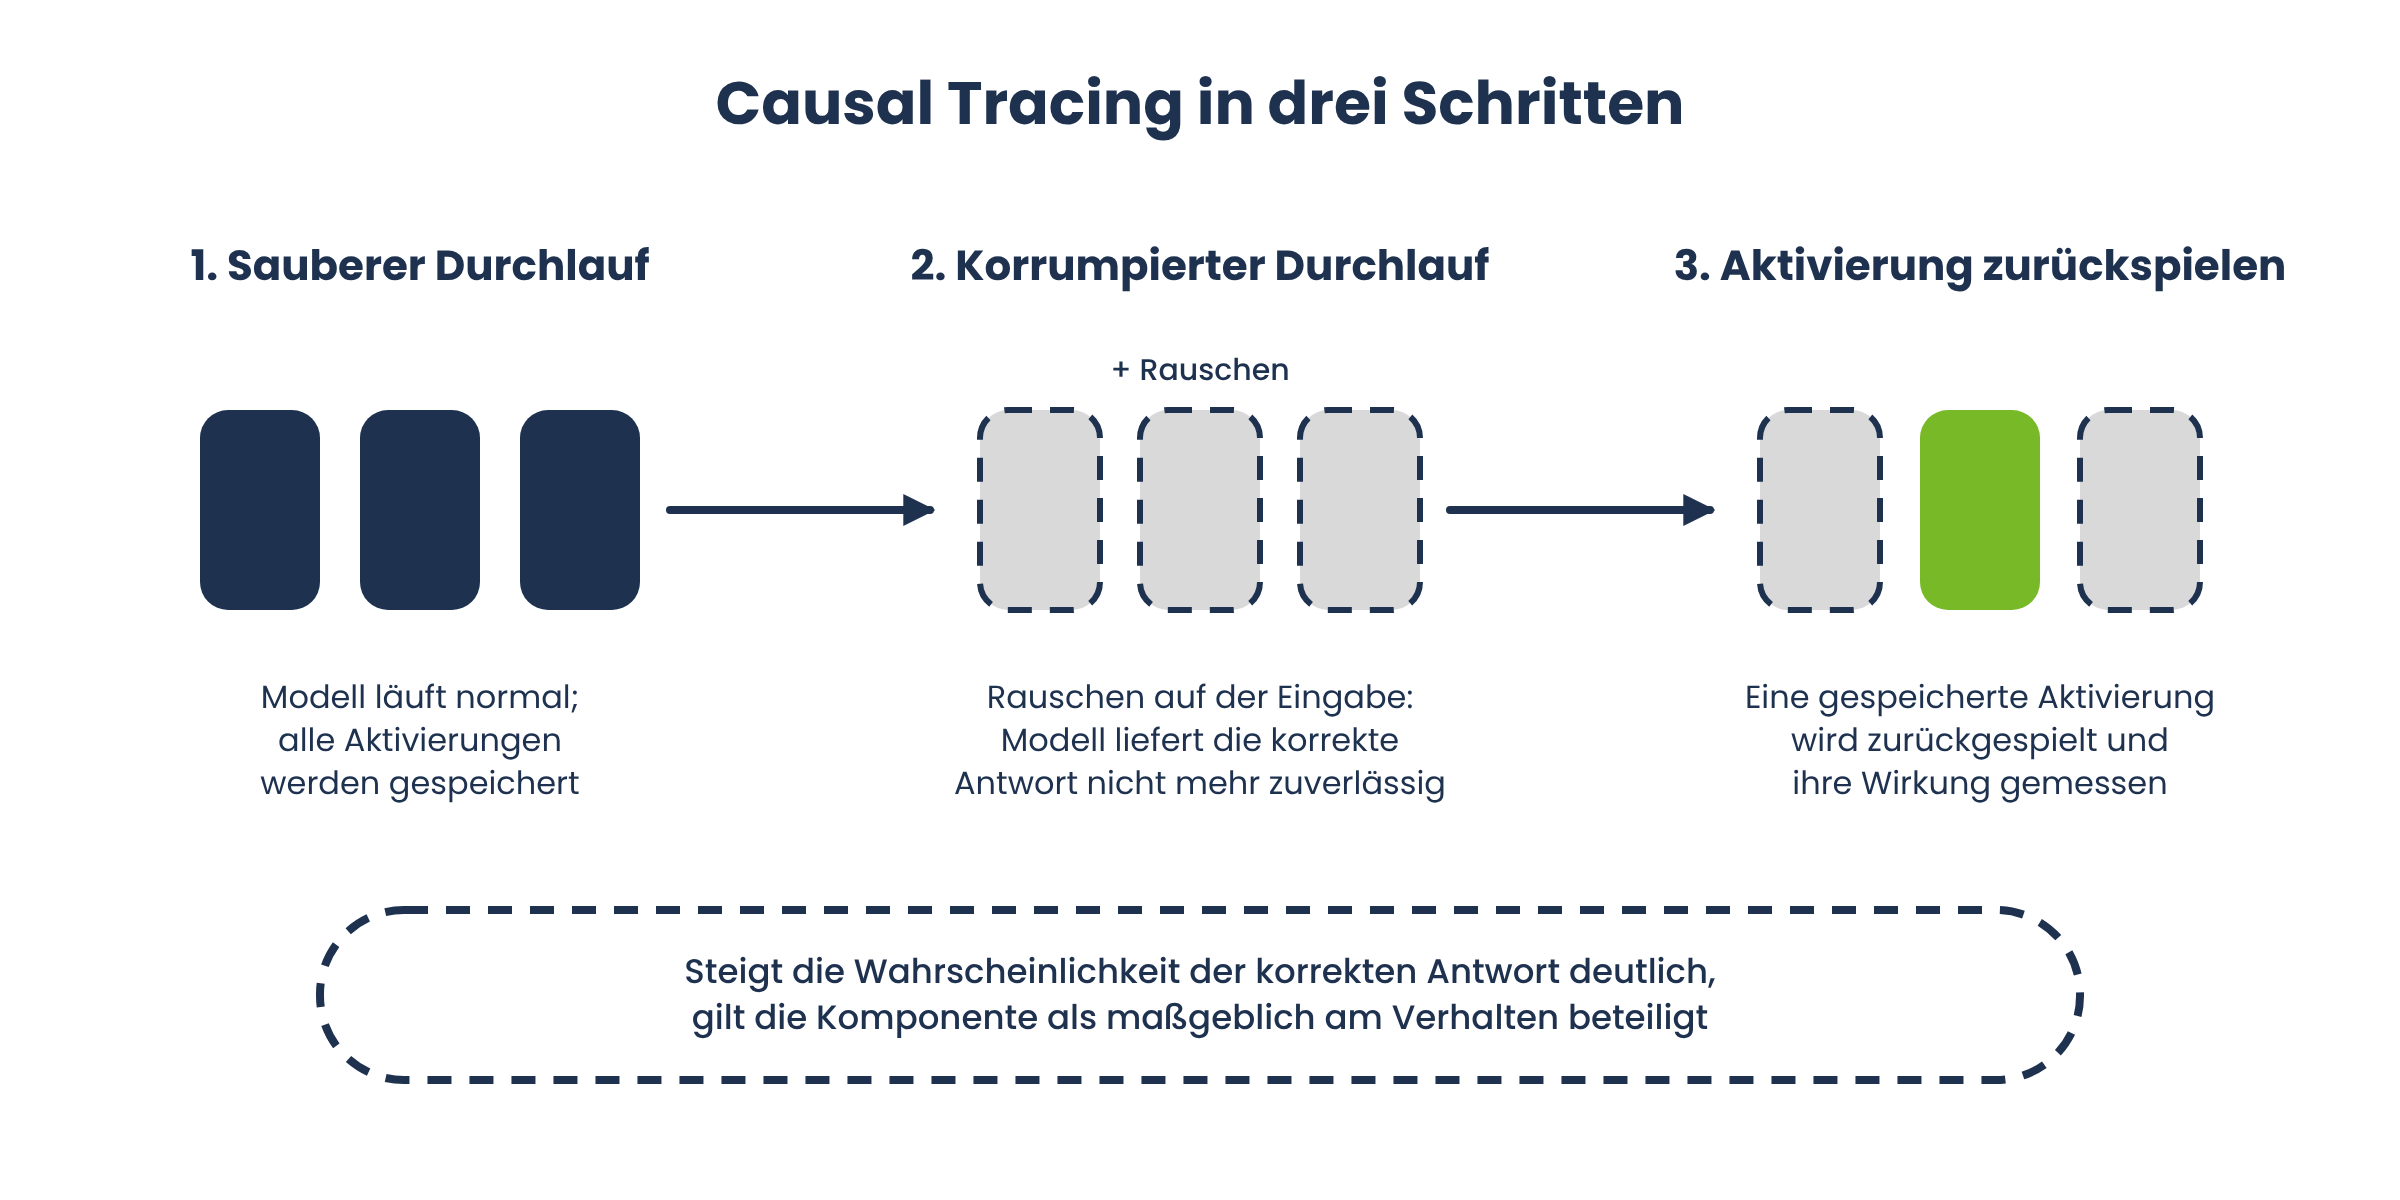
Questo metodo è diventato famoso soprattutto grazie al lavoro di ricerca di Kevin Meng e del suo team sull’analisi dei modelli linguistici (Meng et al., 2022). Il procedimento si articola in tre fasi: innanzitutto viene eseguito un ciclo “pulito” con il modello, durante il quale vengono memorizzate tutte le attivazioni interne. Successivamente viene avviato un ciclo «corrotto», durante il quale viene aggiunto in modo mirato del rumore agli input, in modo che il modello non sia più in grado di prevedere in modo affidabile la risposta corretta. Nella terza fase, una singola attivazione salvata viene reimmessa dal ciclo pulito in quello corrotto. Se ciò aumenta significativamente la probabilità di una previsione corretta, tale componente è considerata determinante nel comportamento studiato.
In questo modo è possibile, ad esempio, individuare quali componenti di un modello linguistico siano determinanti nel recupero di conoscenze fattuali. Queste scoperte non sono interessanti solo dal punto di vista accademico: su di esse si basano procedure per la correzione mirata dei modelli, con le quali è possibile adeguare i pesi relativi a fatti obsoleti o errati senza dover addestrare nuovamente l’intero modello. Tuttavia, queste procedure sono ancora in fase di ricerca. Non è chiaro, infatti, quanto siano affidabili gli effetti di tali modifiche sui fatti correlati e se possano compromettere altre capacità del modello.
Per le aziende che integrano sempre più spesso i modelli linguistici nei propri processi, il «Causal Tracing» rappresenta un approccio interessante. Esso rende visibili quali componenti interne di un modello siano coinvolte in un determinato comportamento, andando così oltre la valutazione delle singole caratteristiche di input. È applicabile solo a modelli di cui è possibile accedere alle attivazioni interne, quindi non a modelli utilizzabili esclusivamente tramite un’API. Il «causal tracing» rientra nella cosiddetta interpretabilità meccanicistica. Questo campo di ricerca è ancora agli albori della sua applicazione pratica, ma è considerato da molti ricercatori una strada promettente per comprendere meglio il funzionamento interno di modelli complessi.
Regressione simbolica: formule anziché “scatola nera”
Un approccio fondamentalmente diverso all’IA spiegabile non passa attraverso metodi di spiegazione a posteriori, ma attraverso modelli interpretabili fin dall’inizio. Un esempio è la regressione simbolica.
A differenza di molti modelli classici di apprendimento automatico, che ottimizzano i parametri di una struttura di modello predefinita, la regressione simbolica cerca autonomamente un’equazione matematica che descriva bene un insieme di dati e che rimanga il più semplice possibile. Il risultato non è una moltitudine di pesi in una rete neurale, ma, nel migliore dei casi, una formula compatta e leggibile per gli esperti – ad esempio una relazione del tipo «Il rischio di insolvenza aumenta proporzionalmente al grado di indebitamento e diminuisce con la durata del rapporto con il cliente».
Il grande vantaggio è evidente: nel migliore dei casi, un’equazione compatta può essere letta e compresa direttamente senza bisogno di ulteriori spiegazioni. Nelle discipline scientifiche la regressione simbolica viene utilizzata da tempo per ricavare relazioni fisiche dai dati di misurazione, che gli esperti verificano successivamente. Lo svantaggio: in caso di problemi molto complessi e ad alta dimensionalità, la regressione simbolica spesso non fornisce la stessa precisione predittiva dei modelli «black box» più complessi, poiché le relazioni non sempre possono essere rappresentate in una formula concisa. A ciò si aggiunge il fatto che la ricerca di formule adeguate richiede un elevato carico di calcolo e, in presenza di molte variabili di input, raggiunge rapidamente i propri limiti.
Per le aziende ciò significa che la possibilità di ricorrere alla regressione simbolica dipende innanzitutto dai dati e dal compito da svolgere. È adatta a insiemi di dati numerici gestibili, in cui la relazione possa essere rappresentata in modo plausibile sotto forma di formula, ad esempio in applicazioni sensibili dal punto di vista normativo o nel settore della ricerca e sviluppo. Se è richiesta anche la tracciabilità, ad esempio nelle applicazioni regolamentate, essa può rappresentare un’opzione accanto ad altri modelli interpretabili come le regressioni lineari o piccoli alberi decisionali.
Quali sono i requisiti normativi relativi all’IA spiegabile?
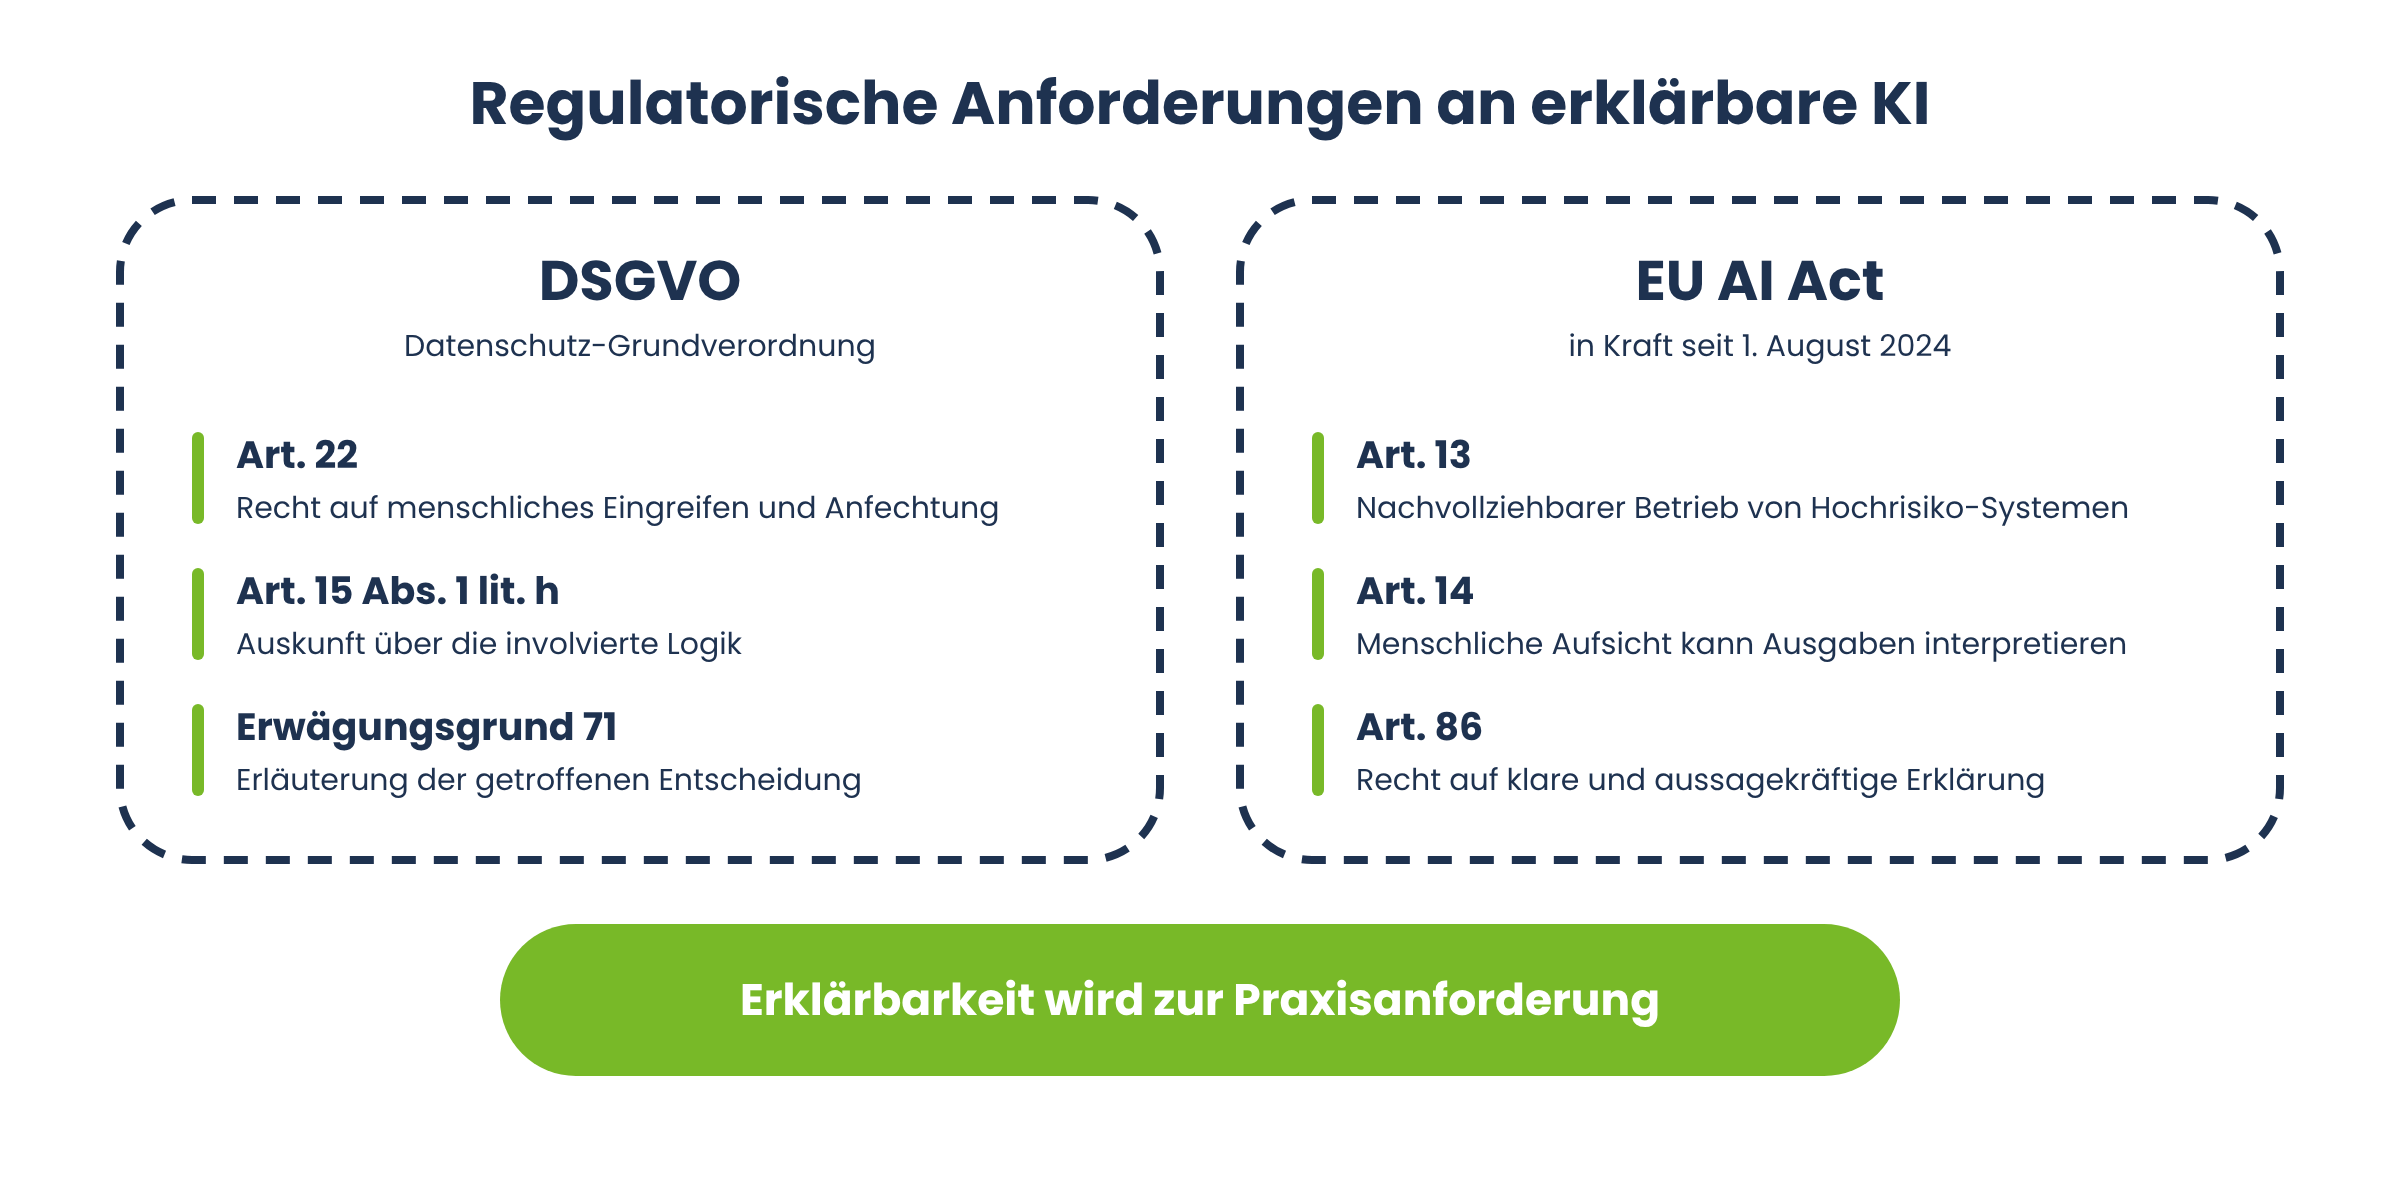
L'IA spiegabile non è più solo una best practice tecnica, ma è sempre più sancita dalla legislazione dell'Unione Europea. Due normative sono particolarmente rilevanti in questo contesto: il GDPR e l'EU AI Act.
Il GDPR e il diritto alla spiegazione
L'articolo 22 del Regolamento generale sulla protezione dei dati disciplina le decisioni automatizzate individuali, compresa la profilazione. In linea di principio, gli interessati hanno il diritto di non essere sottoposti esclusivamente a un trattamento automatizzato. Ciò vale qualora tale trattamento produca effetti giuridici o li pregiudichi in modo analogo (GDPR, art. 22). Laddove le decisioni automatizzate siano comunque ammesse, ad esempio sulla base di un consenso esplicito, l’articolo 22, paragrafo 3, prevede che le imprese adottino misure adeguate per tutelare i diritti dell’interessato – tra cui, come minimo, il diritto all’intervento umano, a esprimere il proprio punto di vista e a contestare la decisione.
Se il GDPR istituisca in tal modo un esplicito «diritto alla spiegazione» è oggetto di valutazioni divergenti nella letteratura giuridica specialistica. Un termine esplicito di questo tipo non compare nel testo normativo vincolante, ma è presente nel considerando 71, il quale suggerisce che gli interessati debbano ricevere una spiegazione della decisione adottata. Un ulteriore punto di riferimento è il diritto di accesso, che comprende informazioni significative sulla logica utilizzata (art. 15, comma 1, lett. h). In pratica, questa combinazione di diritti di accesso, diritti di opposizione e diritto all’intervento umano implica che le imprese abbiano di fatto bisogno di sistemi di IA spiegabili per operare in conformità con il GDPR.
La legge dell’UE sull’IA e i suoi obblighi di trasparenza
La legge dell’UE sull’IA, entrata in vigore il 1° agosto 2024 e i cui obblighi si applicano gradualmente da allora, è molto più concreta. Per i cosiddetti sistemi di IA ad alto rischio, ad esempio nel campo della valutazione del merito creditizio, della selezione del personale o delle infrastrutture critiche, l’articolo 13 prescrive la trasparenza. Tali sistemi devono essere progettati in modo tale che il loro funzionamento sia sufficientemente tracciabile. Gli operatori devono quindi essere in grado di interpretare e utilizzare in modo adeguato i risultati forniti dal sistema (Legge UE sull’IA, tema chiave: obblighi di trasparenza).
In concreto, la legge UE sull’IA richiede, tra l’altro, manuali d’uso comprensibili in cui siano documentate le capacità e i limiti del sistema, nonché meccanismi che consentano un’efficace supervisione umana. L’articolo 14 stabilisce inoltre che le persone incaricate della supervisione di un sistema ad alto rischio debbano essere in grado di interpretare correttamente i risultati del sistema. Questo requisito è difficilmente soddisfacibile nella pratica senza adeguati strumenti di IA spiegabile. A integrazione di ciò, l’articolo 86 garantirà in futuro alle persone interessate il diritto a una spiegazione chiara e significativa qualora una decisione presa da un sistema di IA ad alto rischio abbia un impatto significativo sulla loro vita. Sebbene questa norma entrerà pienamente in vigore solo in un secondo momento, essa indica la direzione verso cui si sta evolvendo la normativa europea in materia di IA: verso un diritto esplicito alla spiegazione.
Per le aziende ne deriva una chiara raccomandazione: chi oggi sviluppa o utilizza sistemi di IA per casi d’uso a rischio non dovrebbe limitarsi a integrare metodi di IA spiegabile solo poco prima dell’entrata in vigore di ulteriori obblighi. È preferibile pianificare la spiegabilità fin dall’inizio, sia nella scelta del modello che nell’architettura del sistema.
In che modo l’XAI aiuta a individuare i pregiudizi nei modelli di IA?
I pregiudizi, in inglese bias, spesso insorgono in modo impercettibile. Uno dei motivi è che i dati di addestramento provengono sempre dal passato e riflettono quindi le disuguaglianze storiche. Se, ad esempio, le donne hanno ricoperto meno spesso posizioni dirigenziali o ottenuto prestiti, un modello può apprendere questo schema come una regola apparentemente valida. A ciò si aggiunge il fatto che molti set di dati provengono prevalentemente dai paesi occidentali, per cui altri gruppi demografici e altre regioni risultano sottorappresentati. Un modello addestrato su tali dati può incorporare questi pregiudizi e rafforzarli sistematicamente, senza che ciò sia riconoscibile dal semplice tasso di accuratezza.
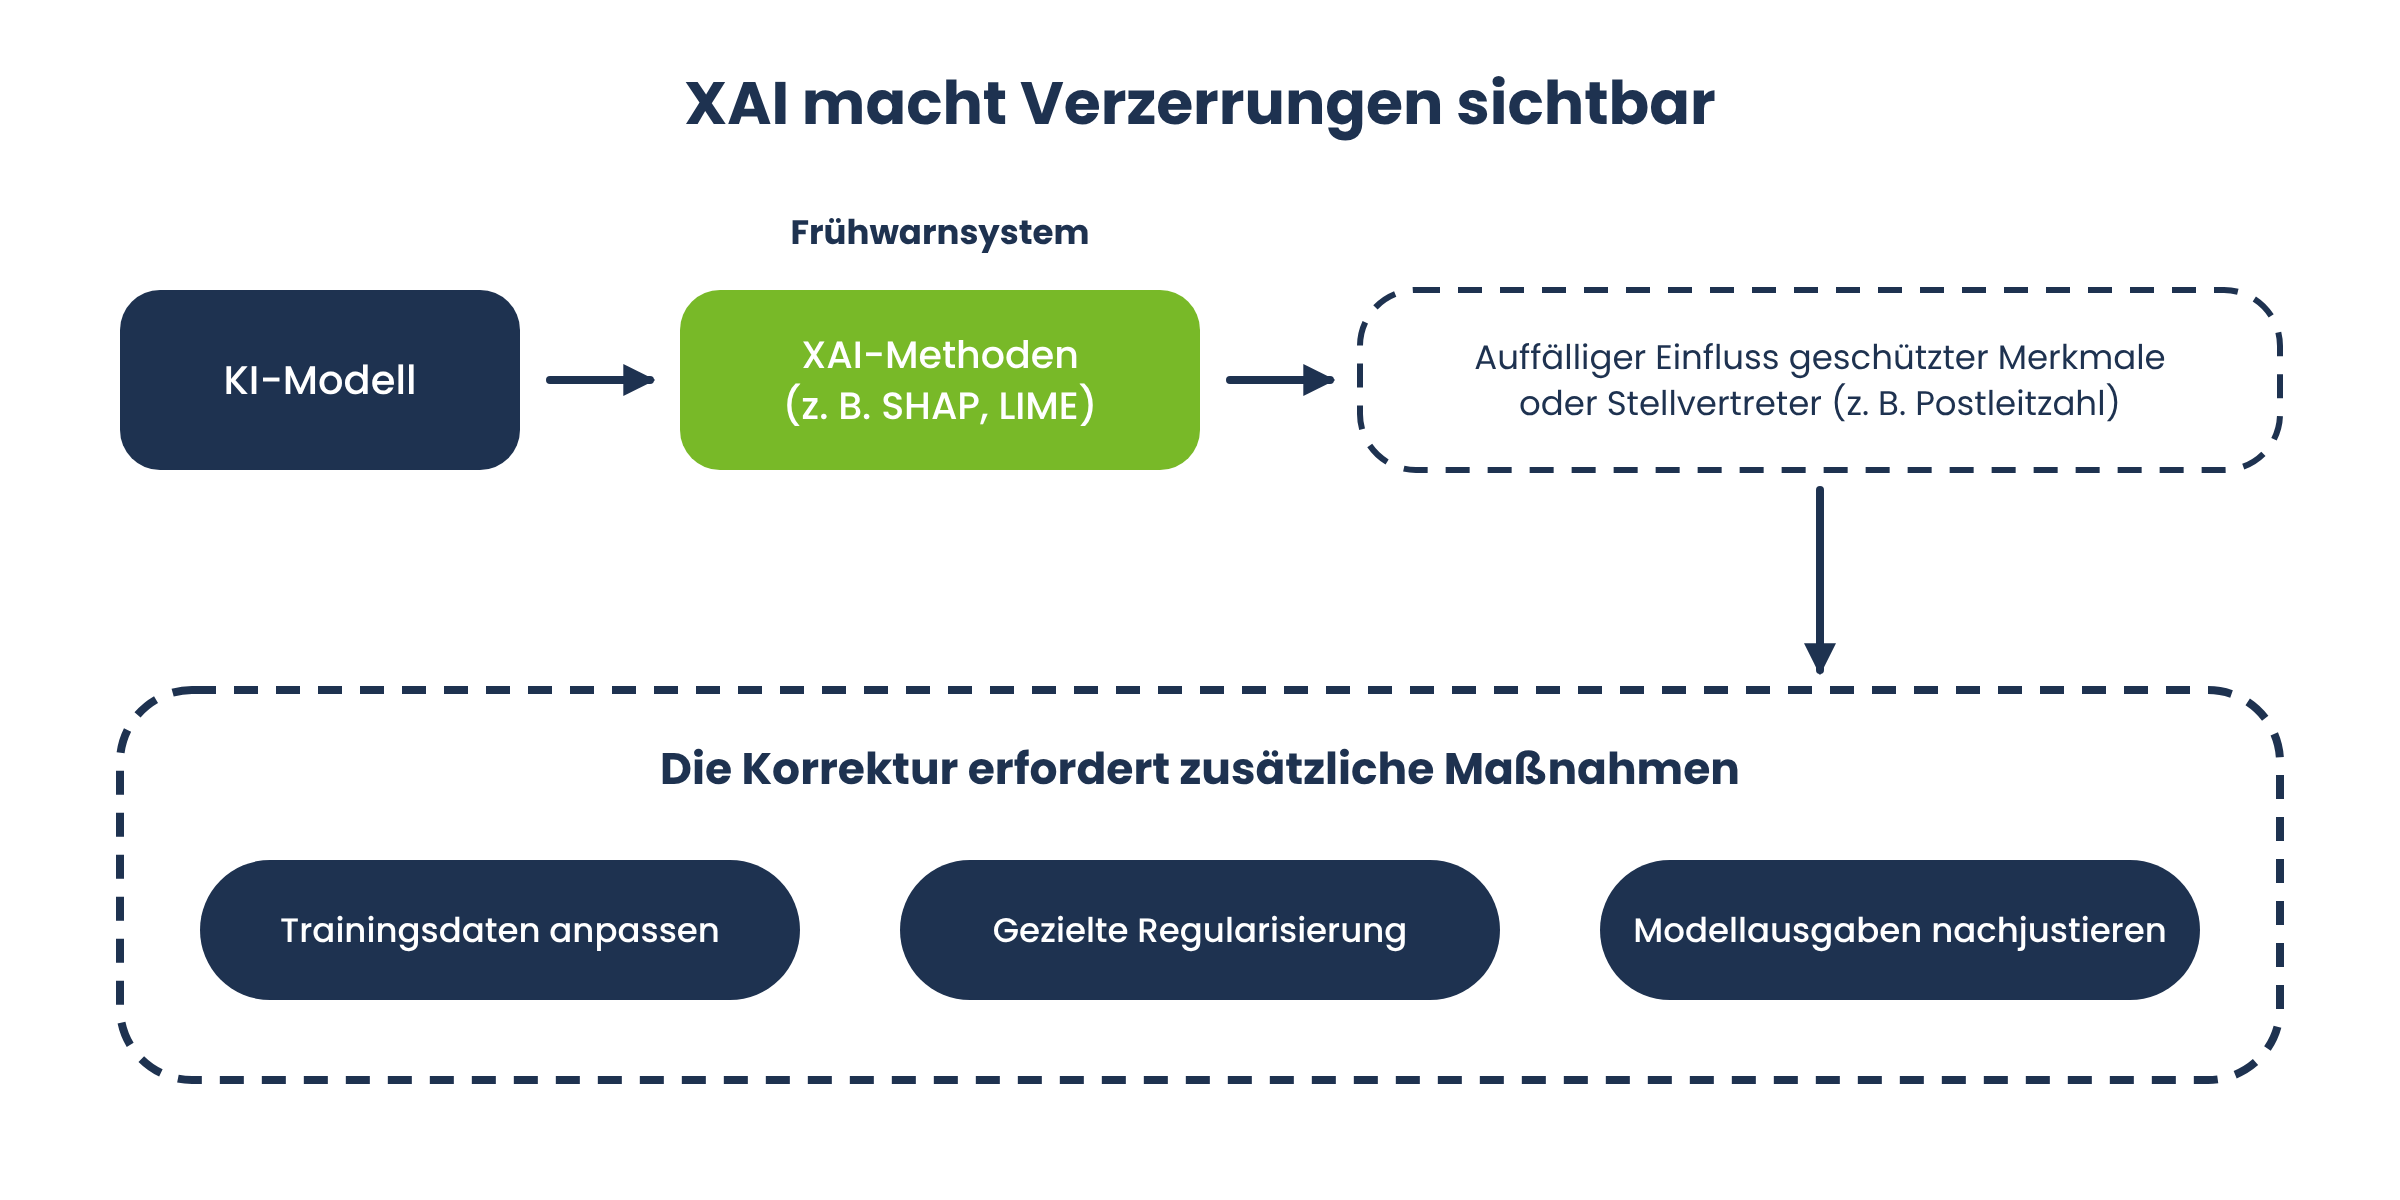
L’IA spiegabile svolge un ruolo centrale nell’individuazione di tali distorsioni. Grazie a metodi come SHAP o LIME, che rivelano quali caratteristiche influenzano effettivamente una previsione, è possibile verificare se caratteristiche protette come il sesso, l’origine o l’età – o caratteristiche proxy strettamente correlate come il codice postale o il nome di battesimo – abbiano un’influenza sproporzionatamente elevata sulle decisioni. Le spiegazioni fungono quindi da una sorta di sistema di allerta precoce che rende visibili modelli che rimangono nascosti nei valori di accuratezza aggregati.
Nella pratica, le aziende combinano spesso spiegazioni locali relative a singole previsioni con analisi globali su insiemi di dati più ampi. In questo modo è possibile non solo esaminare un singolo caso, ma anche verificare sistematicamente se determinati gruppi siano valutati in media peggio di altri. È tuttavia importante tenere presente un limite: la spiegabilità da sola non elimina la distorsione. La rende visibile – la correzione effettiva richiede misure aggiuntive come un adeguamento dei dati di addestramento, una regolarizzazione mirata o un riadattamento degli output del modello. Se ciò non basta a correggere adeguatamente una distorsione, può essere più sensato rinunciare all’utilizzo del modello per quel caso specifico.
Quali sfide comporta l’IA spiegabile?
Per quanto preziosa sia l'IA spiegabile, essa comporta anche alcune sfide che le aziende dovrebbero tenere in considerazione al momento della sua implementazione.
Il compromesso tra accuratezza e trasparenza
Come già descritto nel contesto dei modelli "black box", accuratezza e interpretabilità sono spesso in una certa tensione reciproca. I modelli più potenti sono spesso quelli più difficili da spiegare, mentre i modelli particolarmente trasparenti a volte raggiungono i propri limiti quando si tratta di contesti complessi. Le aziende devono quindi valutare consapevolmente quale livello di spiegabilità sia necessario per il caso d’uso specifico – e quale compromesso in termini di precisione o carico di calcolo siano disposte ad accettare in cambio.
Quando le spiegazioni stesse diventano vulnerabili: attacchi avversariali all’XAI
Una sfida meno nota, ma in continua crescita, riguarda la robustezza dei metodi di spiegazione stessi. Alcuni studi dimostrano che le spiegazioni possono essere manipolate in modo mirato senza che la previsione del modello sottostante subisca alcuna modifica. Ad esempio, è possibile modificare un'immagine in modo minimo e quasi impercettibile all'occhio umano, in modo tale che un metodo di spiegazione indichi improvvisamente come decisive regioni dell'immagine completamente diverse e fuorvianti (articolo di sintesi sugli attacchi avversariali all'XAI). Quando le spiegazioni vengono utilizzate in modo mirato per mascherare distorsioni effettivamente presenti in un modello, nella letteratura specialistica si parla di «fairwashing».
Questa constatazione relativizza un malinteso diffuso: una spiegazione non è una prova inconfutabile dell’affidabilità di un modello, ma è essa stessa uno strumento che deve essere accuratamente convalidato. Le aziende che utilizzano metodi XAI in ambiti in cui sono prevedibili attacchi mirati dovrebbero quindi prestare attenzione anche alla robustezza dei metodi esplicativi stessi, ad esempio nel campo del rilevamento delle frodi o della sicurezza informatica, dove gli aggressori possono avere un interesse diretto a manipolare in modo mirato le spiegazioni.
Spiegazioni che gli utenti finali non comprendono
Una terza sfida è di natura più umana che tecnica: molti metodi esplicativi forniscono risultati che, pur essendo matematicamente fondati, risultano poco intuitivi per i non addetti ai lavori. Un elenco di valori SHAP o una mappa termica ricca di sfumature cromatiche può essere d’aiuto a un data scientist, ma rischia di confondere i clienti finali piuttosto che chiarire loro le idee. La spiegabilità non è quindi un problema puramente tecnico, ma anche una questione di comunicazione comprensibile. Chi utilizza l’XAI nel contatto con i clienti dovrebbe tradurre le spiegazioni tecniche in un linguaggio adeguato al rispettivo gruppo target, ad esempio ricorrendo a spiegazioni controfattuali in linguaggio semplice anziché a valori numerici astratti.
Best practice: come le aziende implementano con successo l’IA spiegabile
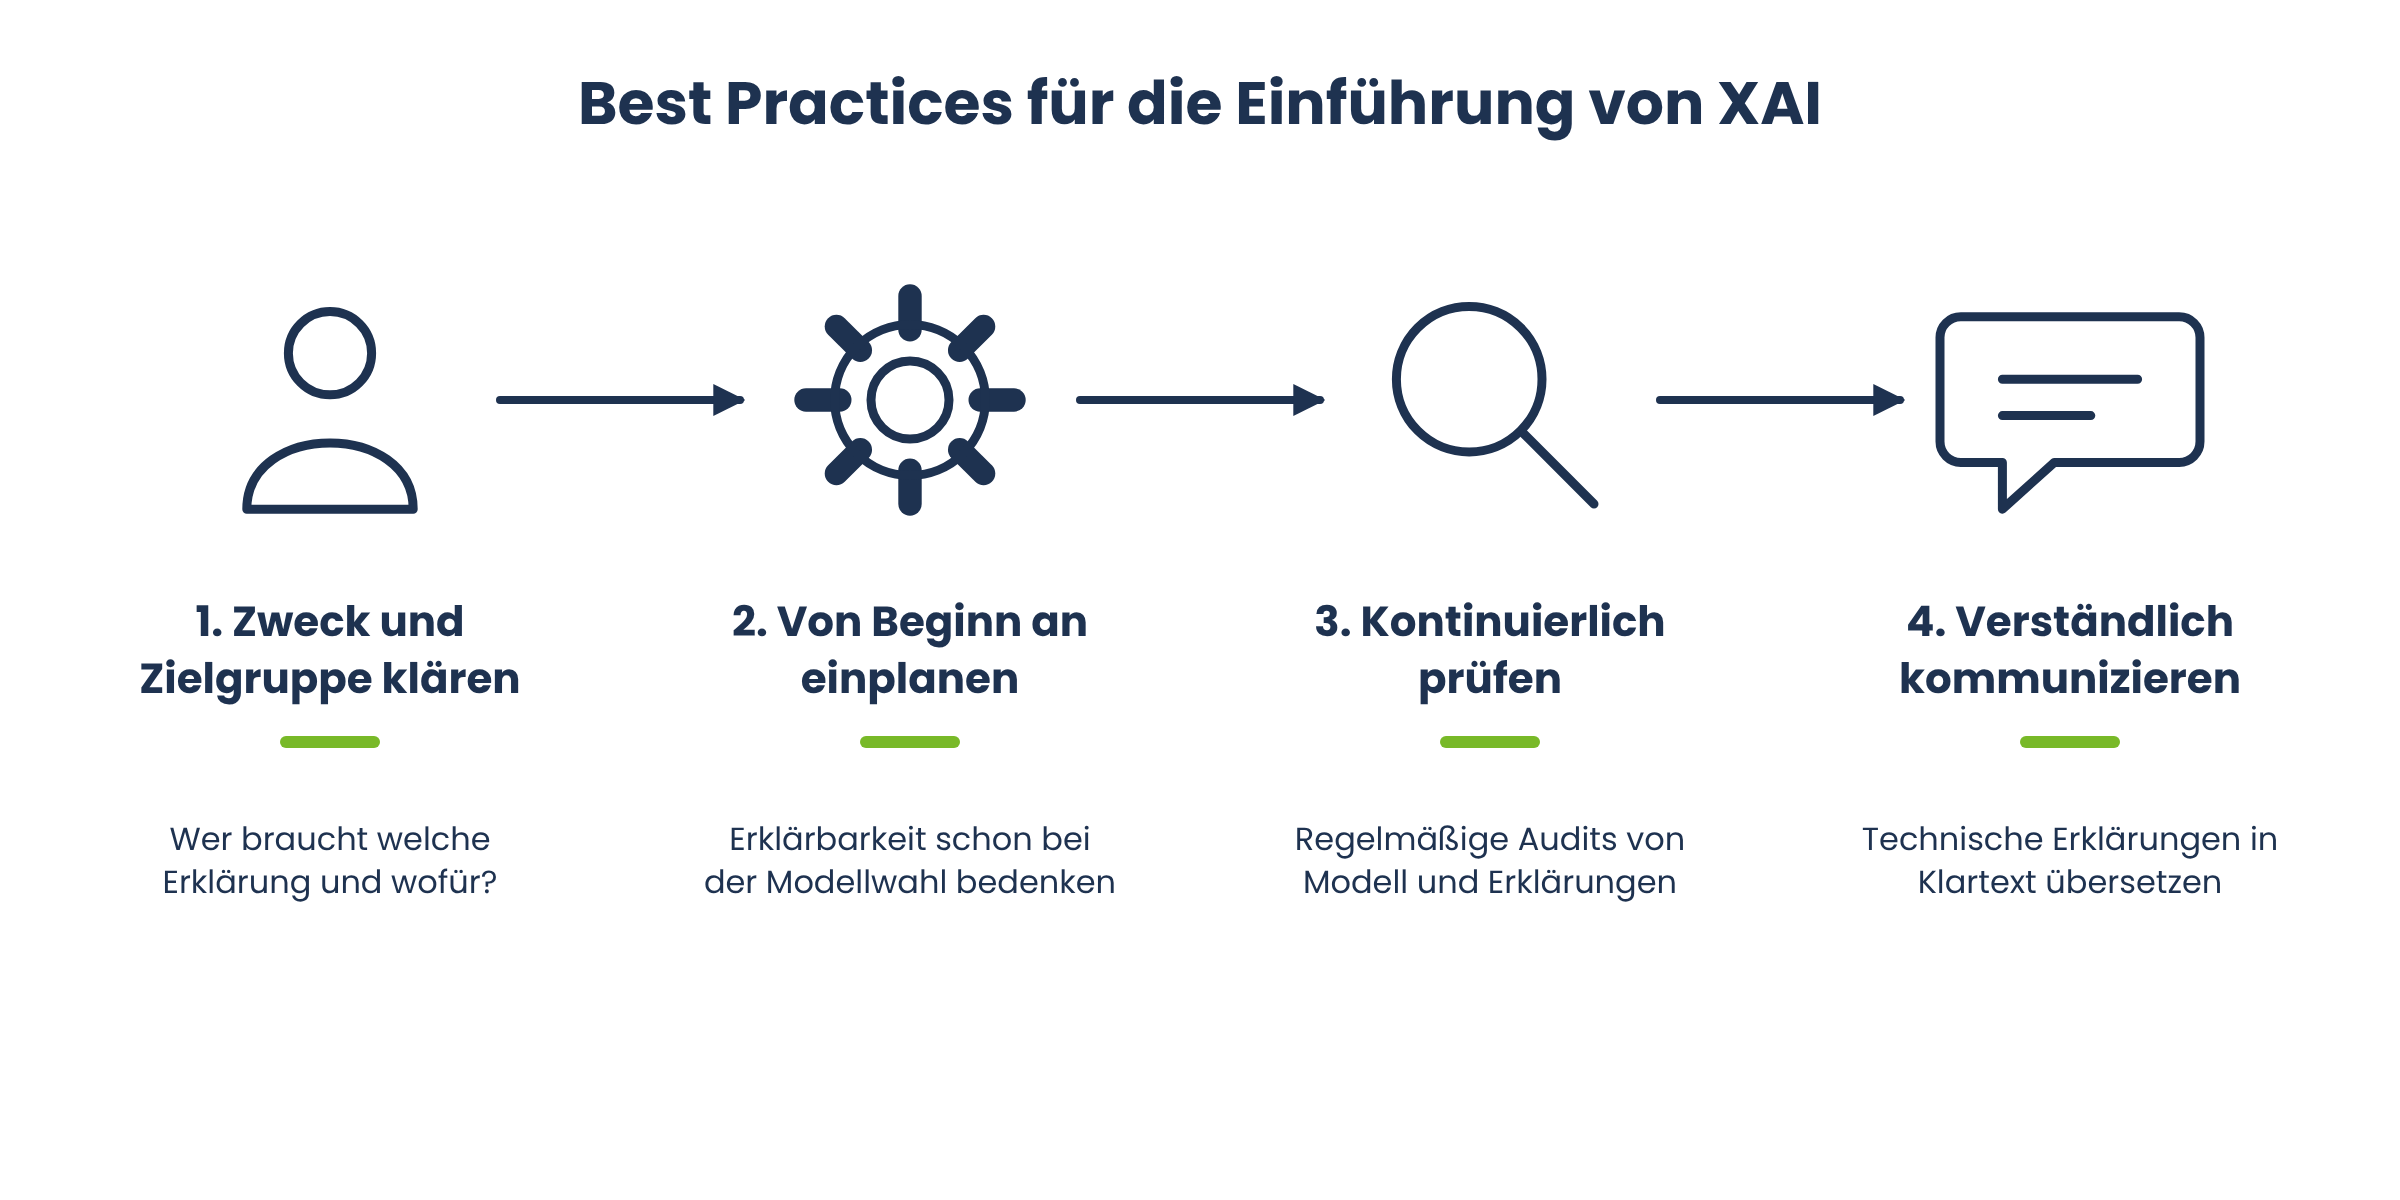
L’introduzione dell’IA spiegabile raramente ha successo se affrontata come un semplice progetto IT. È invece necessario un approccio strutturato che tenga conto in egual misura degli aspetti tecnici, organizzativi e comunicativi.
Il primo passo è chiarire lo scopo: chi deve ricevere una spiegazione e a cosa serve? Un data scientist che analizza le cause delle previsioni errate di un modello ha bisogno di informazioni diverse rispetto a un cliente che desidera comprendere il motivo del rifiuto di una richiesta di credito o a un'autorità di vigilanza che verifica un sistema nell'ambito di un audit. Questi diversi gruppi di destinatari richiedono forme diverse di spiegazione – da rapporti tecnici dettagliati a frasi semplici e comprensibili.
È inoltre opportuno integrare l’IA spiegabile non solo alla fine di un progetto, ma fin dall’inizio. Se la scelta del modello viene effettuata fin dall’inizio anche dal punto di vista della spiegabilità, è possibile evitare modifiche successive. In alcuni casi d’uso, un modello intrinsecamente interpretabile con una precisione leggermente inferiore rappresenta la scelta migliore rispetto a un modello «black box», che deve essere reso spiegabile in un secondo momento con un notevole dispendio di risorse.
Altrettanto importante è la verifica continua: la spiegabilità non è un’attività una tantum da portare a termine, ma un processo continuo. I modelli vengono regolarmente riaddestrati, le distribuzioni dei dati cambiano e, con esse, potenzialmente anche la rilevanza delle singole caratteristiche. Gli audit periodici, che verificano sia le prestazioni del modello sia la qualità e la solidità delle spiegazioni, dovrebbero quindi essere saldamente integrati nelle operazioni aziendali.
Infine, vale la pena investire in una comunicazione comprensibile. La spiegazione tecnicamente migliore serve a poco se non raggiunge il proprio pubblico di riferimento. Le aziende che utilizzano con successo l’IA spiegabile traducono sistematicamente le spiegazioni tecniche in un linguaggio comprensibile per i rispettivi utenti, che si tratti di clienti, dipendenti o autorità di regolamentazione.
Che ruolo svolgono i data scientist e i machine learning engineer nell’ambito dell’XAI?
L'IA spiegabile non è un compito che può essere risolto solo dal punto di vista tecnico: richiede una stretta collaborazione tra diversi ruoli. I data scientist e gli ingegneri di machine learning hanno la responsabilità principale dell’implementazione tecnica: selezionano i modelli adeguati, implementano metodi di spiegazione come SHAP o LIME e verificano se le spiegazioni generate rispecchiano l’effettivo comportamento del modello.
Questo compito va oltre il semplice lavoro di programmazione. I data scientist traducono il contesto specialistico in un problema di machine learning e sviluppano il modello: selezionano modelli adeguati, li addestrano e li ottimizzano. Successivamente analizzano il modello, ed è qui che entrano in gioco metodi di spiegazione come SHAP o LIME. Verificano se le spiegazioni rispecchiano il comportamento reale del modello e le contestualizzano nel rispettivo ambito specialistico, ad esempio in ambito finanziario o medico. Inoltre, traducono i risultati tecnici in un linguaggio comprensibile per persone prive di background tecnico, come i reparti specialistici o le autorità di vigilanza.
Gli ingegneri di machine learning sono responsabili dell’implementazione del modello e dei metodi di spiegazione, nonché del funzionamento operativo. Devono valutare il carico computazionale che le spiegazioni comportano negli ambienti di produzione e come queste possano essere integrate nei sistemi esistenti senza rallentare in modo significativo il funzionamento. Durante il funzionamento, monitorano non solo il modello, ma anche la qualità e la robustezza delle spiegazioni. Inoltre, controllano la qualità dei nuovi dati, individuano le derive dei dati (data drift) e, se necessario, eseguono un nuovo addestramento con una nuova messa a punto. Assicurano inoltre che gli utenti abbiano accesso al modello e alle relative spiegazioni.
Poiché le aree di competenza si sovrappongono, è opportuno ricorrere a team interdisciplinari che uniscano le prospettive di entrambi i ruoli. In molte aziende stanno quindi nascendo sempre più spesso team di questo tipo, in cui si fondono competenze tecniche, conoscenze di settore e comprensione delle normative, al fine di integrare efficacemente l’IA spiegabile nelle operazioni aziendali.
L'IA spiegabile come base per decisioni affidabili
L'IA spiegabile non è più un argomento di nicchia, ma un elemento fondamentale per un uso responsabile dell'intelligenza artificiale nelle aziende. Che si tratti di concessione di crediti, diagnostica medica o rilevamento delle frodi: ovunque i modelli di IA prendano decisioni con conseguenze concrete, cresce l’esigenza di rendere tali decisioni comprensibili.
I metodi presentati – da SHAP a LIME e alle spiegazioni controfattuali, fino alla Layer-wise Relevance Propagation e al Causal Tracing – dimostrano che esistono strumenti adeguati praticamente per ogni caso d’uso. È importante scegliere il metodo più adatto all’obiettivo, conoscerne i limiti e considerare la spiegabilità come un processo continuo anziché come una misura tecnica una tantum.
Inoltre, con il GDPR e l’EU AI Act, il quadro normativo si sta continuamente inasprendo. Le aziende che investono già oggi in sistemi di IA spiegabili non solo garantiscono la certezza giuridica, ma creano anche la base di fiducia necessaria per un’ampia accettazione delle decisioni supportate dall’IA.
Hai bisogno di supporto per l’implementazione di un modello di IA spiegabile o sei alla ricerca di un corso di formazione adeguato? Ti aiutiamo a implementare i sistemi di IA nella tua azienda!
Domande frequenti sull'IA spiegabile (FAQ)
Per “IA spiegabile” si intendono quei metodi che rendono comprensibile come e perché un modello di IA sia giunto a una determinata decisione o previsione. Anziché limitarsi a fornire un risultato, viene fornita anche una spiegazione, ad esempio quali fattori abbiano avuto un peso particolarmente rilevante.
Questi termini non vengono utilizzati in modo uniforme. Spesso il concetto di “interpretabilità” descrive quanto un modello sia trasparente dal punto di vista della sua struttura. Il concetto di «spiegabilità» descrive invece quanto sia facile spiegare le decisioni di un modello – anche a posteriori, ricorrendo a metodi aggiuntivi – indipendentemente dal grado di trasparenza della struttura del modello stesso.
Non esiste un metodo “migliore” in assoluto. SHAP fornisce risultati teoricamente più fondati e coerenti, ma nella variante “modellagnostica” richiede un maggiore carico di calcolo. LIME è più veloce e intuitivo, ma non offre garanzie formali di coerenza e le sue spiegazioni possono variare leggermente da un'esecuzione all'altra. Molte aziende utilizzano entrambi i metodi in modo complementare, a seconda del caso d'uso.
L’XAI è raramente prescritto direttamente come obbligo a sé stante. Indirettamente, tuttavia, tale esigenza deriva sia dall’articolo 22 del GDPR sia dagli obblighi di trasparenza e vigilanza previsti dall’EU AI Act per i sistemi di IA ad alto rischio. Chi intende soddisfare questi requisiti nella pratica ha bisogno di modelli comprensibili. Ciò è possibile ricorrendo a modelli interpretabili fin dall’inizio, come le regressioni lineari o gli alberi decisionali di piccole dimensioni, oppure, nel caso di modelli più complessi, utilizzando metodi aggiuntivi di intelligenza artificiale spiegabile (Explainable AI).
I modelli di deep learning sono costituiti da numerosi strati e da milioni o miliardi di parametri, che vengono adattati automaticamente durante l’addestramento. Le numerose relazioni non lineari tra questi parametri danno origine a calcoli annidati, in cui i singoli pesi non hanno più un significato comprensibile per l’uomo. Sebbene questa elevata complessità consenta previsioni precise, rende la logica interna non più direttamente comprensibile – a differenza di quanto avviene con modelli semplici e intrinsecamente interpretabili, come le regressioni lineari.
No. L’IA spiegabile non impedisce le distorsioni, ma può aiutare a individuarle, mostrando quali caratteristiche influenzano una previsione. L’eliminazione effettiva dei pregiudizi richiede misure aggiuntive, come l’adeguamento dei dati di addestramento o correzioni mirate volte a garantire l’equità all’interno del modello stesso.
Fornire spiegazioni comprensibili è un presupposto fondamentale affinché le persone abbiano fiducia nelle decisioni supportate dall’IA. Chi comprende perché un modello è giunto a un determinato risultato è in grado di contestualizzarlo meglio, di analizzarlo in modo critico e, in caso di dubbio, anche di contestarlo: ciò rafforza l’accettazione dei sistemi di IA sia da parte dei collaboratori che dei clienti.
Non necessariamente. I metodi esplicativi a posteriori (post hoc) forniscono approssimazioni del comportamento effettivo del modello, non una verità assoluta. Inoltre, studi di ricerca dimostrano che le spiegazioni possono essere manipolate in modo mirato senza modificare la previsione sottostante. Le spiegazioni dovrebbero quindi essere sempre esaminate con occhio critico e non interpretate acriticamente come prova dell’affidabilità di un modello.


