
Databricks vs. Snowflake: quale piattaforma dati è più adatta alla tua azienda?
Un’azienda di medie dimensioni operante nel settore della costruzione di macchinari sta progettando un nuovo sistema di reporting per i propri dati di produzione. La direzione IT richiede due preventivi: uno per Snowflake e uno per Databricks. Entrambi i fornitori promettono costi inferiori, prestazioni migliori e maggiore flessibilità. Al termine delle trattative, la confusione è maggiore di prima. È proprio questa la situazione in cui si trovano attualmente molte aziende che desiderano modernizzare la propria infrastruttura dati.
Databricks e Snowflake sono tra le piattaforme leader nella gestione moderna dei dati. Entrambe elaborano enormi quantità di dati, entrambe pubblicizzano funzionalità di intelligenza artificiale ed entrambe sostengono di essere adatte a quasi tutti i casi d’uso. Ma cosa significa questo concretamente per la tua decisione? Questo articolo mette a confronto Databricks e Snowflake in base ai criteri che contano davvero nella pratica: architettura, modello di prezzo, costo totale di proprietà, prestazioni e casi d’uso.
Databricks vs. Snowflake: perché questa scelta è così importante?
La scelta della piattaforma dati non è più una semplice decisione di natura informatica. Determina la rapidità con cui la tua azienda è in grado di reagire ai cambiamenti del mercato, l'efficacia con cui i reparti specialistici possono lavorare con i dati e l'entità dei costi correnti per i progetti di data engineering, analisi dei dati e intelligenza artificiale. Sebbene una decisione errata possa essere corretta in un secondo momento, la migrazione da una piattaforma all’altra è complessa e costosa.
Negli ultimi anni entrambe le piattaforme si sono avvicinate notevolmente. Con Snowpark, Cortex AI e il supporto per i carichi di lavoro Python, Snowflake ha conquistato i domini classici di Databricks. Databricks, a sua volta, con Databricks SQL e Photon ha sviluppato una risposta alle analisi SQL classiche, che tradizionalmente rappresentavano il punto di forza di Snowflake. Per le aziende ciò significa che non è più sufficiente limitarsi a uno sguardo superficiale al materiale di marketing.
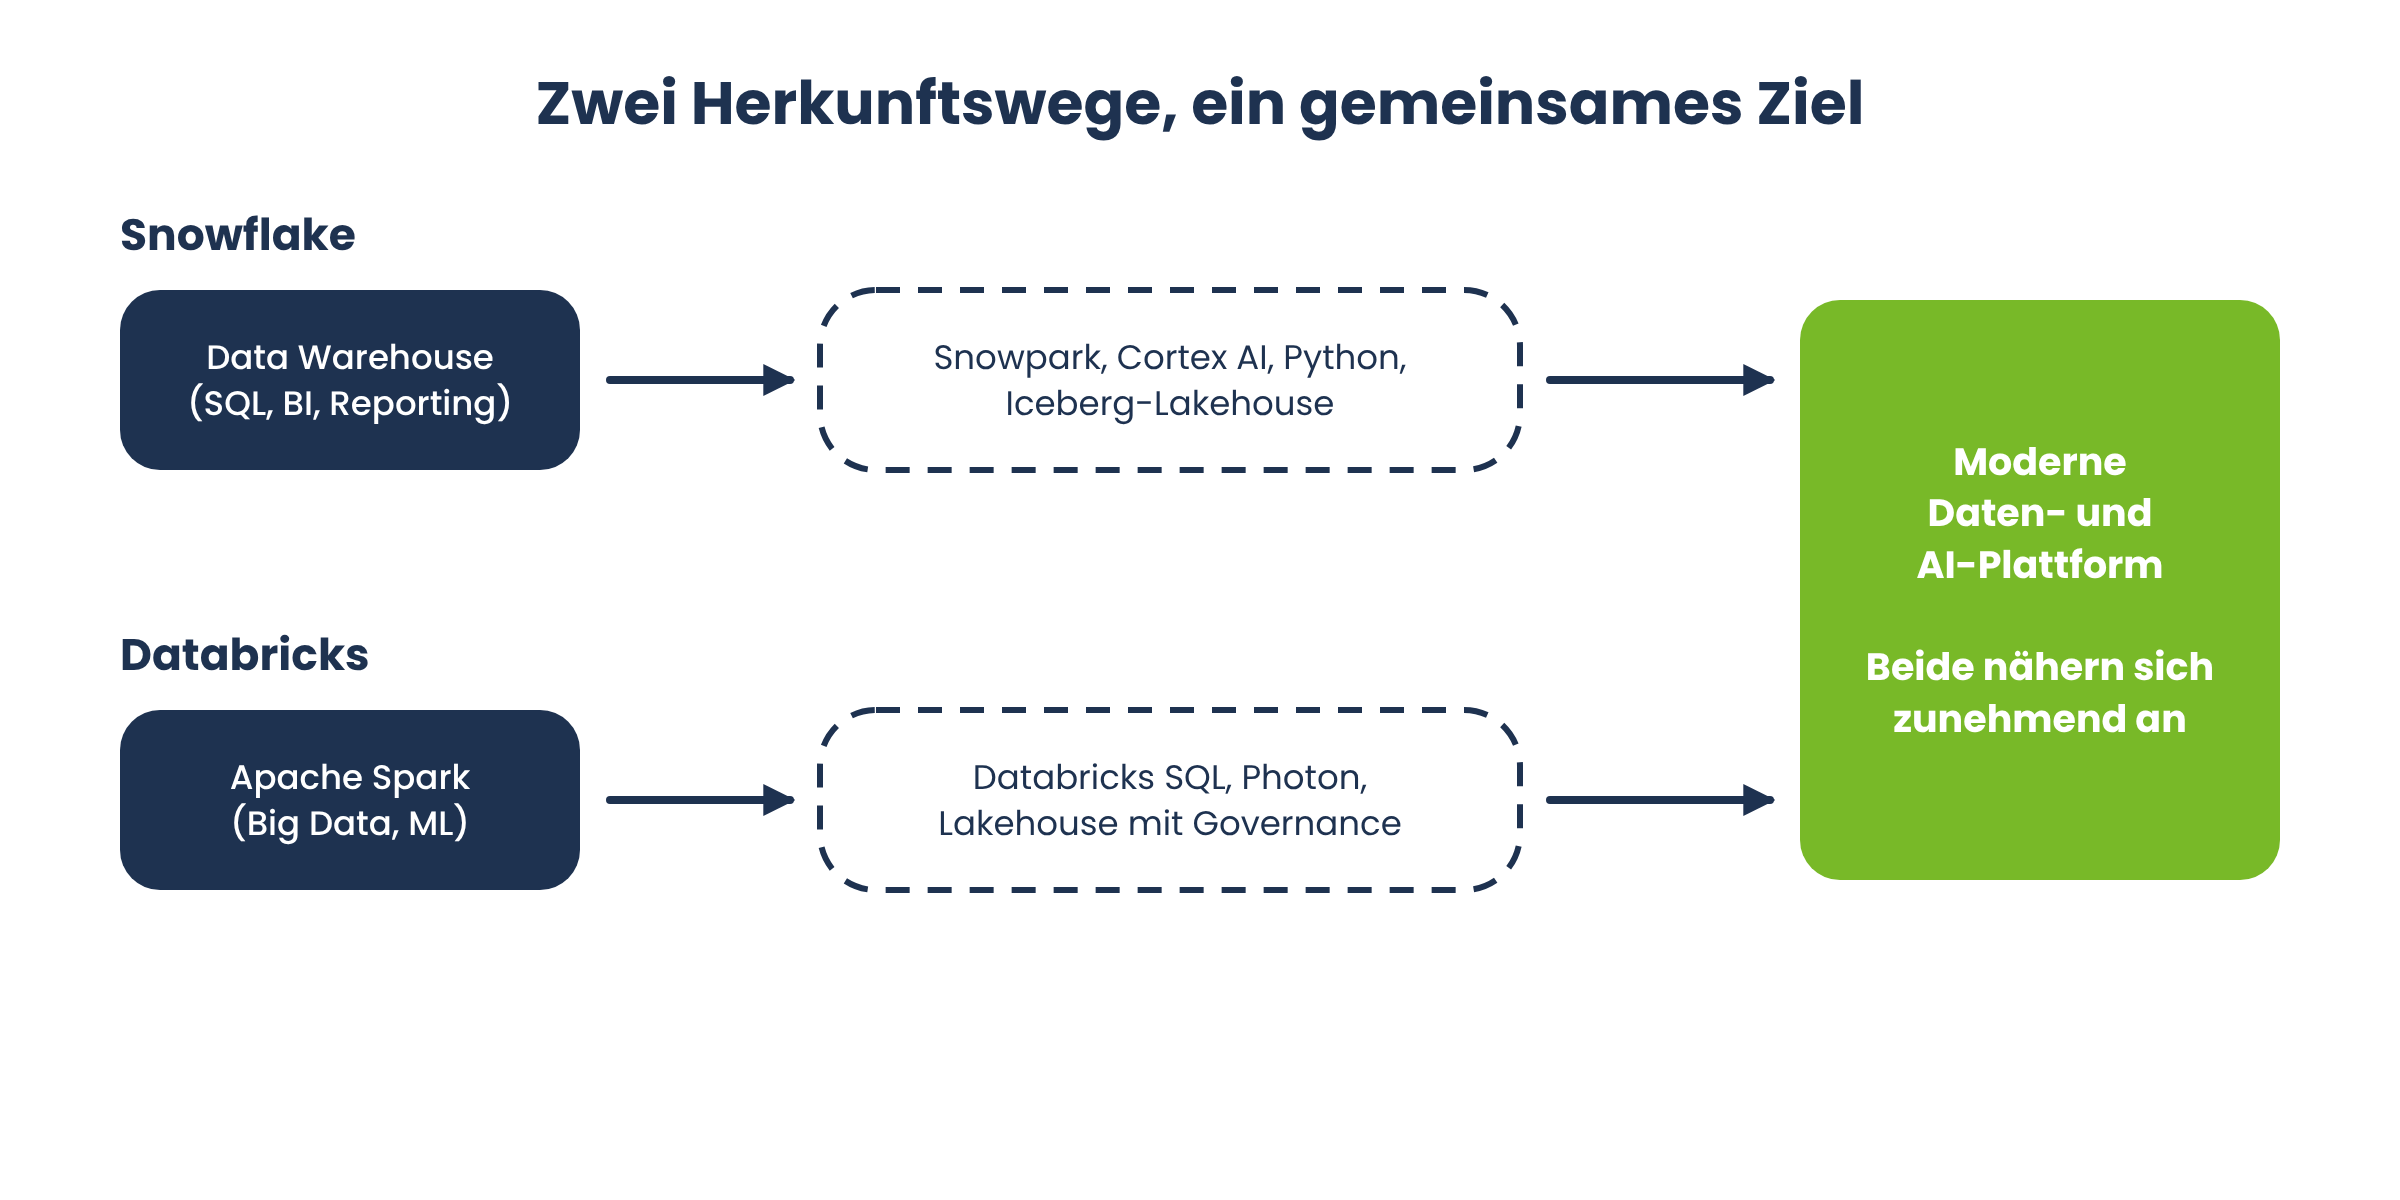
Ma cosa sono esattamente Databricks e Snowflake?
Prima di mettere a confronto Databricks e Snowflake, vale la pena dare un'occhiata alle nozioni di base. Entrambi i termini vengono spesso utilizzati nel contesto aziendale come sinonimi di "piattaforma dati cloud moderna", sebbene dal punto di vista tecnico seguano approcci diversi.
Che cos’è Snowflake?
Snowflake è una piattaforma dati basata sul cloud, originariamente sviluppata come data warehouse. Grazie alla separazione tecnica tra memoria (storage) e potenza di calcolo (compute), entrambe le risorse possono essere scalate indipendentemente l'una dall'altra. Mentre inizialmente Snowflake veniva utilizzato principalmente per analisi basate su SQL, BI e reporting, oggi la piattaforma supporta anche dati semi-strutturati e non strutturati, nonché architetture lakehouse, ad esempio basate su Apache Iceberg. Inoltre, Snowflake offre funzionalità per applicazioni di intelligenza artificiale (AI) e machine learning, evolvendo così sempre più da un classico data warehouse a una piattaforma completa per i dati e l’intelligenza artificiale.
Che cos’è Databricks?
Databricks è nato dal progetto open source Apache Spark e adotta il cosiddetto approccio "Lakehouse". Un Data Lakehouse combina la flessibilità di un Data Lake, in cui è possibile archiviare anche dati non strutturati come immagini, file di log o dati dei sensori, con la struttura e la governance di un classico Data Warehouse. Databricks è fortemente orientato ai Big Data, allo streaming e al machine learning e offre supporto nativo per Python, Scala, R e SQL.
Databricks e Snowflake: una panoramica delle principali differenze
A prima vista, entrambe le piattaforme sembrano intercambiabili: basate sul cloud, scalabili in modo elastico, con accesso SQL e funzionalità di intelligenza artificiale. A un esame più attento, tuttavia, emergono differenze significative:
Origine: Snowflake proviene dal mondo dei data warehouse, mentre Databricks dal mondo dei big data e del machine learning.
Tipi di dati: Snowflake e Databricks elaborano sia dati strutturati che non strutturati.
Logica di prezzo: Snowflake calcola in crediti, Databricks in Databricks Units (DBU).
Destinatari: Snowflake si rivolge principalmente agli analisti aziendali con conoscenze di SQL, mentre Databricks è più orientato ai data engineer e ai data scientist.
Governance: Snowflake offre una soluzione di governance nativa con Horizon Catalog, così come Databricks con Unity Catalog.
Entrambe le piattaforme, tuttavia, sono in continua evoluzione e assumono sempre più le funzionalità l’una dell’altra.
Confronto tra architetture: Data Warehouse vs. Data Lakehouse
L'architettura di una piattaforma ne determina l'idoneità nell'uso pratico. È proprio qui che risiede la differenza più importante tra Databricks e Snowflake.
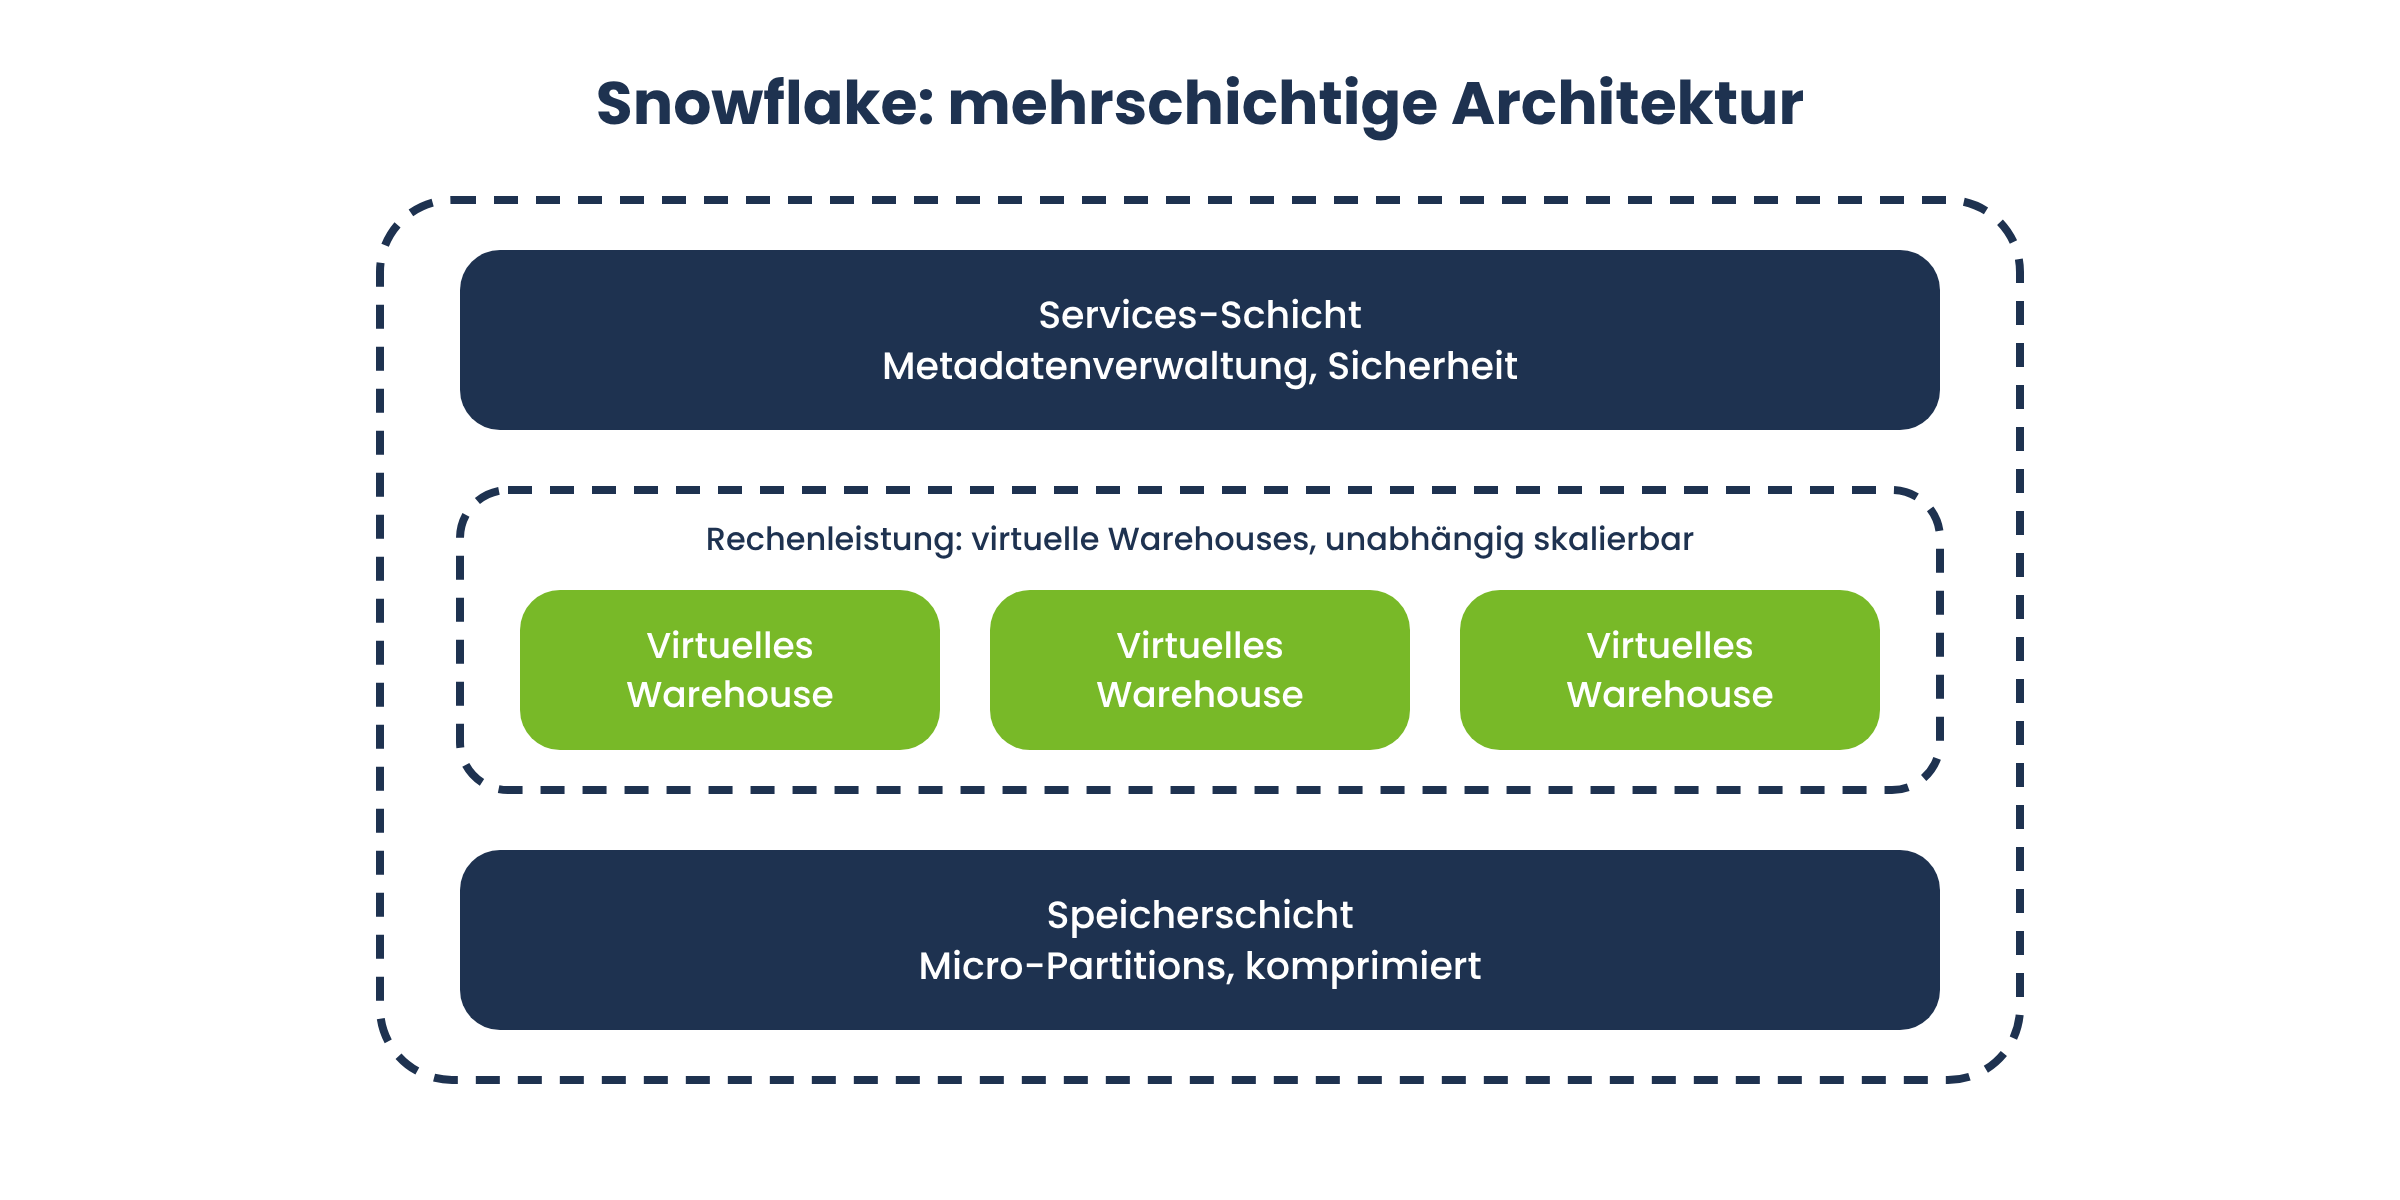
Come funziona l'architettura di Snowflake?
Snowflake utilizza un'architettura multistrato con livelli separati per l'archiviazione, la potenza di calcolo e i servizi quali la gestione dei metadati o la sicurezza. I dati vengono compressi e archiviati in cosiddette micro-partizioni, piccole unità di archiviazione gestite automaticamente che Snowflake ottimizza per garantire un'efficiente esecuzione delle query. Per le operazioni di calcolo, Snowflake utilizza i «warehouse virtuali», ovvero cluster di calcolo isolati che possono essere scalati indipendentemente l’uno dall’altro.
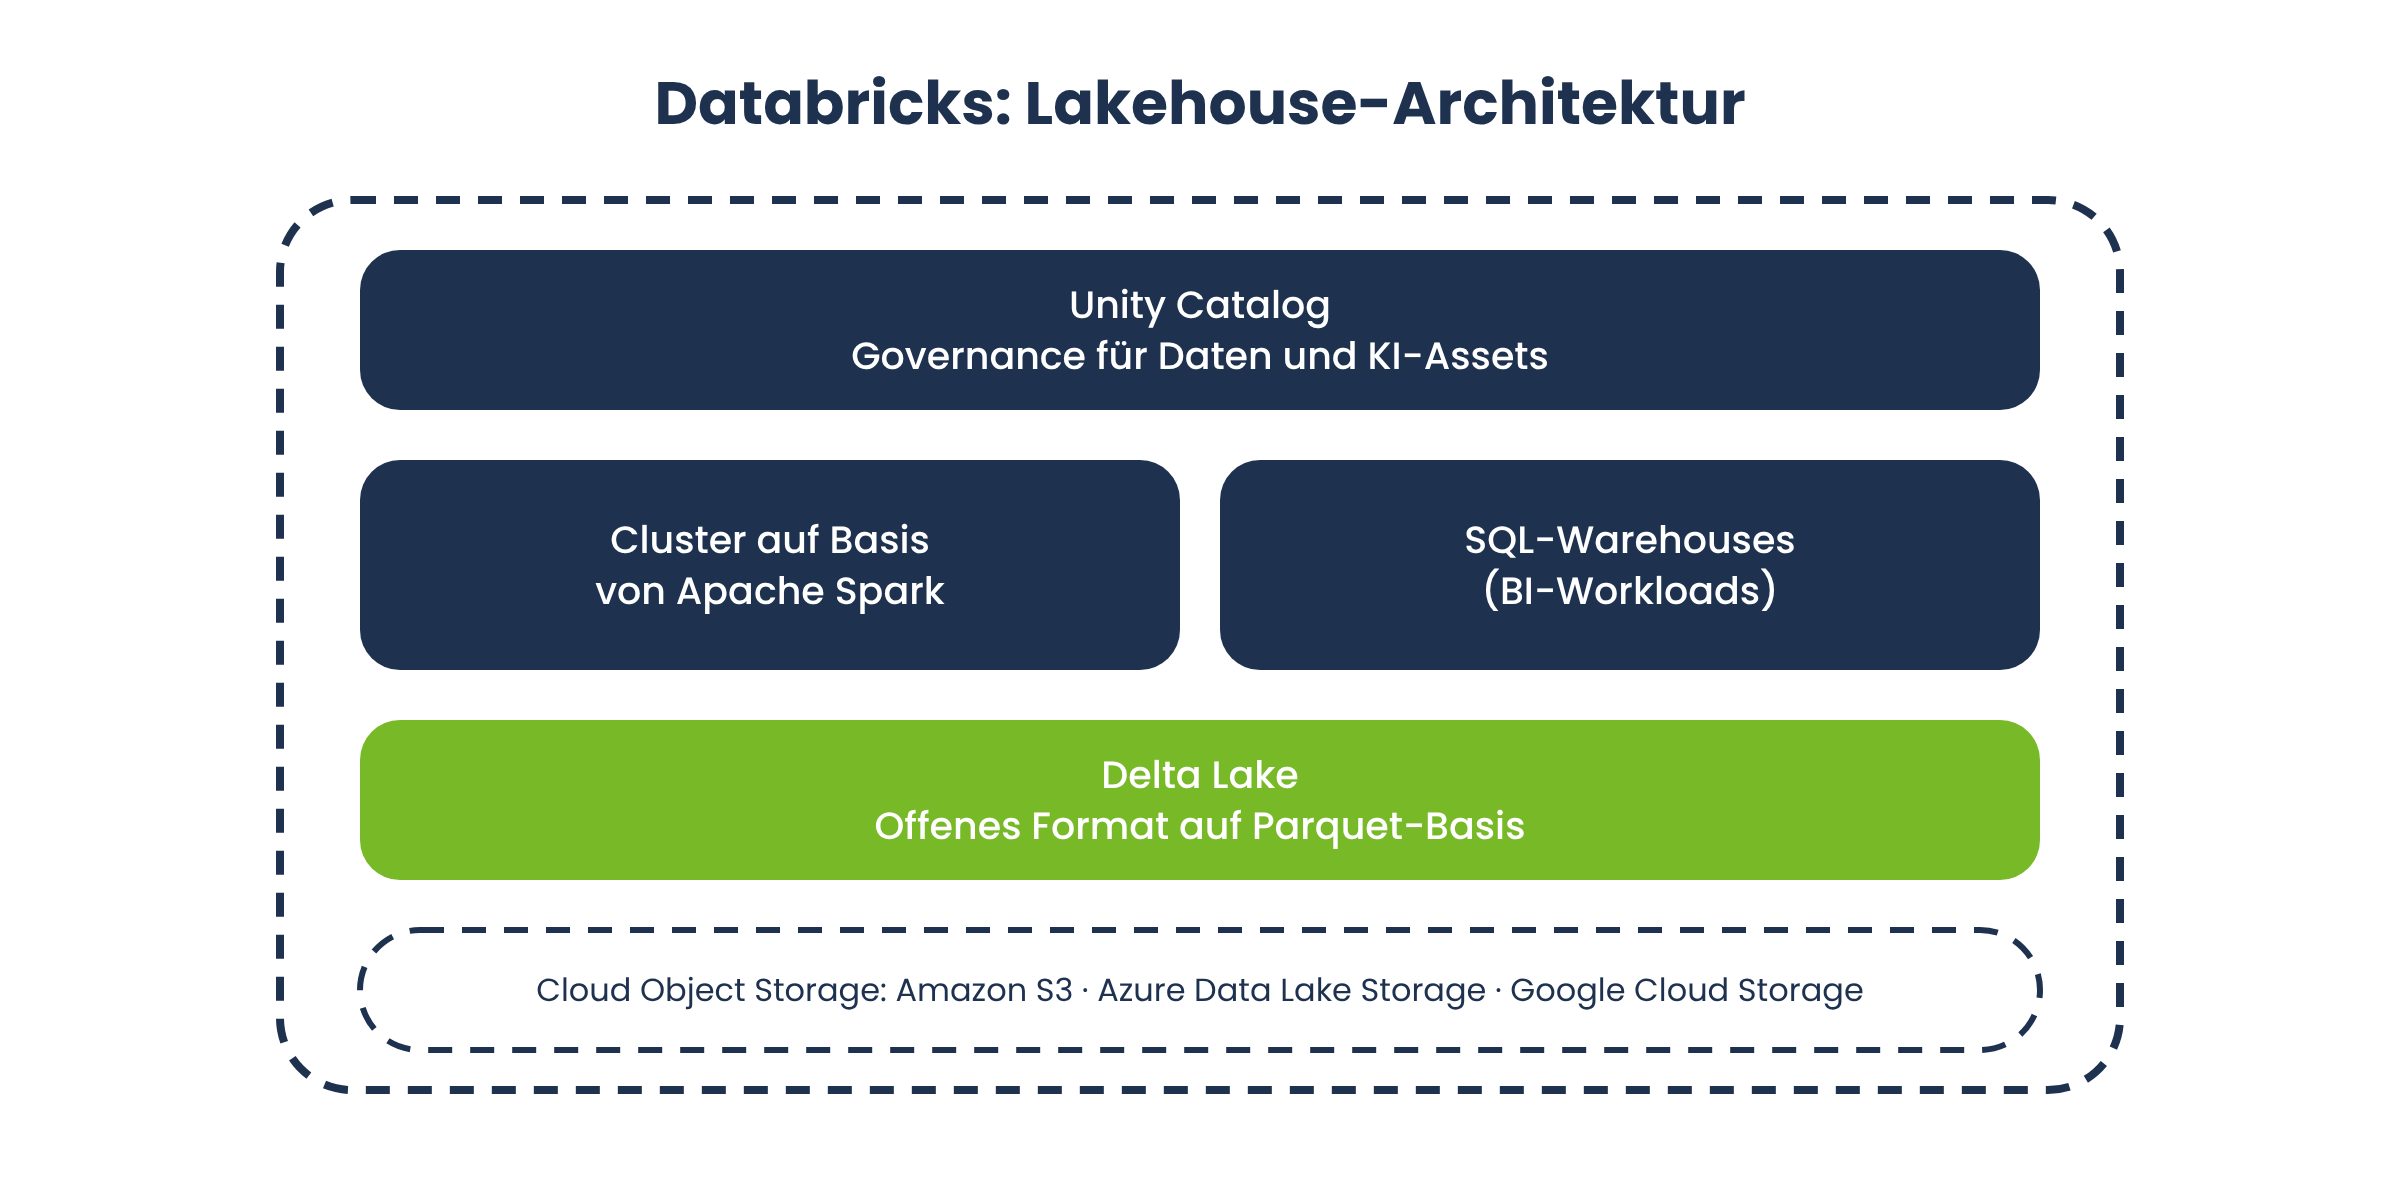
Come funziona l'architettura Lakehouse di Databricks?
Databricks archivia i dati sotto forma di tabelle Delta Lake (basate su Parquet) direttamente in un sistema di archiviazione oggetti cloud come Amazon S3, Azure Data Lake Storage o Google Cloud Storage. Le operazioni di calcolo vengono eseguite tramite cluster basati su Apache Spark o tramite data warehouse SQL per i carichi di lavoro di BI. Poiché i dati sono in formati aperti e risiedono nel proprio archivio cloud, il controllo sull’infrastruttura dei dati rimane in gran parte nelle mani dell’azienda stessa.
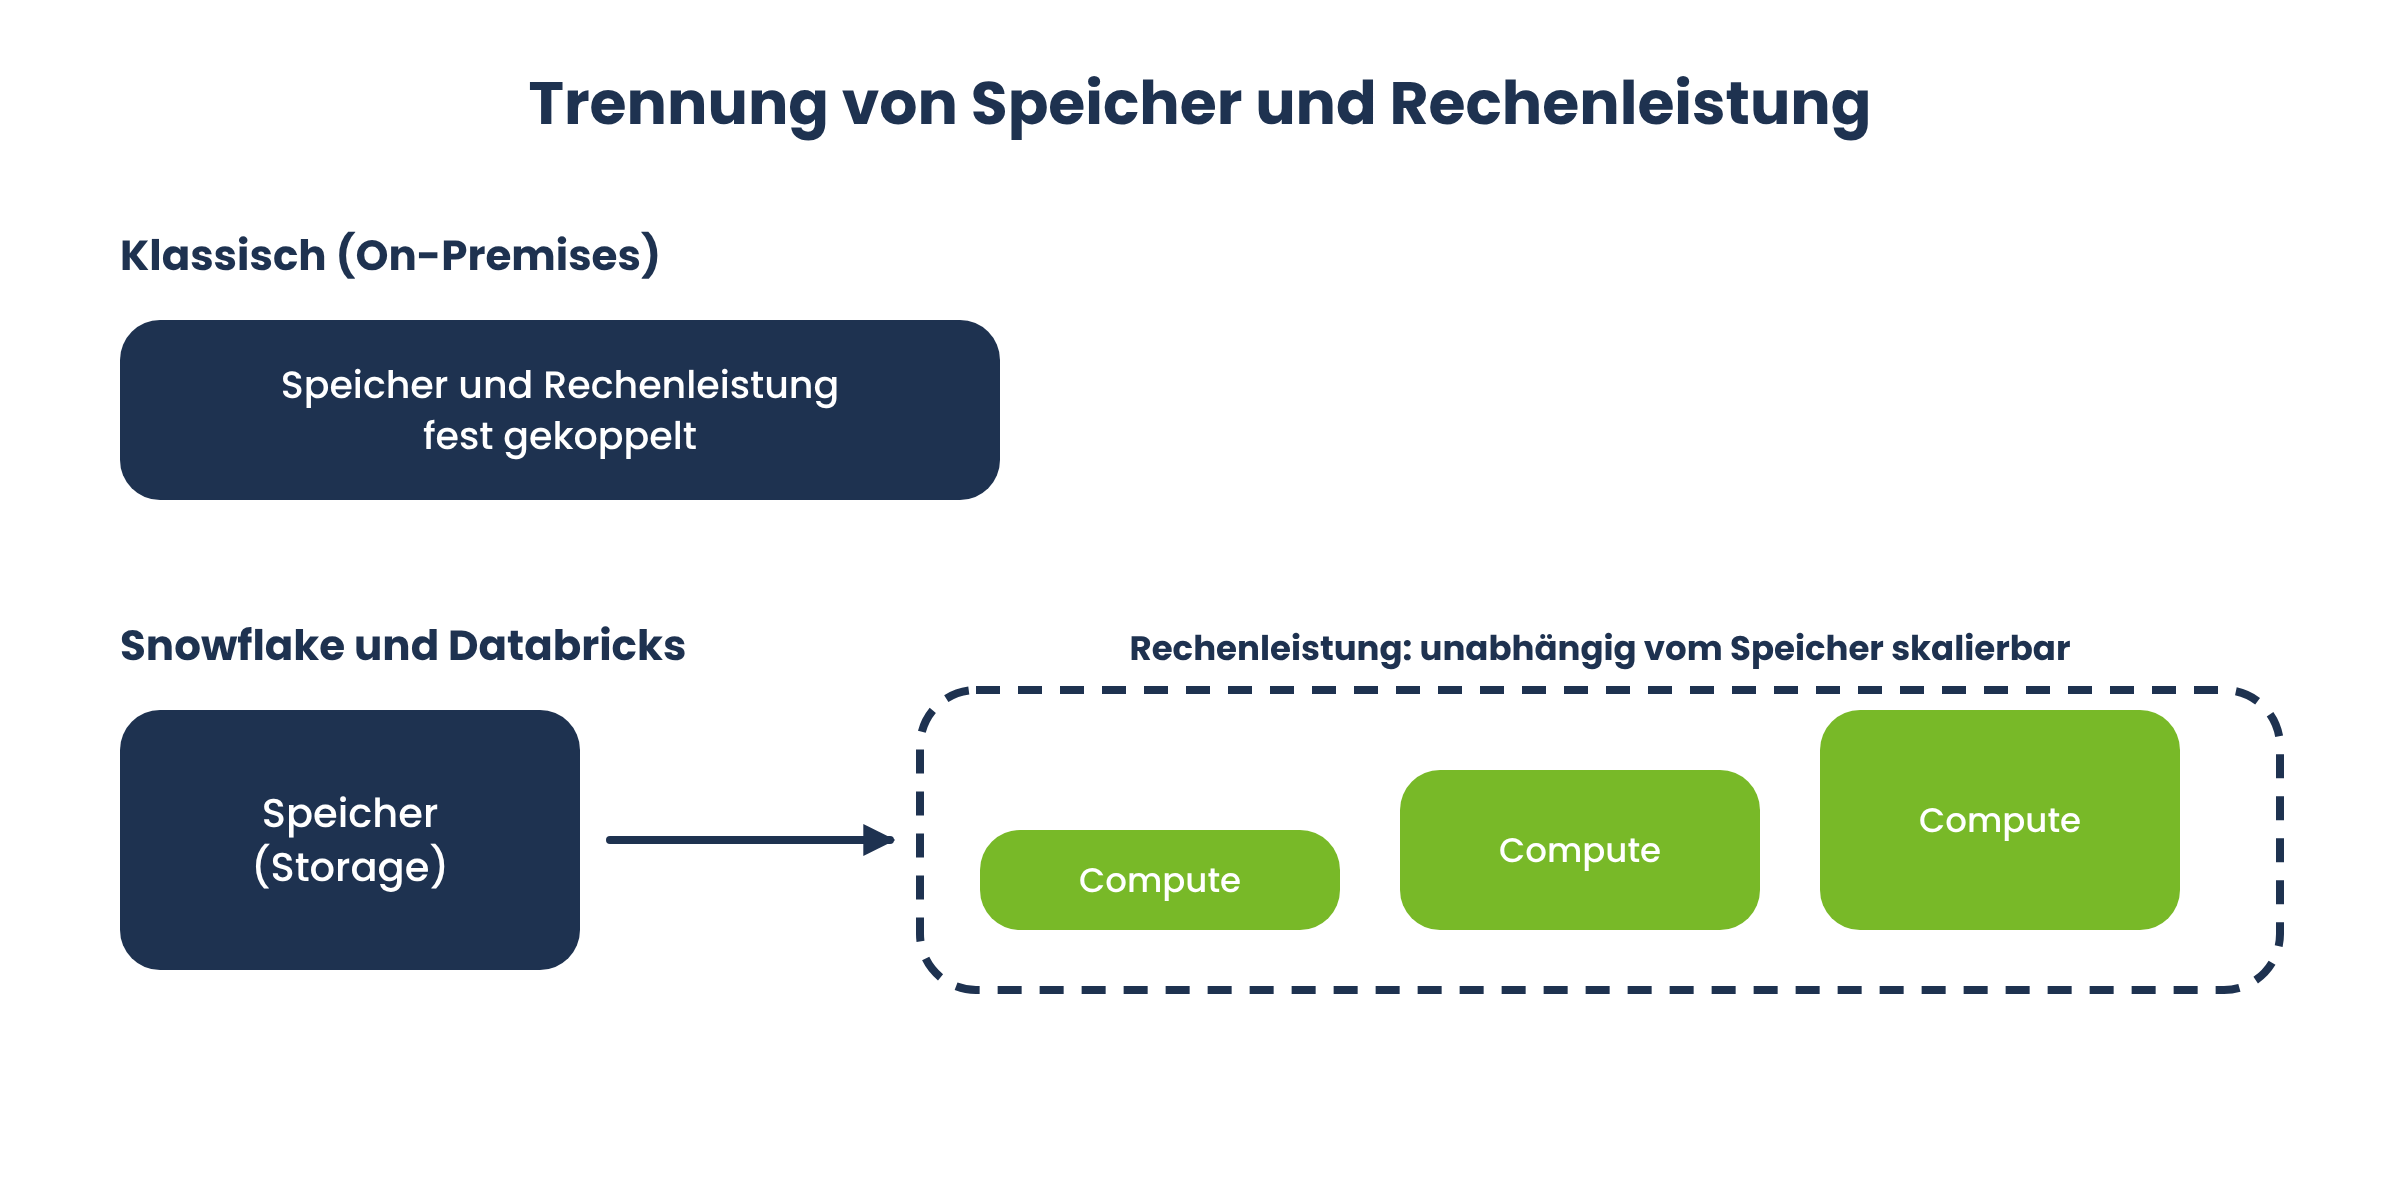
Cosa significa la separazione tra storage e potenza di calcolo?
Entrambe le piattaforme separano lo storage dalla potenza di calcolo. Si tratta di un progresso fondamentale rispetto ai classici sistemi on-premises, in cui entrambe le componenti erano strettamente integrate.
I modelli di prezzo nel dettaglio: come calcolano i costi Snowflake e Databricks?
Un confronto basato esclusivamente sui prezzi di listino non è sufficiente. Entrambi i fornitori utilizzano modelli di prezzo basati sull’utilizzo, in cui i costi effettivi dipendono fortemente dal carico di lavoro individuale. Chi non comprende entrambe le logiche di prezzo rischia di prendere rapidamente una decisione sbagliata e costosa.
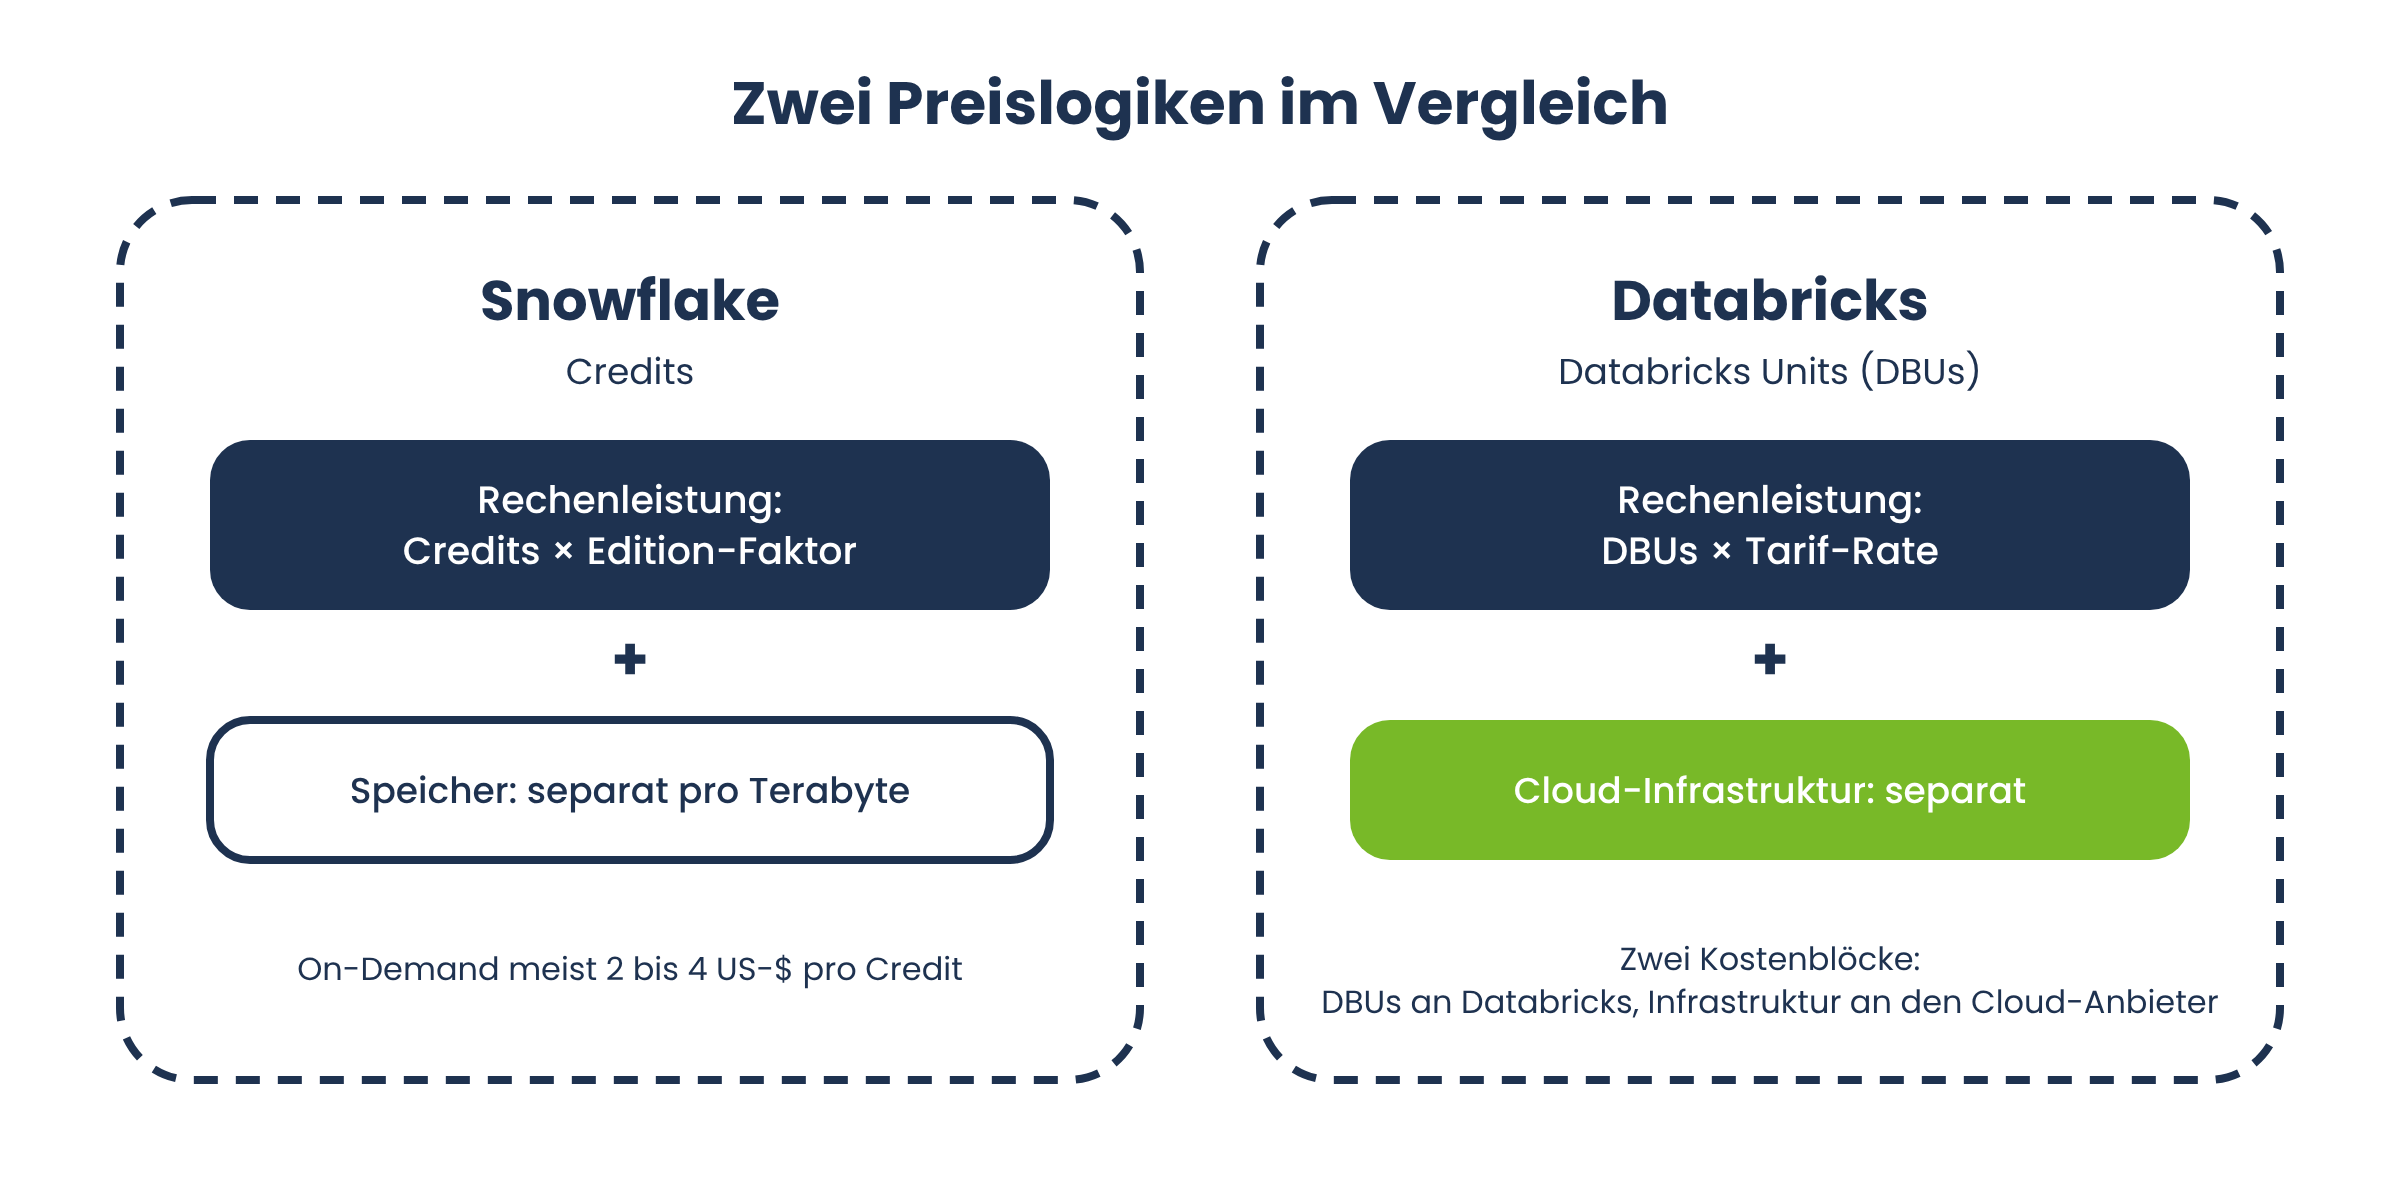
Come funziona il modello di prezzo di Snowflake basato sui crediti?
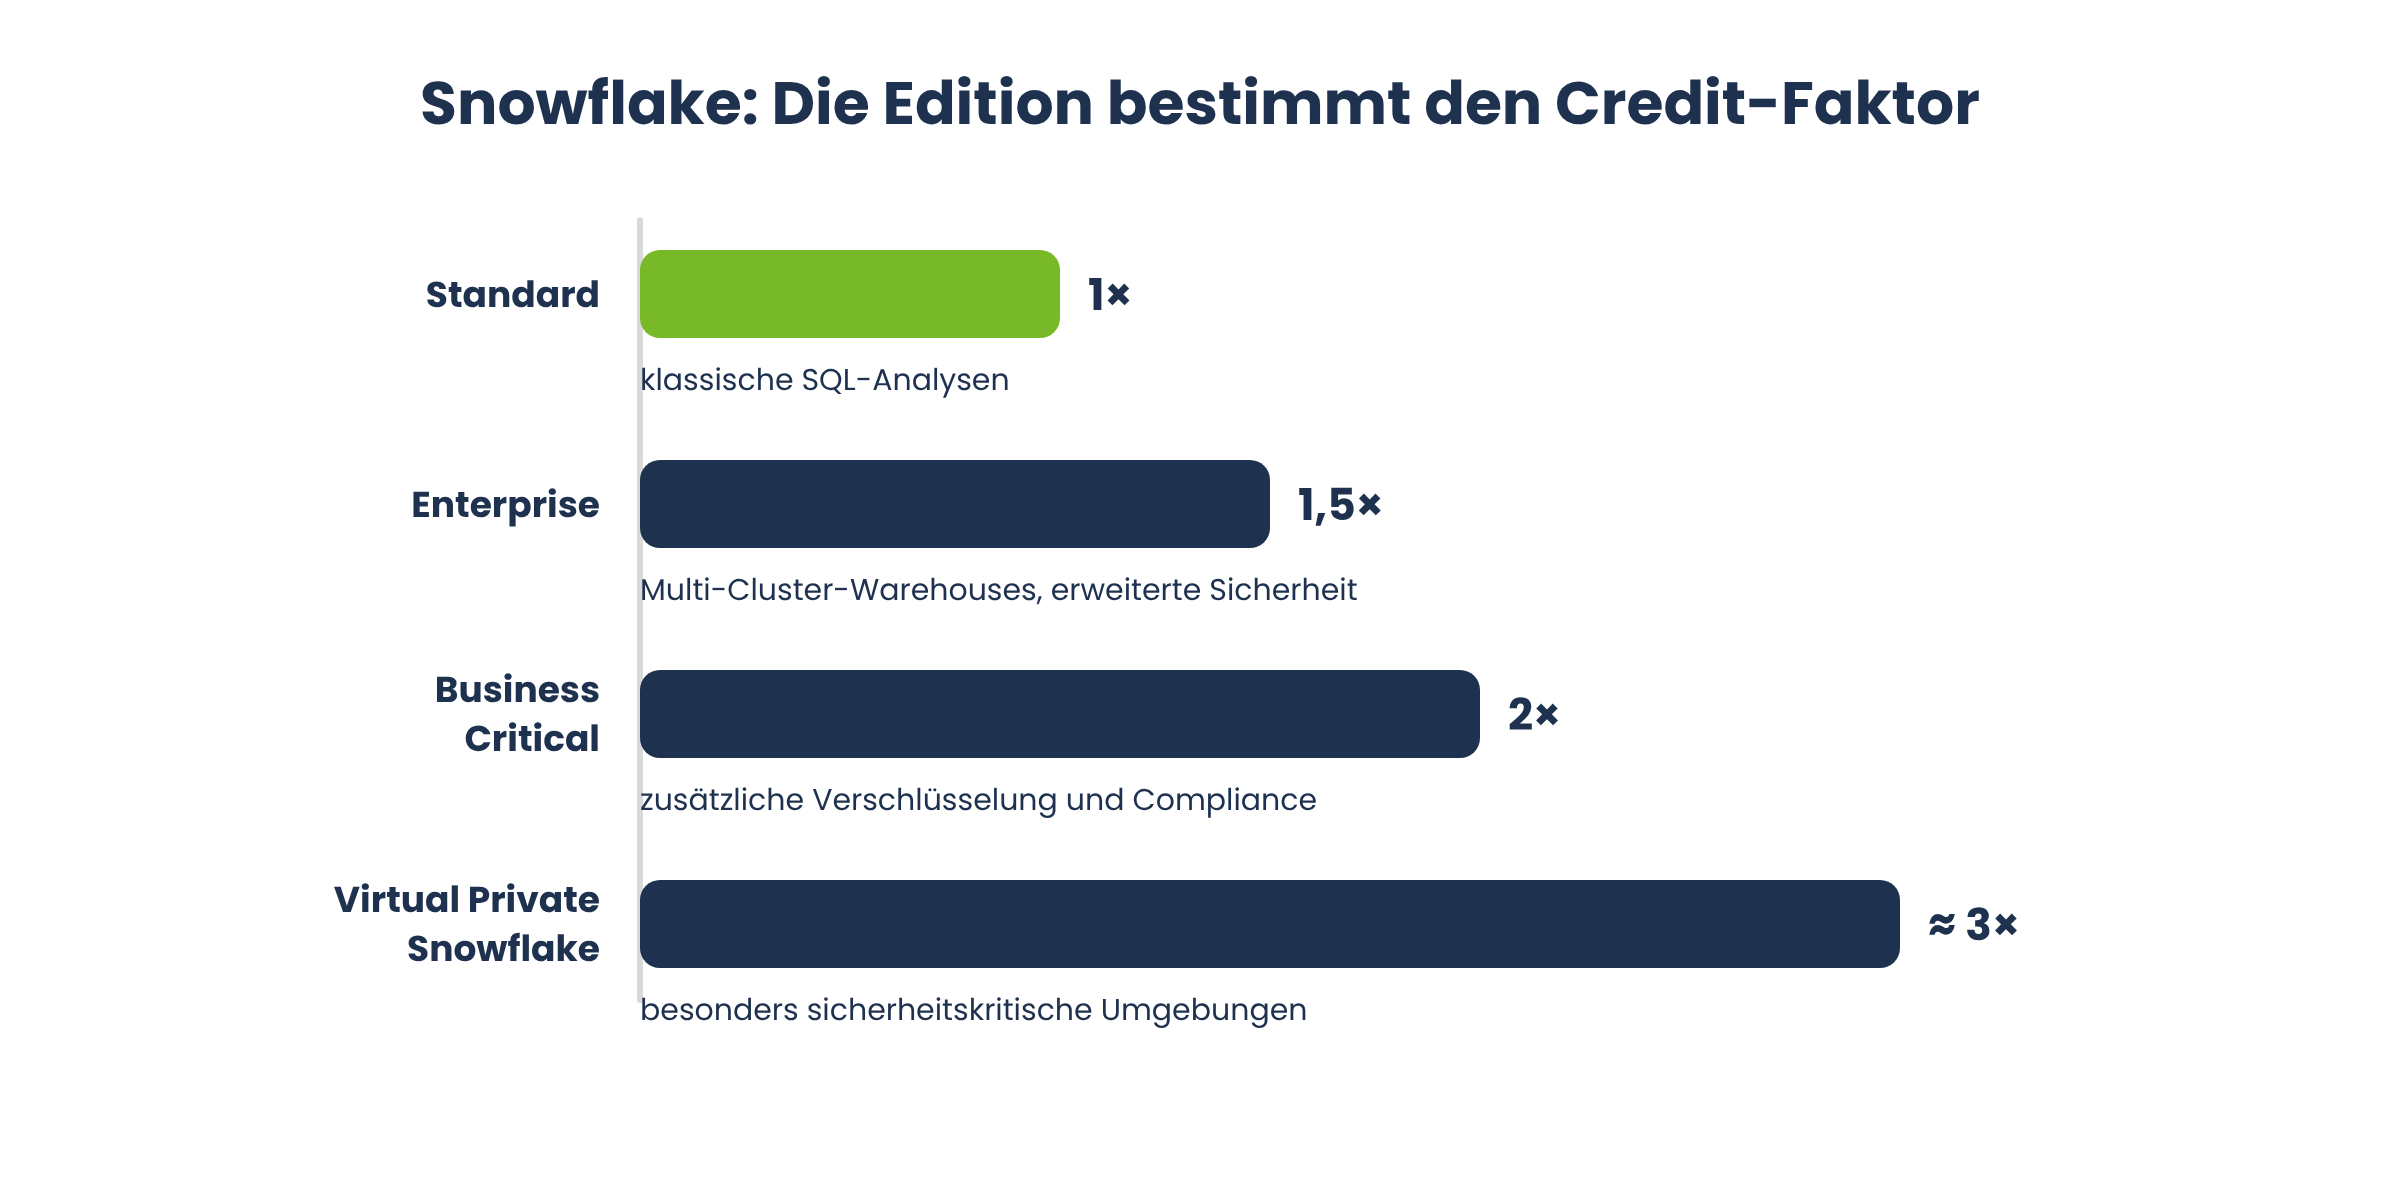
Snowflake utilizza un modello di tariffazione basato sui crediti per le risorse di calcolo. Un credito Snowflake corrisponde a un'ora di potenza di calcolo di un data warehouse virtuale della dimensione più piccola. A seconda dell'edizione, questo prezzo base viene moltiplicato per un fattore:
Standard: fattore base 1×, per analisi SQL classiche.
Enterprise: fattore 1,5×, inclusi i data warehouse multi-cluster e le funzionalità di sicurezza avanzate.
Business Critical: fattore 2×, con crittografia aggiuntiva e funzionalità di conformità.
Virtual Private Snowflake: fattore circa 3×, per ambienti particolarmente critici dal punto di vista della sicurezza.
Il prezzo per credito per l’utilizzo on-demand varia solitamente tra i 2 e i 4 euro, a seconda del fornitore di servizi cloud e della regione. In caso di capacità prenotata in anticipo, il prezzo effettivo si riduce notevolmente (Software Pricing Guide).
Cosa sono le Databricks Units (DBU) e come vengono calcolate?
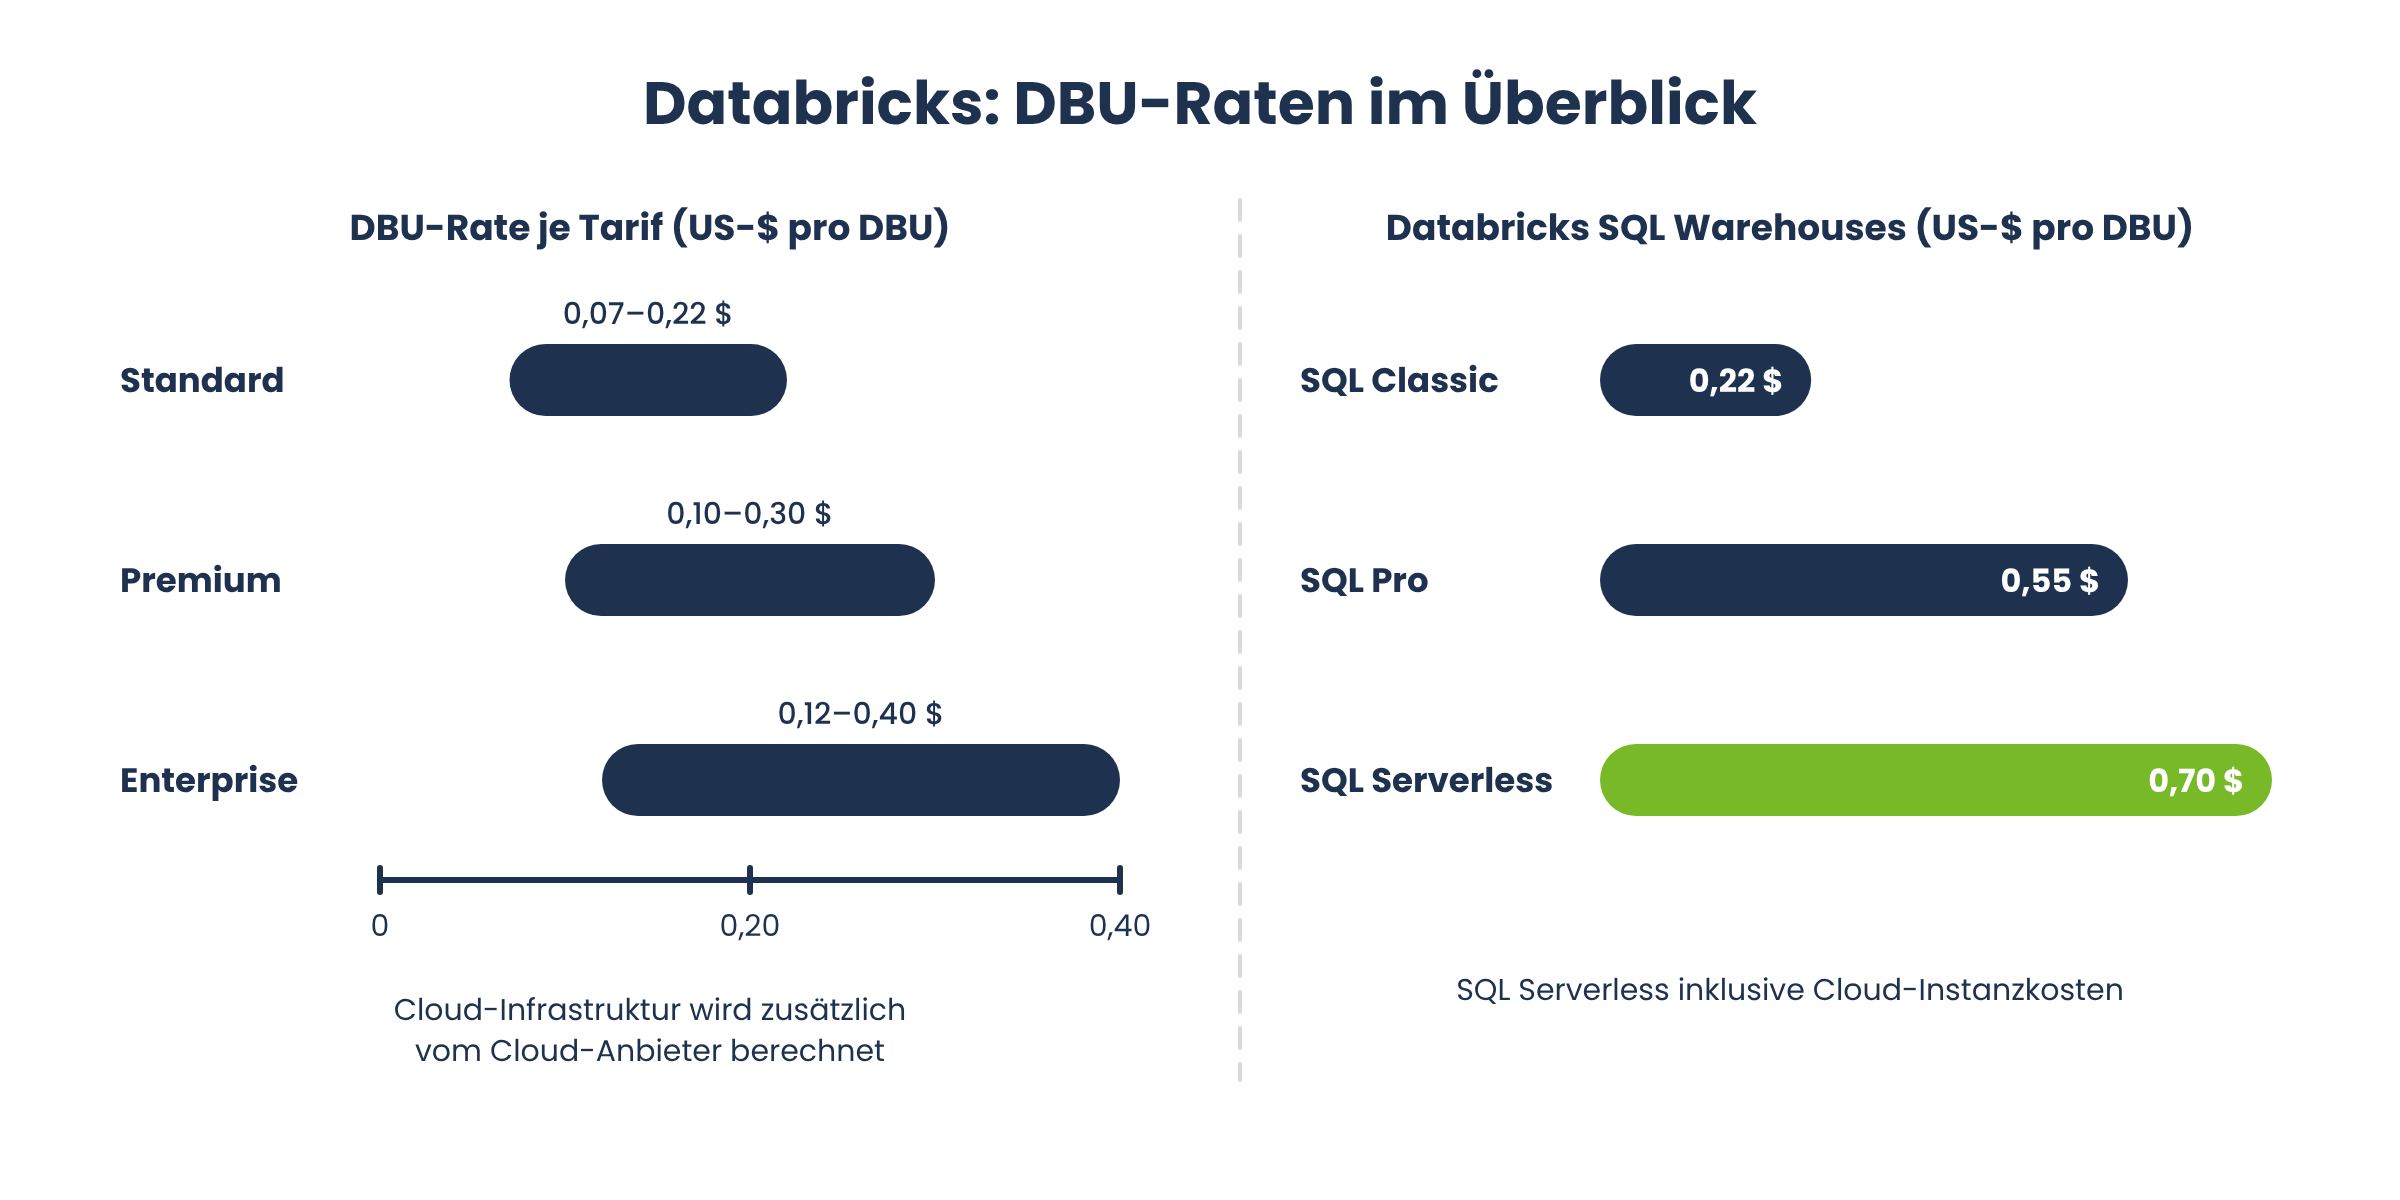
Databricks utilizza le Databricks Units (DBU) per la determinazione dei prezzi. Una DBU misura la capacità di calcolo consumata all'ora. Il consumo varia a seconda del tipo di cluster e del carico di lavoro. Inoltre, il costo per DBU varia a seconda del piano tariffario:
Standard: da circa 0,06 a 0,20 € per DBU.
Premium: da circa 0,09 a 0,27 € per DBU, inclusi il controllo degli accessi basato sui ruoli e i log di audit.
Enterprise: da circa 0,11 a 0,36 € per DBU, inclusi Unity Catalog e governance avanzata.
Per i Databricks SQL Warehouse, il livello di query BI della piattaforma, si applicano tariffe DBU specifiche:
SQL Classic: circa 0,20 € per DBU.
SQL Pro: circa 0,49 € per DBU.
SQL Serverless: circa 0,62 € per DBU, inclusi i costi delle istanze cloud.
I prezzi in euro indicati si basano su un tasso di cambio ipotetico di 1 dollaro USA = 0,89 € e rappresentano valori approssimativi arrotondati. I costi effettivi possono variare a seconda del fornitore di servizi cloud, della configurazione, del carico di lavoro e di eventuali sconti. L’IVA e le commissioni di cambio non sono incluse.
Perché i costi dell’infrastruttura cloud di Databricks devono essere considerati separatamente?
Un malinteso comune riguarda i costi complessivi di Databricks. I costi DBU variano a seconda del tipo di cluster e del carico di lavoro e vengono pagati direttamente a Databricks. L'infrastruttura cloud sottostante viene fatturata separatamente dal fornitore di servizi cloud. La tua fattura mensile di Databricks è quindi composta di fatto da due voci di costo, che dovrebbero essere considerate separatamente durante le trattative con il fornitore (Software Pricing Guide).
Quanto costa Snowflake nella pratica? Un esempio di calcolo
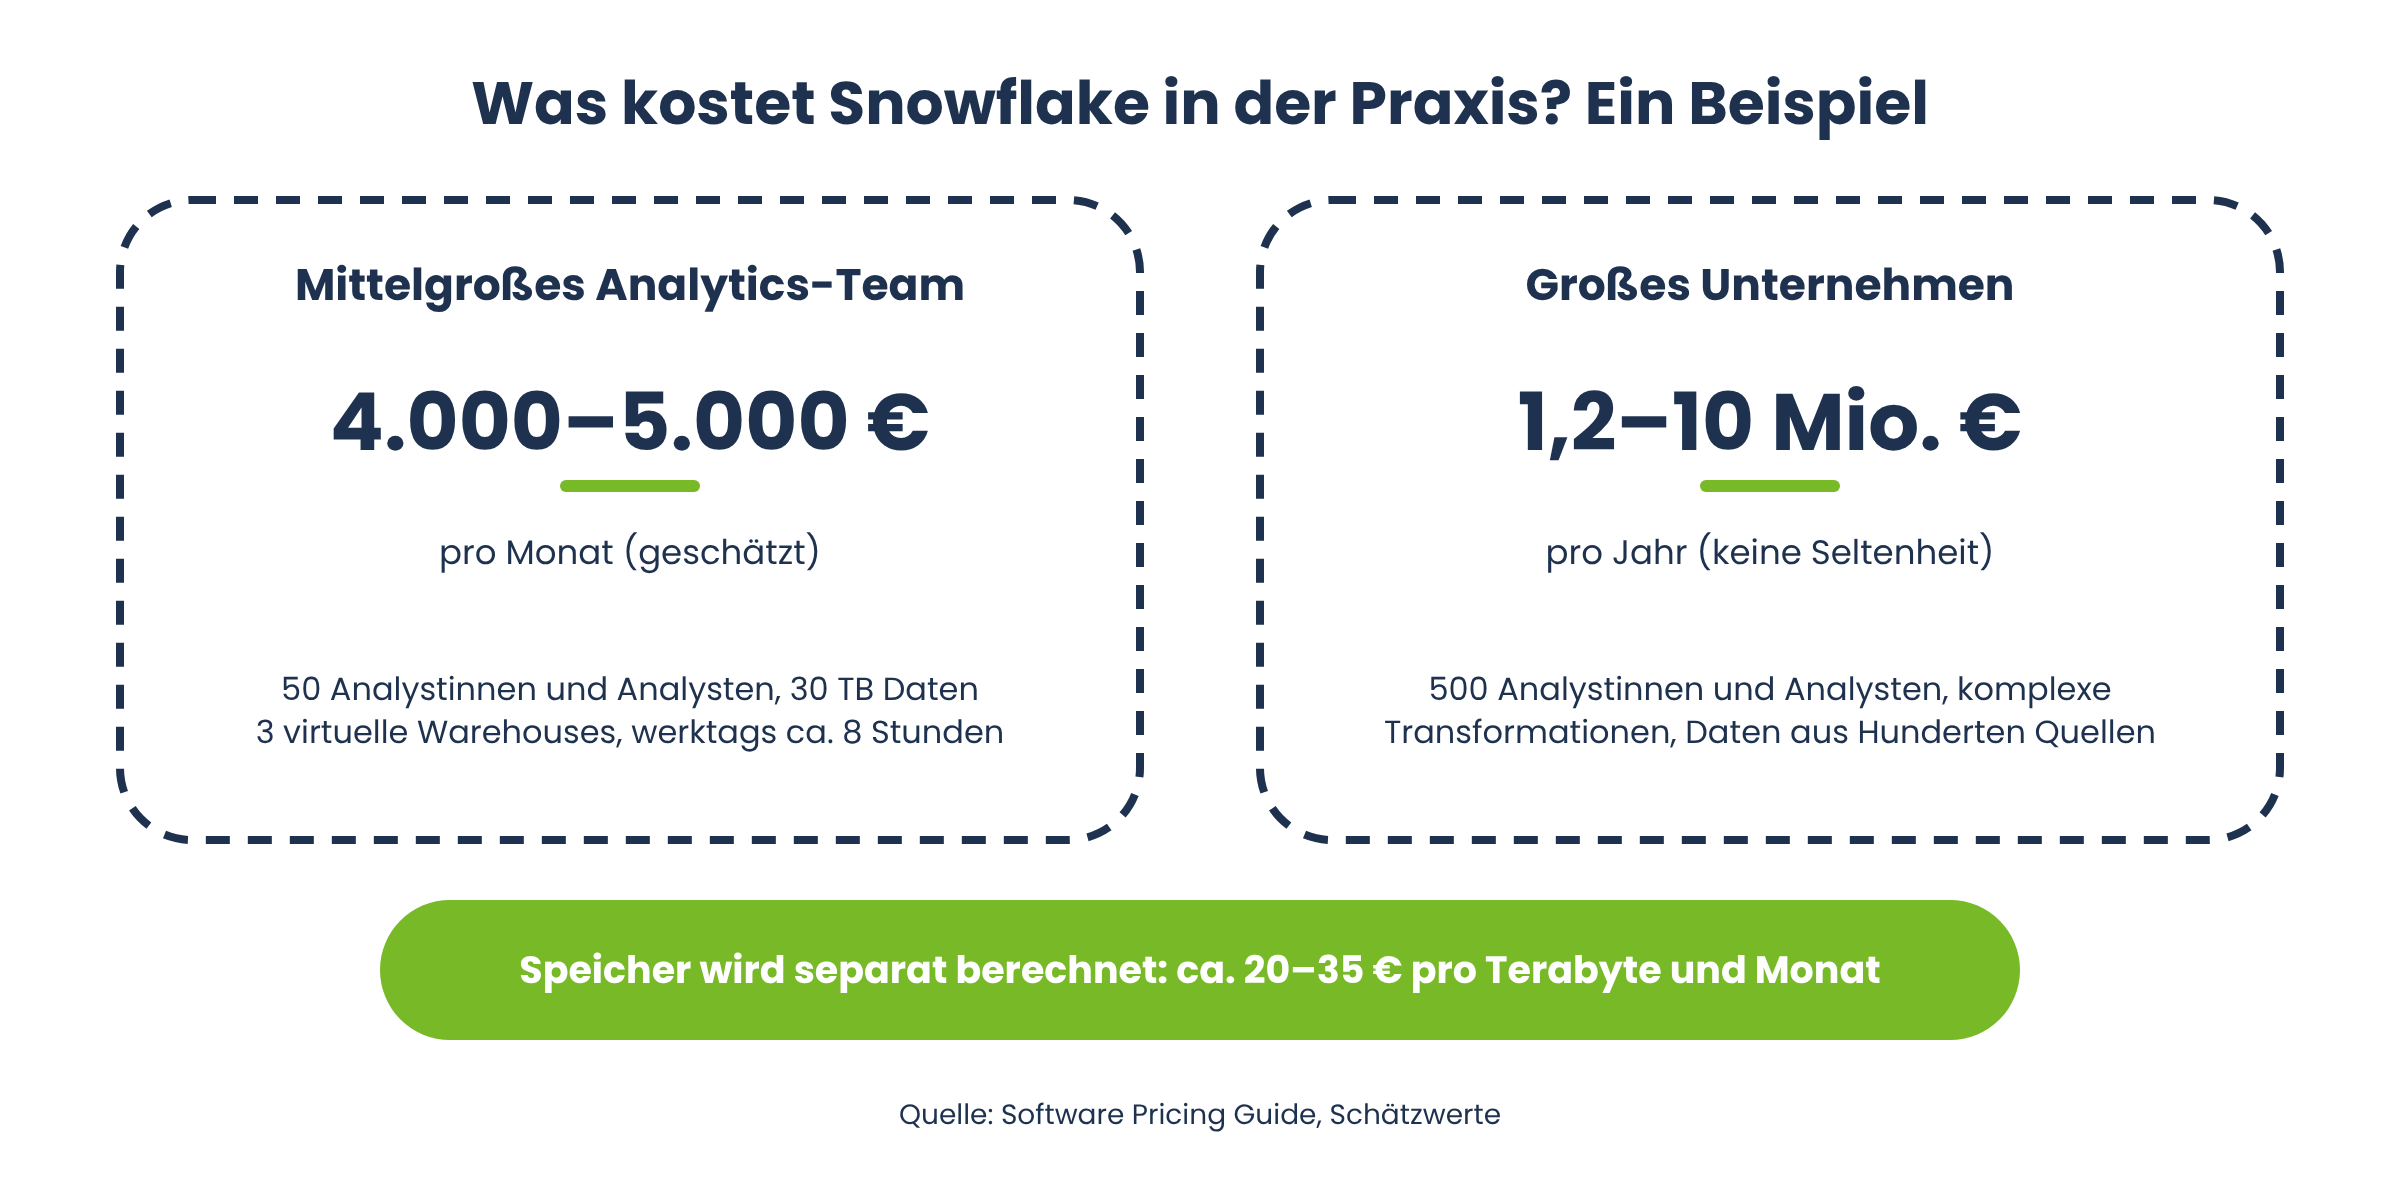
I numeri sono più utili dei modelli di prezzo astratti. Un team di analisi di medie dimensioni, composto da circa 50 analisti che gestiscono carichi di lavoro BI classici, con 30 terabyte di dati compressi e tre data warehouse virtuali in esecuzione per circa otto ore nei giorni lavorativi, a un costo totale stimato compreso tra circa 4.000 e 5.000 euro al mese, ovvero tra circa 40.000 e 60.000 euro all’anno. Se si estende questo scenario a una grande azienda con 500 analisti, trasformazioni complesse e processi di caricamento dati continui da centinaia di fonti, non è raro che il costo annuale di Snowflake si aggiri tra 1,2 e 10 milioni di euro (Software Pricing Guide).
Lo spazio di archiviazione in Snowflake viene fatturato separatamente: Snowflake addebita circa 20-35 euro per terabyte al mese, a seconda del fornitore di servizi cloud e del livello di compressione. Grazie alla compressione basata sulle colonne, un tipico set di dati viene spesso ridotto a un terzo del suo volume originale.
Quanto costa Databricks nella pratica?
Con Databricks non è possibile fornire un esempio di calcolo altrettanto semplice, poiché i costi dipendono fortemente dalla composizione del carico di lavoro: il «Jobs Compute» per le pipeline automatizzate è più conveniente dell’«All-Purpose Compute» per i notebook interattivi, mentre il «Model Serving» per l’esecuzione dei modelli di ML viene solitamente fatturato in base ai token o al tempo di elaborazione. La struttura dei costi di Databricks può risultare complessa, soprattutto in caso di utilizzo intensivo e parallelo di diversi tipi di cluster. Chi desidera effettuare una stima realistica dei costi di Databricks dovrebbe quindi considerare congiuntamente i costi della DBU, quelli dell’infrastruttura cloud e l’impegno interno necessario per l’ottimizzazione dei cluster.
Costo totale di proprietà (TCO): chi risulta più conveniente alla fine?
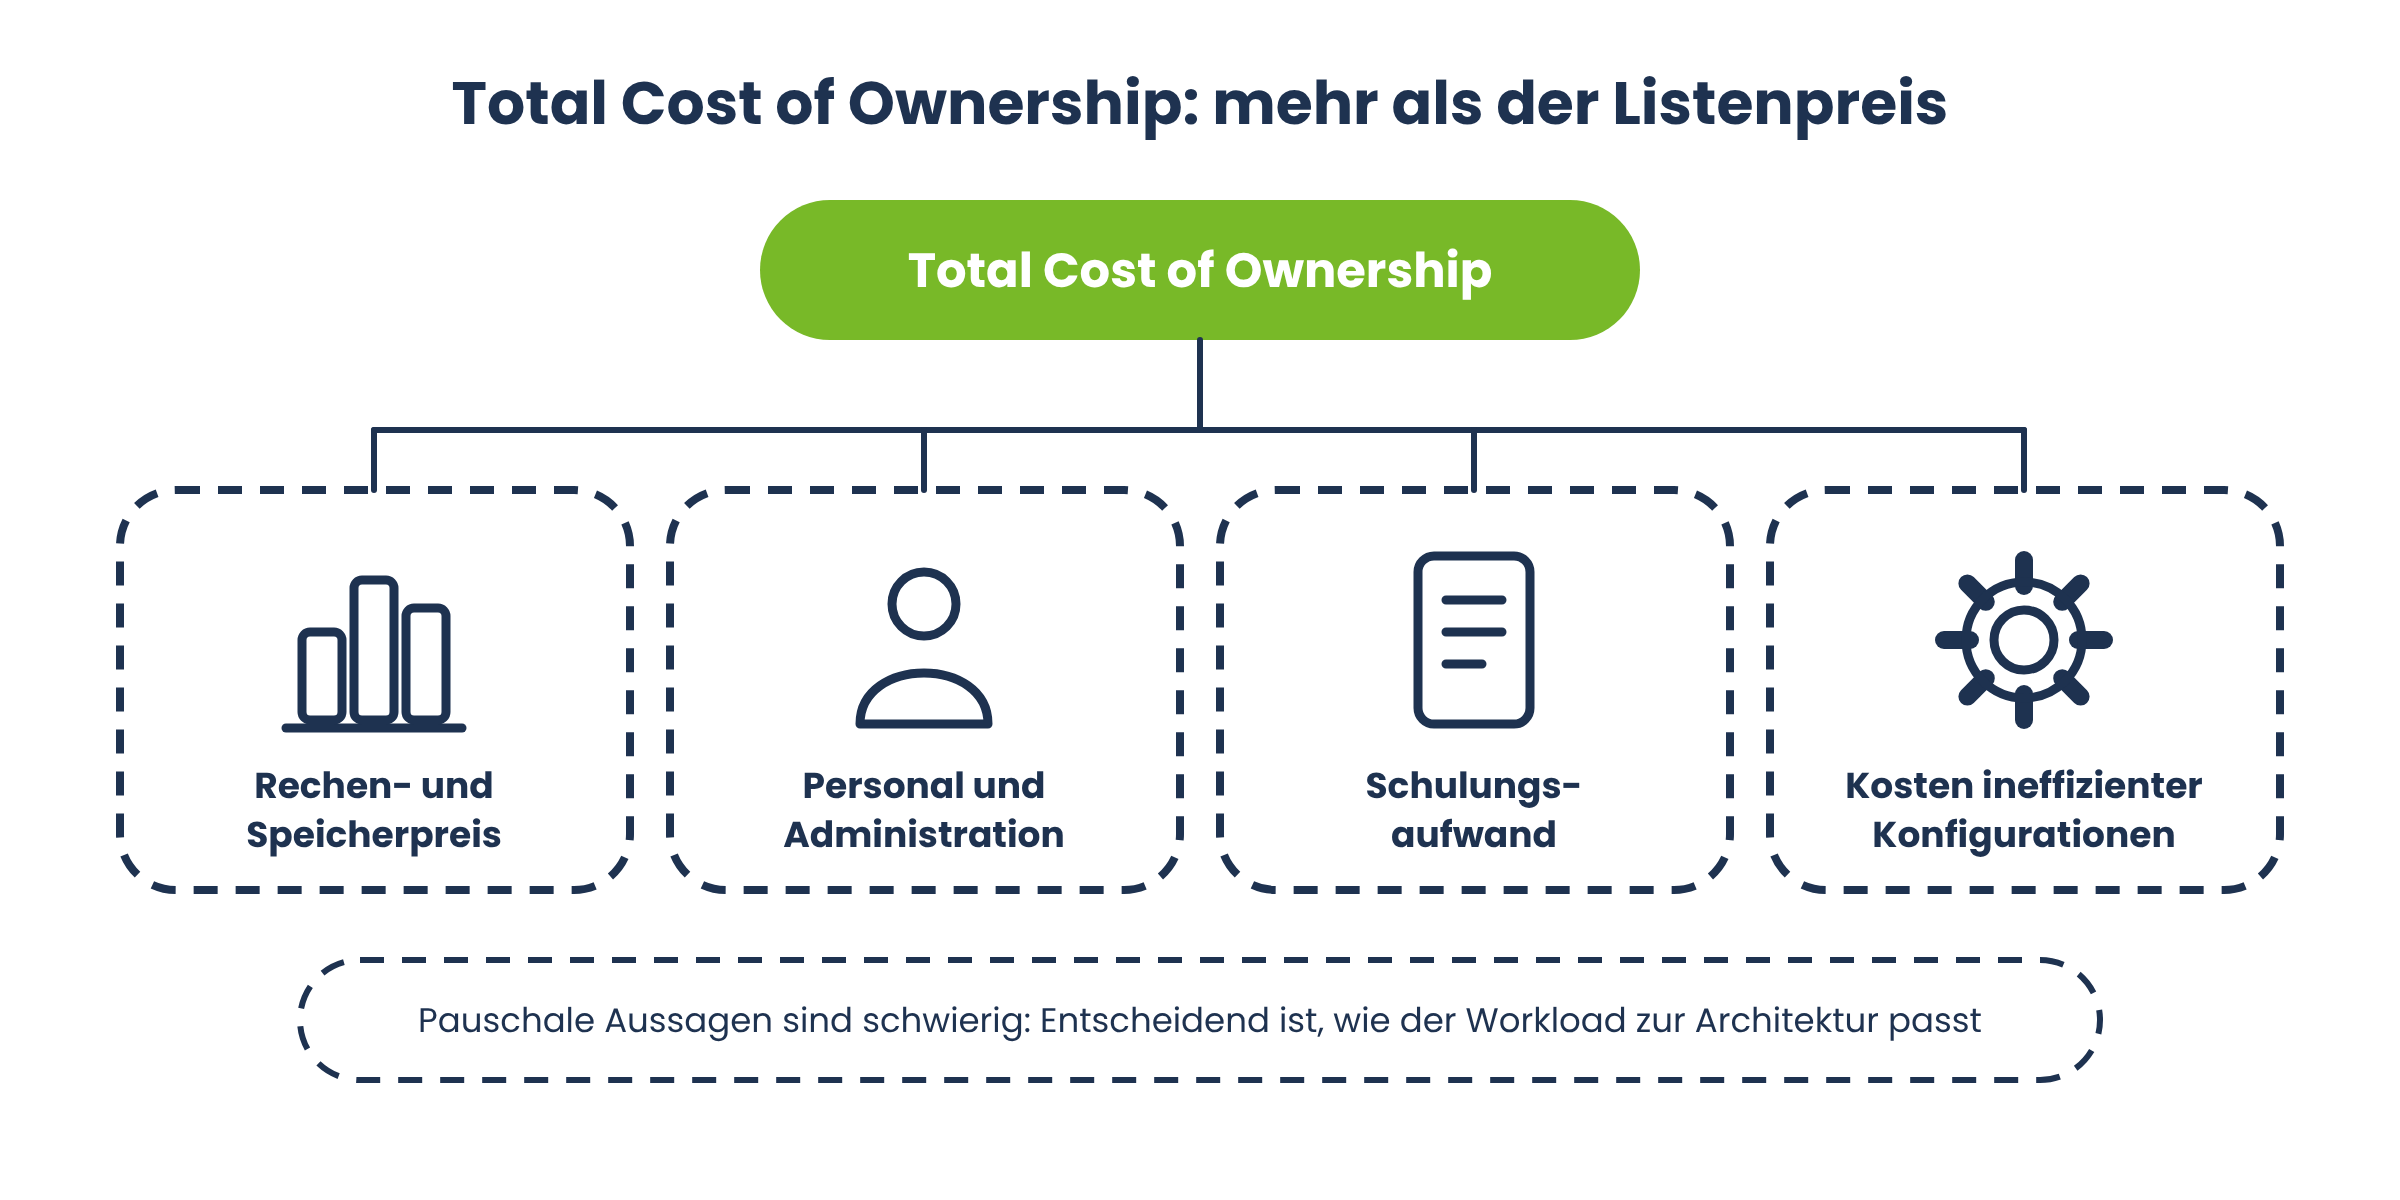
Il costo totale di proprietà descrive i costi complessivi di una piattaforma per l’intero periodo di utilizzo, non solo il semplice prezzo della potenza di calcolo e dello spazio di archiviazione. Sono inclusi anche i costi del personale per l’amministrazione, i costi di formazione e i costi derivanti da configurazioni inefficienti. La scelta tra Databricks e Snowflake dipende dai requisiti specifici, ed è proprio questo che rende così difficile formulare affermazioni generali sul TCO.
Quando Snowflake è più conveniente?
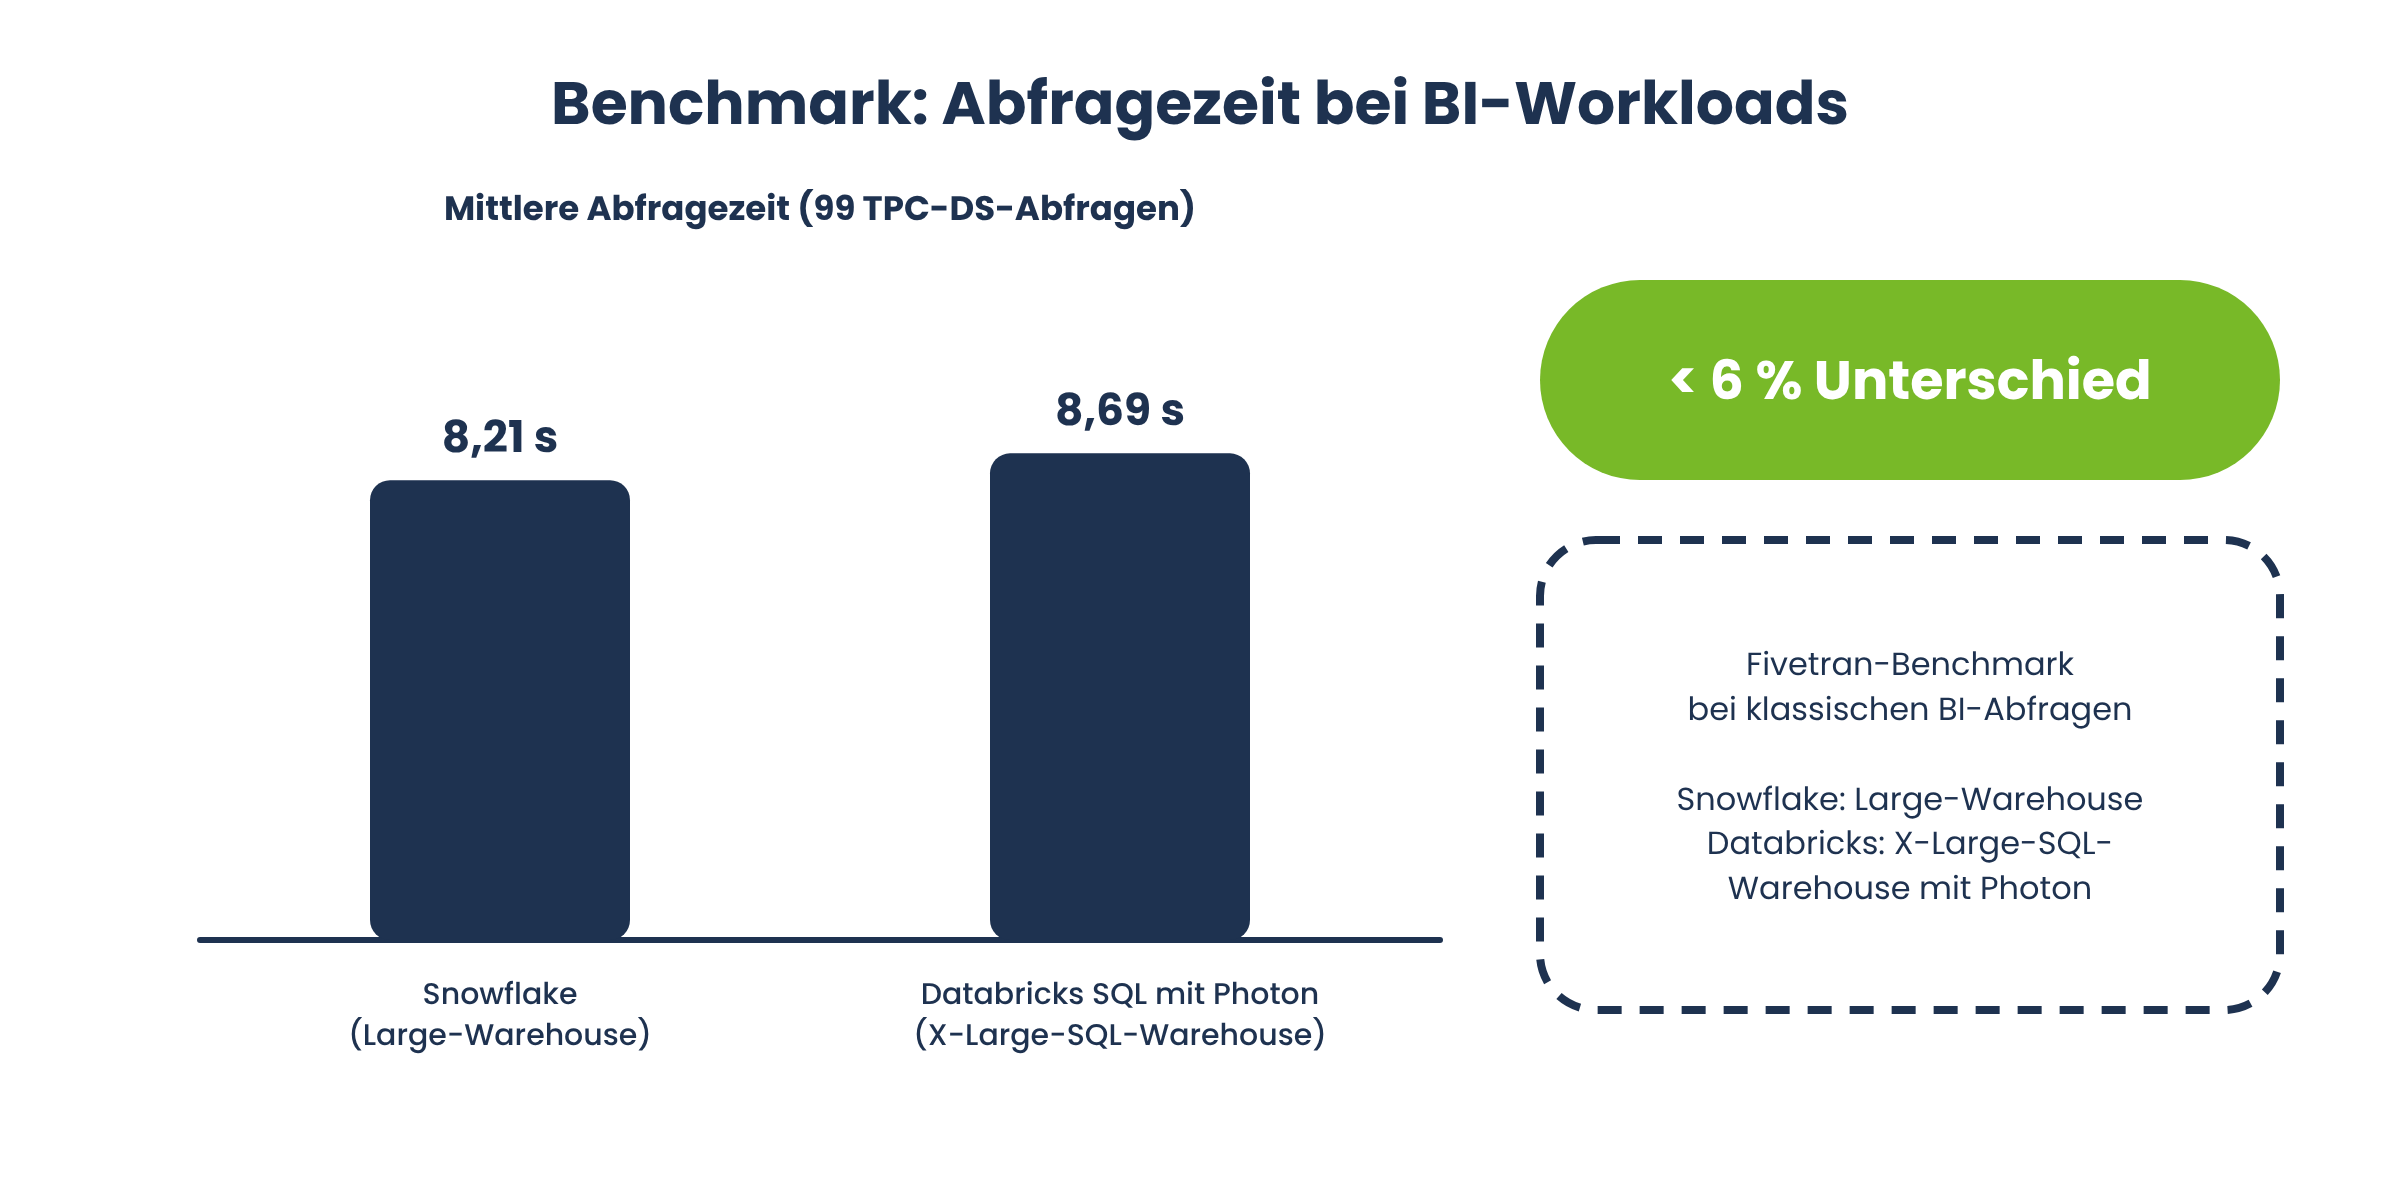
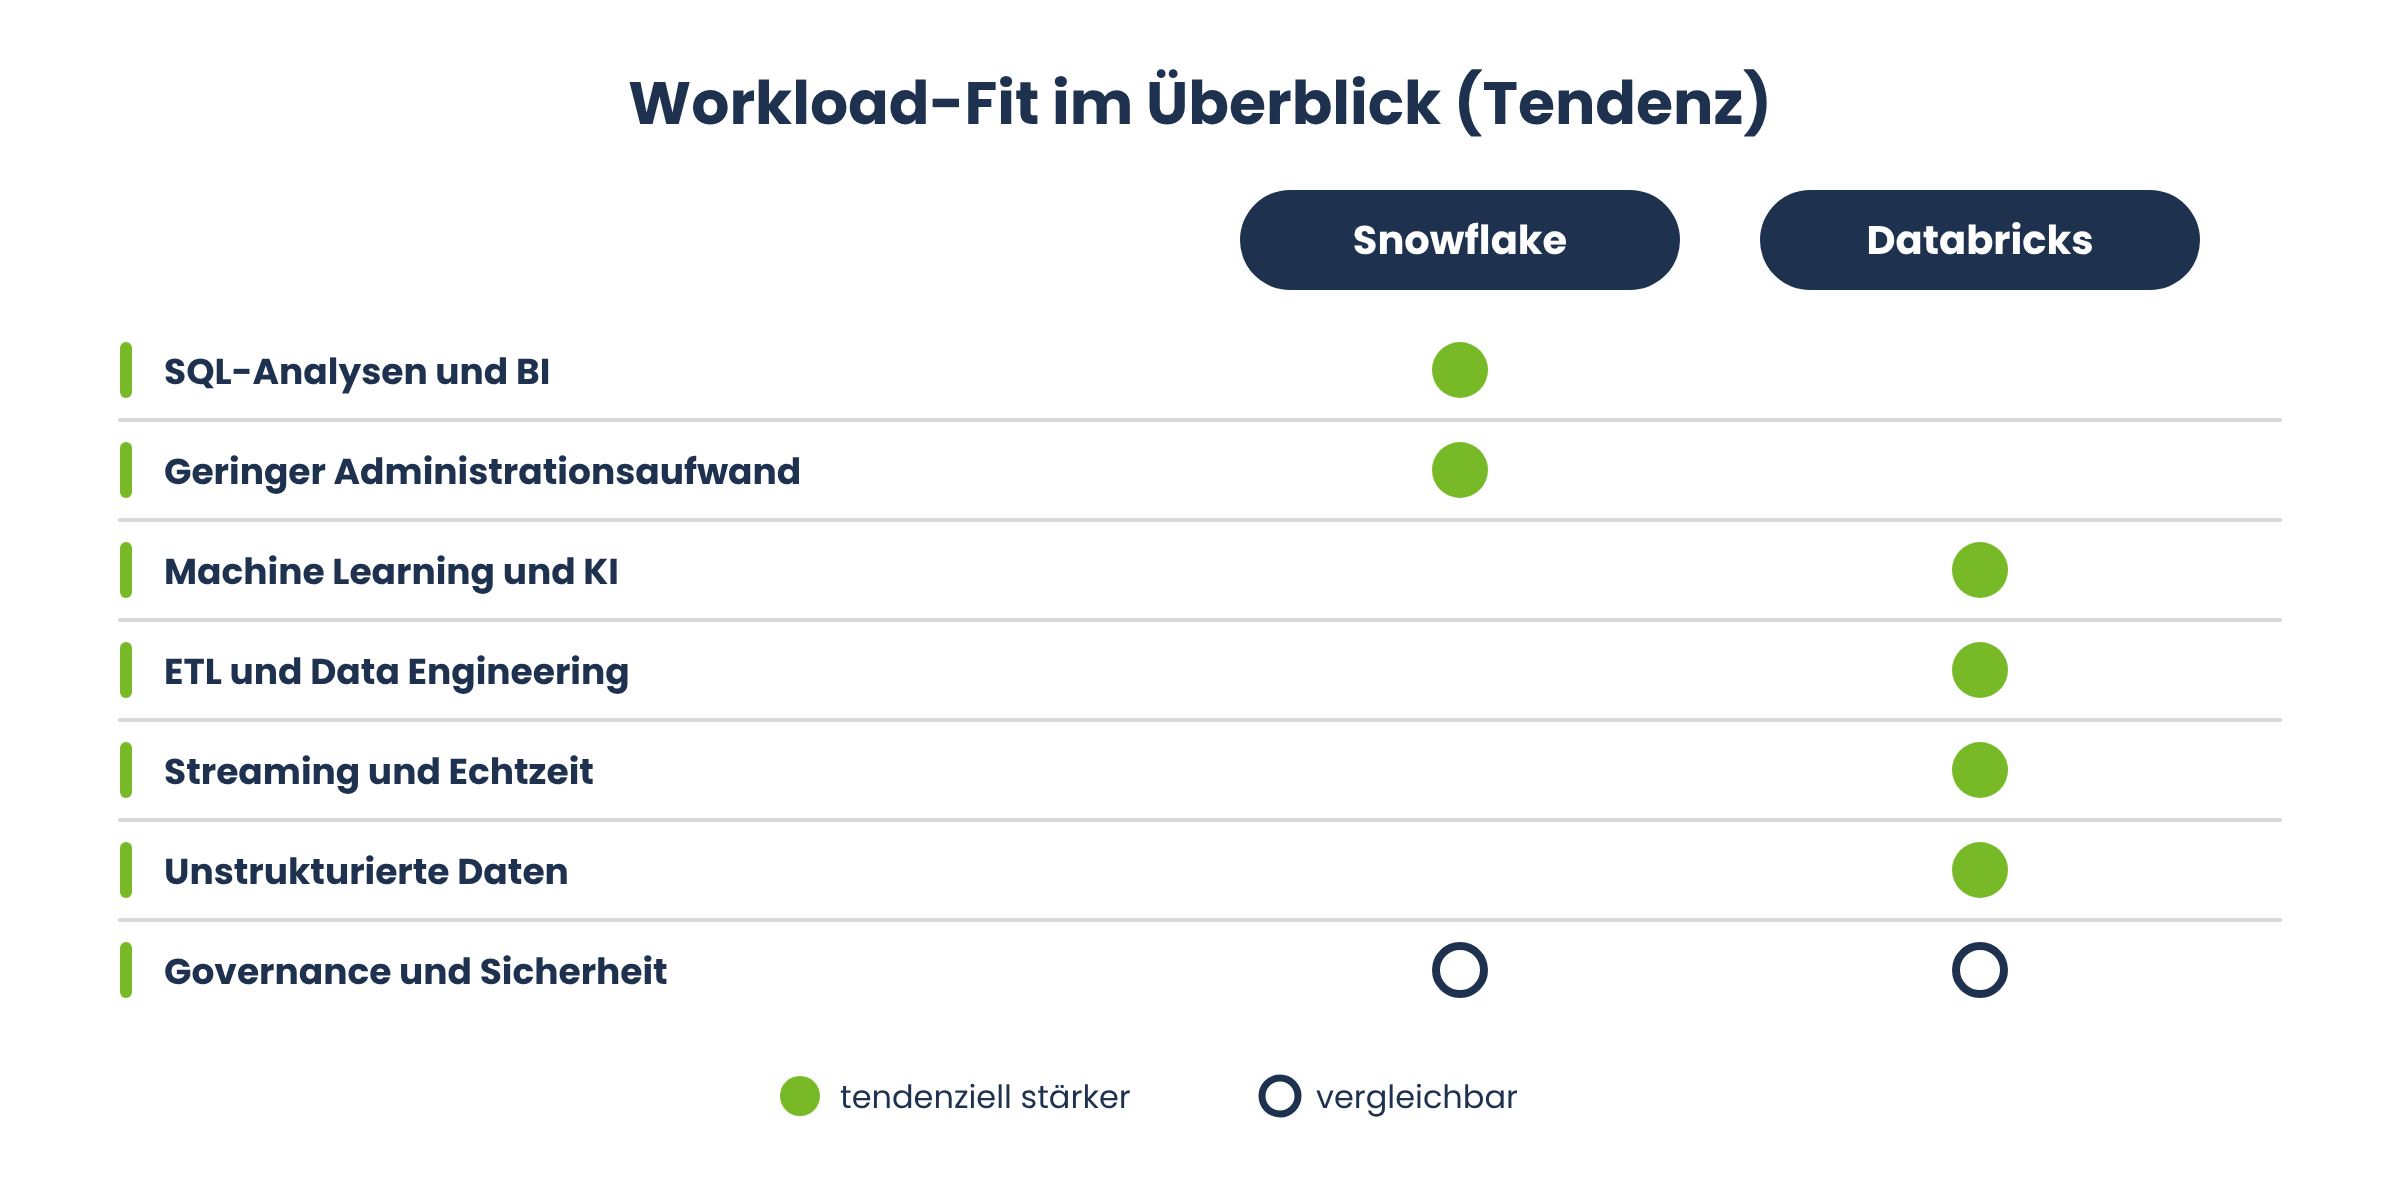
Per le analisi SQL pure e i carichi di lavoro BI, Snowflake è spesso la scelta più conveniente. Il modello di parallelismo, il ridimensionamento automatico e le prestazioni di query ottimizzate per carichi di lavoro SQL di grandi dimensioni garantiscono che le aziende con esigenze di reporting tradizionali ottengano spesso un costo totale di proprietà (TCO) inferiore con Snowflake (Guida ai prezzi del software). Anche benchmark indipendenti confermano questa tendenza: il benchmark Fivetran, basato sulle 99 query ufficiali TPC-DS, ha rilevato per Snowflake su un Large-Warehouse un tempo medio di esecuzione delle query pari a 8,21 secondi, contro gli 8,69 secondi di Databricks SQL con Photon su un X-LargeSQL Warehouse – una differenza inferiore al 6% nelle query BI classiche (Tech Insider).
Quando è più conveniente Databricks?
Per il machine learning, l'intelligenza artificiale e il data engineering con Python o Spark, Databricks è generalmente più conveniente e performante. Databricks può garantire un costo totale di proprietà (TCO) inferiore per carichi di lavoro misti quando l’ingegneria dei dati, l’ETL e l’apprendimento automatico avvengono sulla stessa piattaforma, anziché integrare strumenti aggiuntivi (Guida ai prezzi del software).
Perché un semplice confronto dei prezzi non è sufficiente?
Il prezzo di listino per unità di calcolo dice ben poco sui costi effettivi. Ciò che conta è quanto un carico di lavoro sia adatto alla rispettiva architettura. Un esempio pratico: una compagnia assicurativa con report SQL stabili e pianificabili durante la notte spesso trova più conveniente utilizzare Snowflake, poiché i data warehouse inutilizzati vengono automaticamente messi in pausa. Un’azienda con streaming continuo di dati provenienti da sensori e addestramento di modelli, invece, beneficia spesso della flessibilità dei cluster Databricks.
Come è possibile ridurre i costi di entrambe le piattaforme?
Entrambi i fornitori offrono sconti significativi rispetto all'utilizzo on-demand se le aziende si impegnano a lungo termine.
Sconti e contratti di capacità con Snowflake
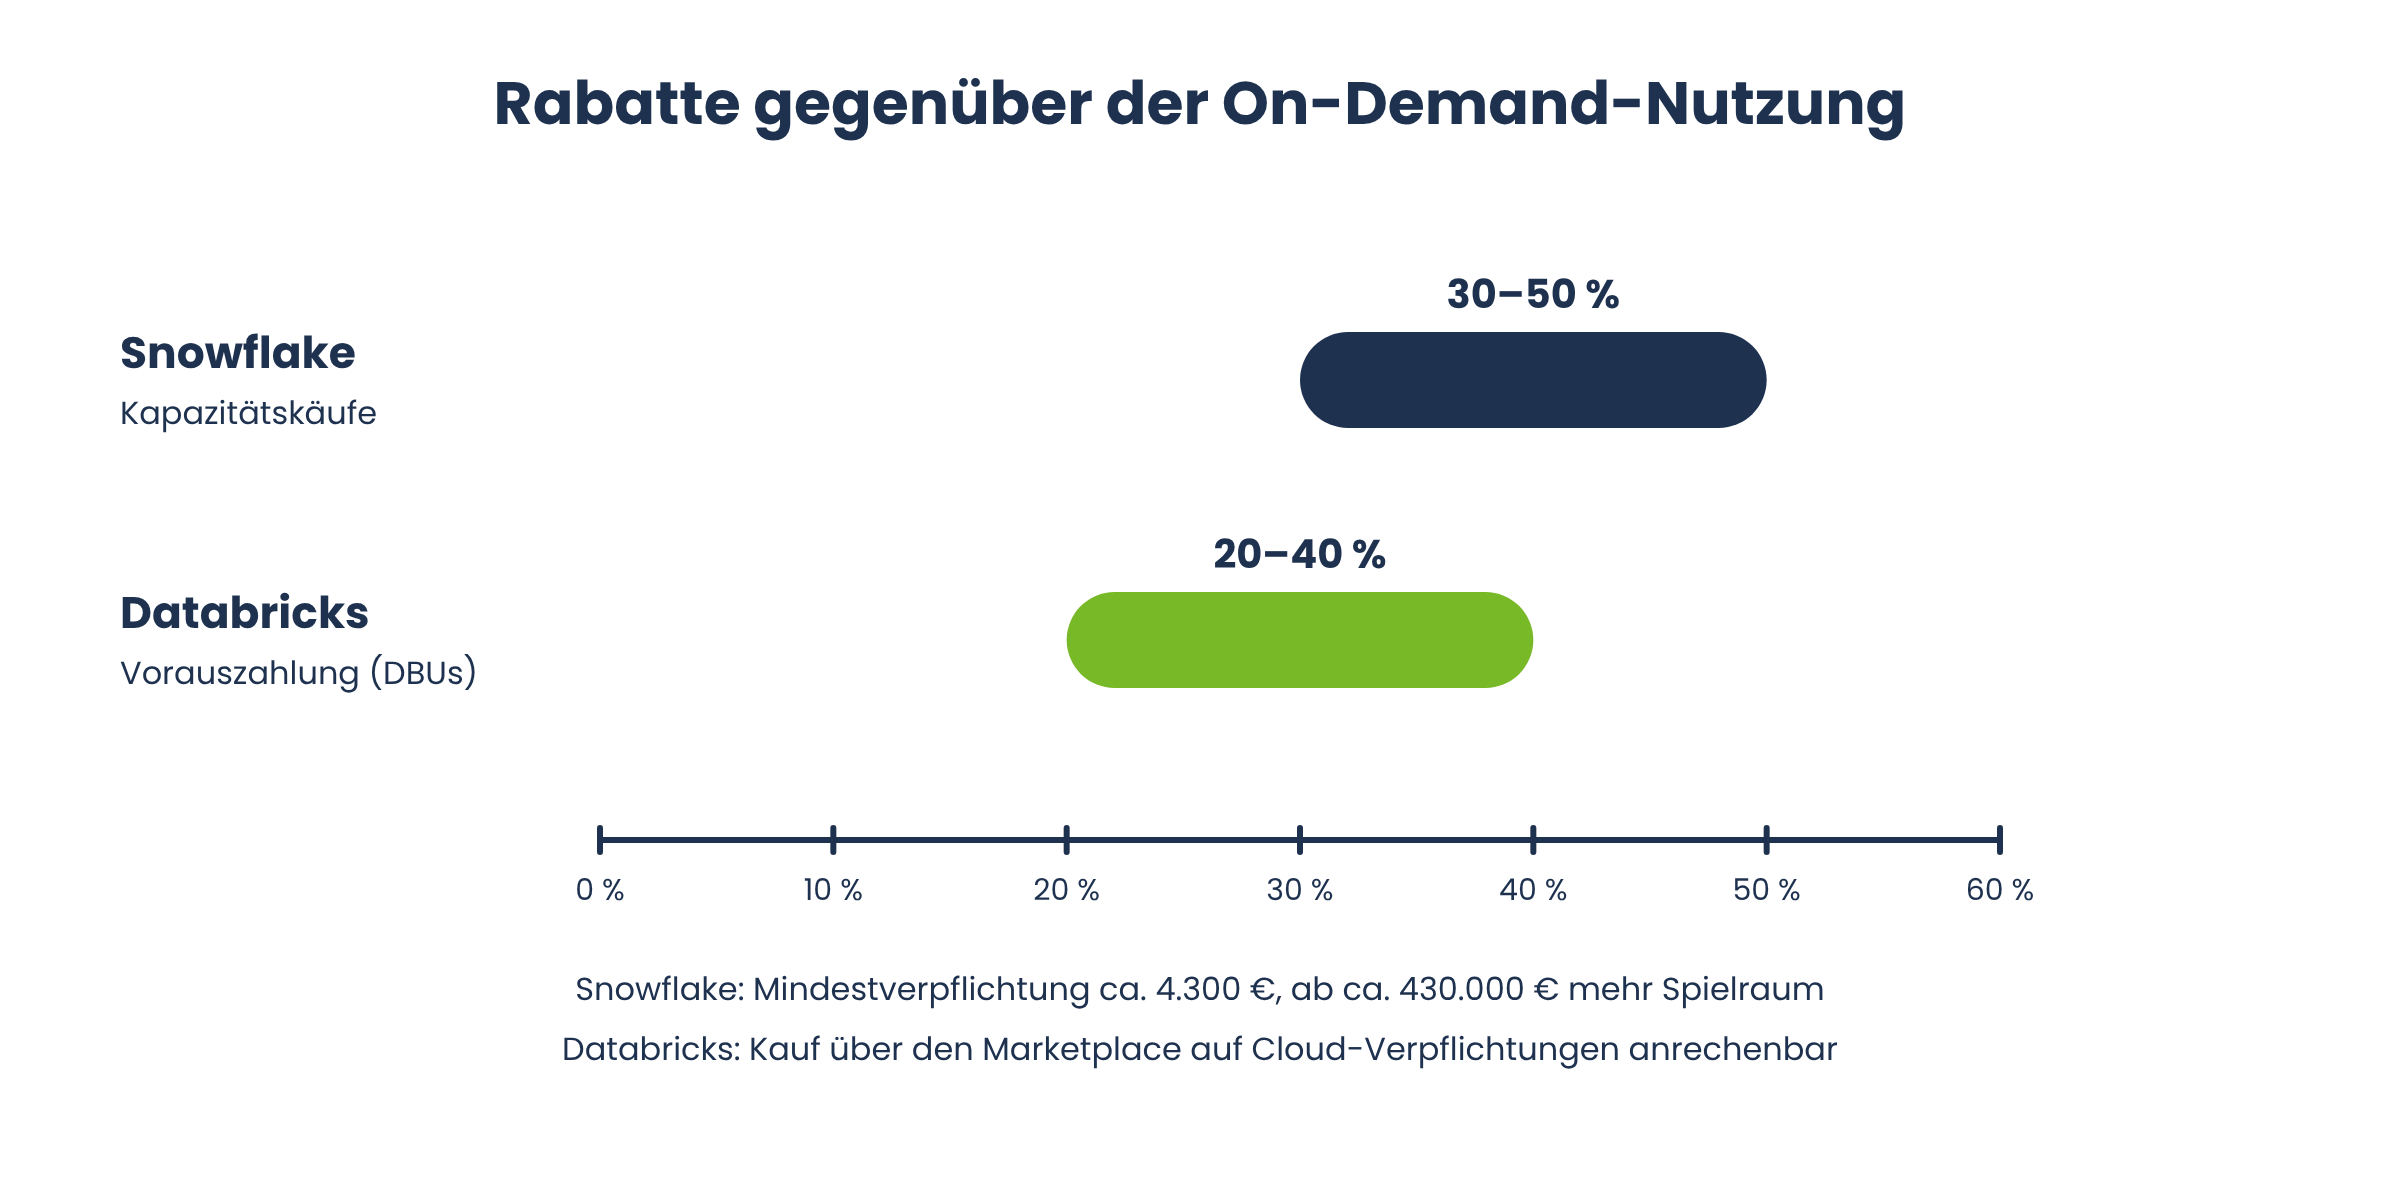
Snowflake può ridurre i costi dal 30 al 50% grazie all'acquisto di capacità. L’impegno minimo per i prezzi basati sulla capacità è solitamente di circa 4.300 euro; impegni annuali più consistenti, a partire da circa 430.000 euro, offrono un margine di manovra commerciale aggiuntivo e un referente dedicato (Software Pricing Guide).
Sconti e modelli prepagati di Databricks
Databricks offre sconti dal 20 al 40% sui pagamenti anticipati per le DBU. Gli accordi prepagati annuali e pluriennali rappresentano il modello commerciale più diffuso tra i clienti Enterprise. Inoltre, gli acquisti effettuati tramite il marketplace di Databricks su AWS, Azure o GCP possono spesso essere imputati agli impegni cloud esistenti, generando un ulteriore vantaggio in termini di costi (Software Pricing Guide).
Elaborazione dei dati: dati strutturati e non strutturati
Una differenza fondamentale tra Databricks e Snowflake risiede nei tipi di dati che possono essere elaborati in modo efficiente. Snowflake è storicamente specializzato in dati strutturati come tabelle e formati di database classici, ma ora supporta anche formati semistrutturati come JSON o XML e dati non strutturati come immagini o video. Databricks, invece, è adatto sia ai dati strutturati che a quelli non strutturati: immagini, video, testo libero, file di log e dati dei sensori possono essere archiviati direttamente nel data lake e utilizzati per progetti di machine learning senza dover essere prima convertiti in uno schema tabellare fisso.
Che cos’è Unity Catalog e perché è importante per Databricks?
Unity Catalog è il livello centrale di governance di Databricks per i dati e le risorse di intelligenza artificiale. Offre un unico punto di riferimento per gestire i diritti di accesso, tracciare la provenienza dei dati, classificare i dati sensibili e monitorare la qualità dei dati oltre i confini del cloud (Databricks). Prima dell’introduzione di Unity Catalog, le aziende dovevano spesso combinare diversi strumenti di governance, ad esempio per il controllo degli accessi, la tracciabilità della provenienza dei dati e la conformità. Unity Catalog riunisce queste funzionalità e le rende gestibili tramite comandi SQL standard come GRANT e REVOKE.
Che cos’è Delta Lake e quale ruolo svolge nell’approccio Lakehouse?
Delta Lake è il formato di archiviazione aperto su cui si basa l'architettura Lakehouse di Databricks. Esso amplia i classici formati di data lake con la sicurezza delle transazioni, il controllo delle versioni e l'applicazione dello schema, funzionalità che finora erano riservate soprattutto ai database tradizionali. Per te questo significa che puoi archiviare grandi quantità di dati in un cloud object storage economico, senza dover rinunciare all’affidabilità di un data warehouse tradizionale.
Condivisione dei dati: come funziona il Delta Sharing rispetto alla condivisione dei dati di Snowflake?
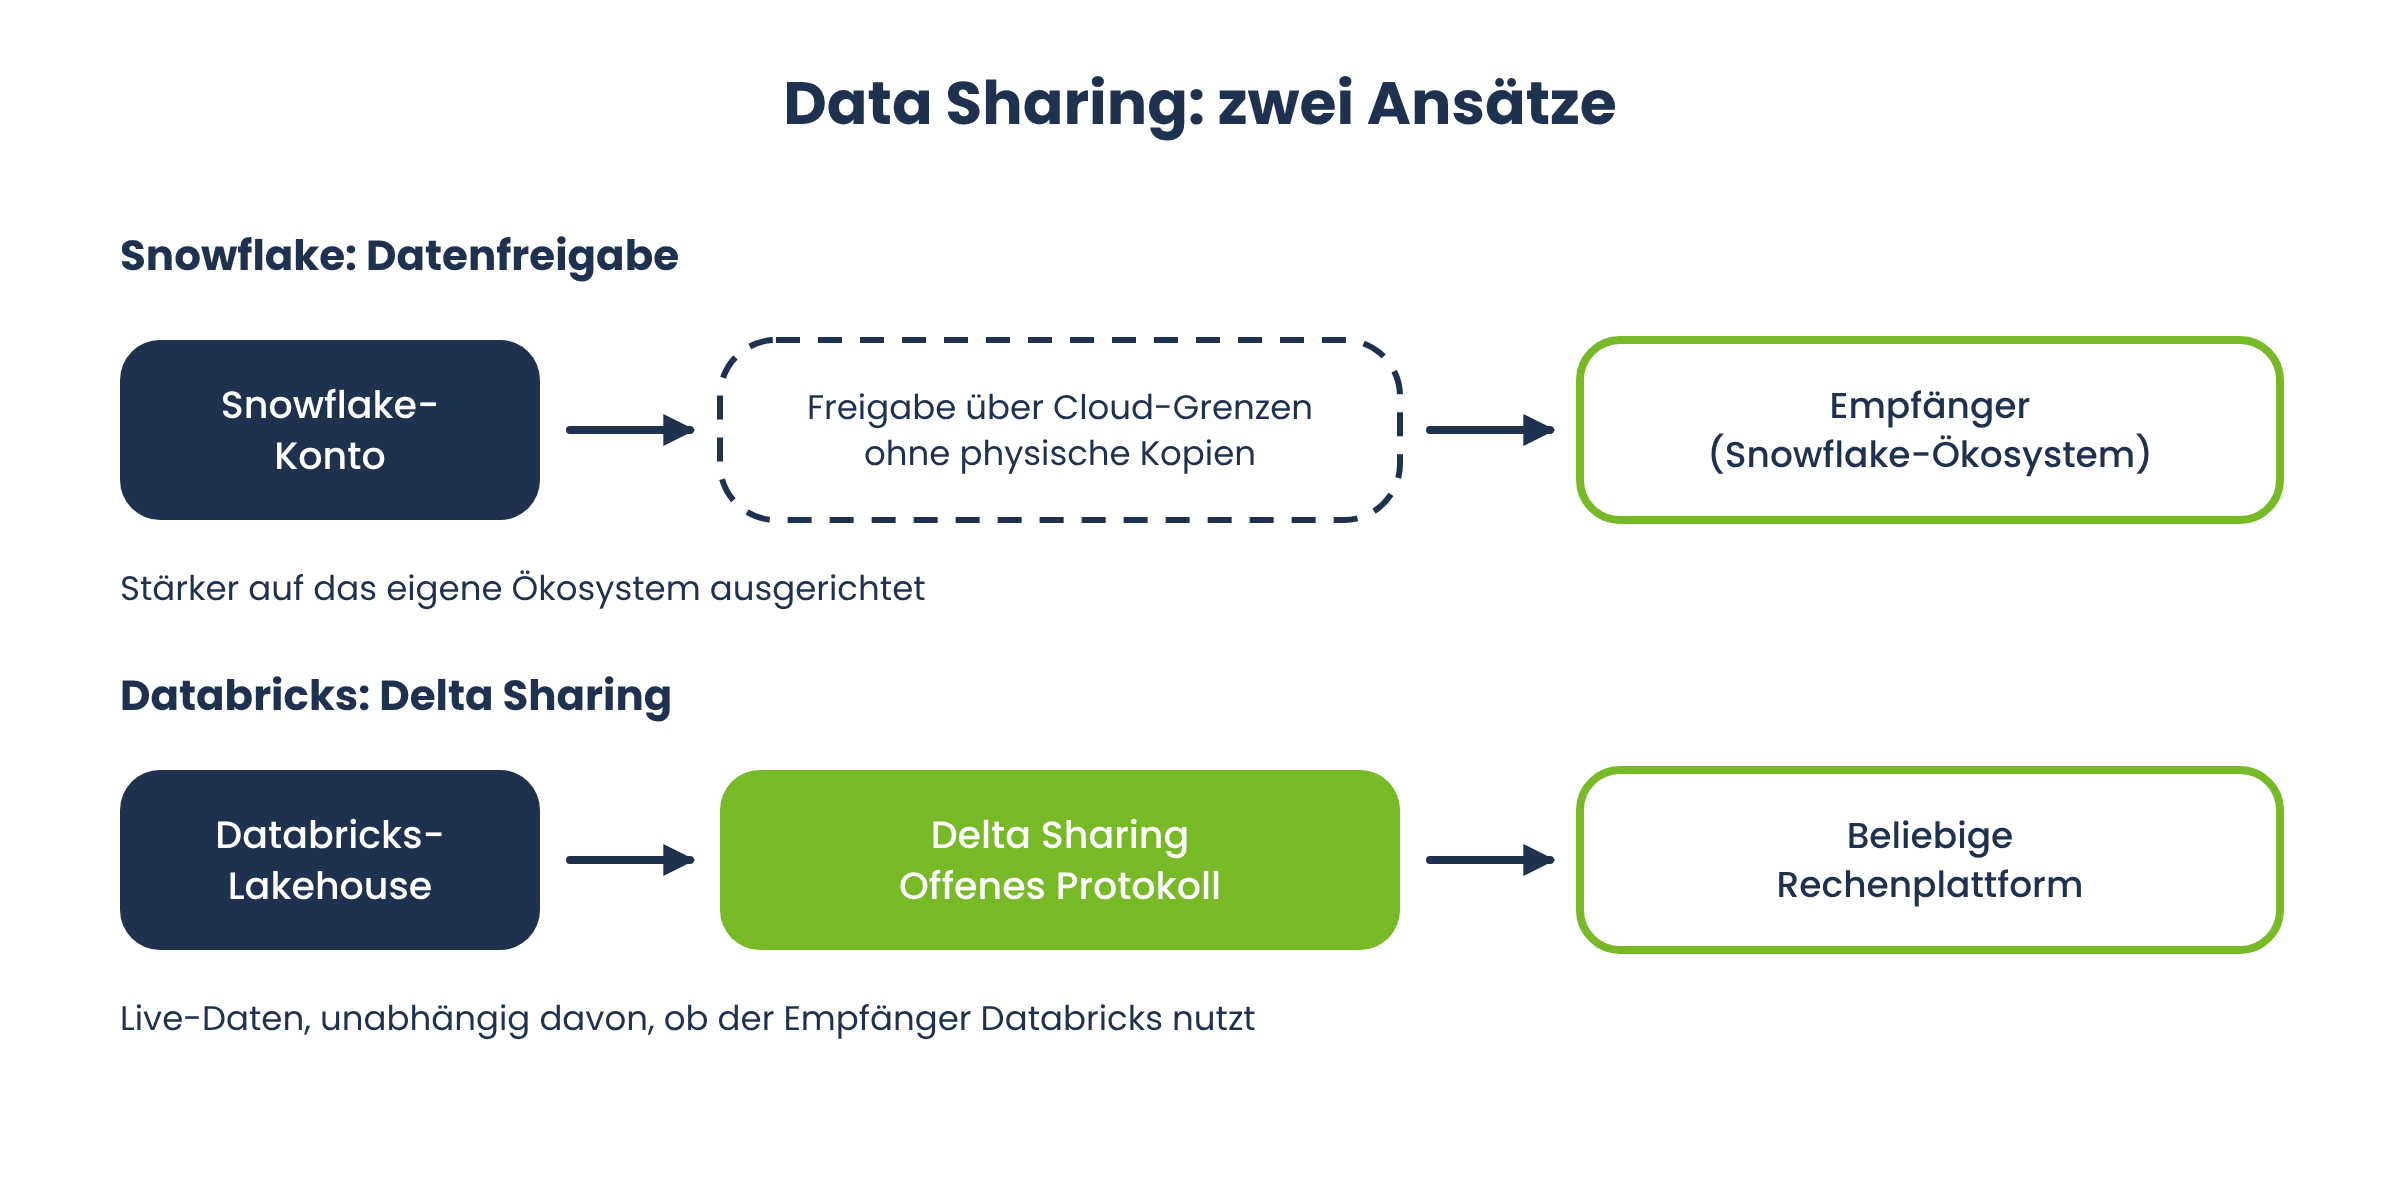
Entrambe le piattaforme attribuiscono grande importanza allo scambio sicuro dei dati tra le aziende. L’architettura di Snowflake consente una condivisione dei dati senza soluzione di continuità oltre i confini del cloud, senza la necessità di copiare fisicamente i dati. Databricks si affida a Delta Sharing, un protocollo aperto che consente di condividere dati in tempo reale dal Lakehouse con qualsiasi altra piattaforma di elaborazione, indipendentemente dal fatto che il destinatario utilizzi o meno Databricks. Per le aziende che scambiano dati con partner, fornitori o clienti, questa differenza è rilevante: Delta Sharing si basa su uno standard aperto, mentre la condivisione dei dati di Snowflake è maggiormente orientata al proprio ecosistema.
Machine learning e IA: in quali ambiti Databricks è all’avanguardia?
Databricks è nato da Apache Spark e ha integrato il Machine Learning nel cuore della piattaforma sin dall’inizio. Databricks tende ad essere più adatto alle analisi basate sui dati con una componente di ML estesa e, grazie a MLflow, Feature Store e Model Serving, offre un ambiente end-to-end per l’intero ciclo di vita del Machine Learning, dall’addestramento alla distribuzione. Negli ultimi anni Snowflake ha recuperato terreno con Cortex AI e Snowpark ML, ma spesso rimane in svantaggio rispetto all’ambiente Spark nativo di Databricks quando si tratta di modelli complessi addestrati su misura e di addestramento distribuito.
Analisi SQL e Business Intelligence: il punto di forza di Snowflake
Snowflake è ottimizzato per query SQL ad alte prestazioni e per le classiche applicazioni di Business Intelligence. Se il tuo team lavora prevalentemente con SQL, crea dashboard ed esegue analisi ad hoc, Snowflake offre una soglia di accesso particolarmente bassa: Snowflake è progettato per applicazioni di business intelligence basate su SQL, senza che gli utenti debbano configurare cluster o possedere conoscenze di Spark. Questa semplicità è uno dei motivi principali per cui molti team di BI preferiscono Snowflake a Databricks.
Data engineering e carichi di lavoro ETL/ELT
ETL ed ELT, ovvero l'estrazione, la trasformazione e il caricamento dei dati, sono tra le attività che richiedono più risorse nelle moderne infrastrutture di dati. Databricks è più adatto a pipeline ETL di grandi dimensioni e a progetti di machine learning, poiché il supporto nativo di Spark consente di elaborare in parallelo trasformazioni complesse. La stessa Databricks sottolinea che, secondo un proprio confronto, i carichi di lavoro ETL su Snowflake possono risultare fino a nove volte più costosi rispetto alla piattaforma Databricks Lakehouse – un dato che va considerato come indicativo e che varia notevolmente a seconda del carico di lavoro (Databricks). Indipendentemente dalla cifra esatta, vale quanto segue: i carichi di lavoro ETL rappresentano spesso il 50% o più dei costi complessivi della piattaforma dati di un’azienda, motivo per cui vale in ogni caso la pena effettuare un’analisi approfondita.
Data lake e data warehouse: qual è la differenza?
I data lake e i data warehouse seguono filosofie diverse. Un data warehouse memorizza dati pre-strutturati e puliti per il reporting e le analisi, mentre un data lake memorizza dati grezzi in quasi qualsiasi formato e struttura. Snowflake proviene dalla tradizione dei data warehouse, mentre Databricks dal mondo dei data lake; tuttavia, nell’approccio Lakehouse, combina la governance di un warehouse con la flessibilità di un lake. Per molte aziende, è proprio questa combinazione il motivo per cui scelgono un approccio Lakehouse anziché un warehouse classico.
Confronto tra governance e sicurezza
Snowflake offre potenti funzionalità di governance e condivisione dei dati, tra cui il controllo degli accessi basato sui ruoli, il mascheramento dinamico dei dati e la sicurezza a livello di riga come funzionalità standard. Databricks, con Unity Catalog, offre un livello di governance altrettanto approfondito, che tratta inoltre i modelli di IA, le funzioni e gli agenti come oggetti indipendenti e proteggibili. Per i settori regolamentati, come quello assicurativo o il settore pubblico, è fondamentale che entrambe le piattaforme offrano certificazioni di conformità e controlli di accesso altamente granulari, sebbene con livelli di maturità diversi a seconda del piano tariffario scelto.
Infrastruttura cloud: supporto multi-cloud su entrambe le piattaforme
Snowflake supporta AWS, Azure e GCP, consentendo alle aziende di utilizzare Snowflake indipendentemente dal provider cloud esistente. Anche Databricks si integra strettamente con i servizi cloud-native ed è disponibile su tutti e tre i principali hyperscaler. Entrambe le piattaforme supportano l’integrazione di fonti di dati distribuite, aspetto particolarmente rilevante per le aziende con ambienti IT eterogenei e in continua espansione. Rimane tuttavia una differenza: Databricks spesso si integra più strettamente con i servizi nativi del rispettivo provider cloud, come Azure Data Lake Storage o AWS Glue, mentre Snowflake offre consapevolmente un’esperienza uniforme su tutti i cloud.
Scalabilità: data warehouse virtuali vs. data warehouse SQL e cluster
Snowflake garantisce la scalabilità tramite magazzini virtuali che possono essere scalati su o giù in modo indipendente l’uno dall’altro in pochi secondi, senza necessità di ridistribuire i dati. Databricks garantisce la scalabilità tramite cluster e magazzini SQL che, a seconda della configurazione, aggiungono o rimuovono automaticamente nodi aggiuntivi. Entrambi gli approcci sono adatti all’elaborazione di dati su larga scala, ma differiscono nella gestione dettagliata: i warehouse di Snowflake sono più semplici da configurare, mentre i cluster di Databricks offrono un maggiore controllo sui tipi di istanza, sui limiti di autoscaling e sulle istanze spot.
Linguaggi di programmazione e facilità d'uso per gli sviluppatori
Databricks supporta diversi linguaggi di programmazione, tra cui Python, Scala, R e SQL, spesso combinabili all’interno dello stesso notebook. Ciò rende la piattaforma particolarmente interessante per i team di data scientist che lavorano con linguaggi diversi. Snowflake è stato a lungo incentrato principalmente su SQL, ma con Snowpark ha aggiunto il supporto per Python, Java e Scala. Per i team che dispongono prevalentemente di competenze in SQL, Snowflake rimane comunque la piattaforma più accessibile.
Casi d'uso: per quali aziende è adatto Snowflake?
Snowflake è ideale per le aziende che desiderano ridurre al minimo la gestione dell'infrastruttura e concentrarsi su analisi, reportistica e condivisione dei dati basate su SQL. I casi d'uso tipici sono:
Reporting BI centralizzato per diversi reparti aziendali.
Condivisione dei dati con partner o filiali senza copie dei dati.
Consolidamento di più sistemi legacy in un unico data warehouse centrale.
Applicazioni orientate alla conformità con elevati requisiti di governance.
Casi d'uso: per quali aziende è adatto Databricks?
Databricks è adatto per dati non strutturati e modelli di IA, nonché per le aziende la cui strategia sui dati è fortemente orientata al machine learning, alla GenAI e al data engineering. I casi d'uso tipici sono:
Addestramento e gestione di modelli di machine learning propri.
Elaborazione in tempo reale di dati in streaming provenienti da sensori IoT o impianti di produzione.
Creazione di pipeline ETL complesse e multistadio per fonti di dati eterogenee.
Applicazioni di IA generativa addestrate o ottimizzate sulla base dei dati aziendali.
Esempio pratico: un’azienda del settore retail sceglie Snowflake
Un'azienda di vendita al dettaglio con diverse centinaia di filiali desidera analizzare a livello centrale i dati di vendita giornalieri provenienti da diversi sistemi di cassa. Il requisito è ben definito: dati strutturati, cicli di reporting fissi, numerosi utenti simultanei nel reparto di controllo di gestione. In questo scenario, Snowflake convince grazie alla semplicità di gestione, al ridimensionamento automatico in caso di picchi di carico alla chiusura mensile e alla possibilità di condividere i dati direttamente con i partner in franchising senza dover realizzare integrazioni aggiuntive.
Esempio pratico: un’azienda industriale punta su Databricks
Un'azienda industriale raccoglie dati dai sensori degli impianti di produzione per prevedere i guasti. I dati vengono generati in modo continuo, con elevata frequenza e in diversi formati. È qui che Databricks mostra i suoi punti di forza: elaborazione in streaming quasi in tempo reale, librerie native di machine learning per la previsione dei guasti e la possibilità di archiviare i dati grezzi direttamente nel data lake senza necessità di una precedente conversione del formato.
Le aziende possono utilizzare Databricks e Snowflake insieme?
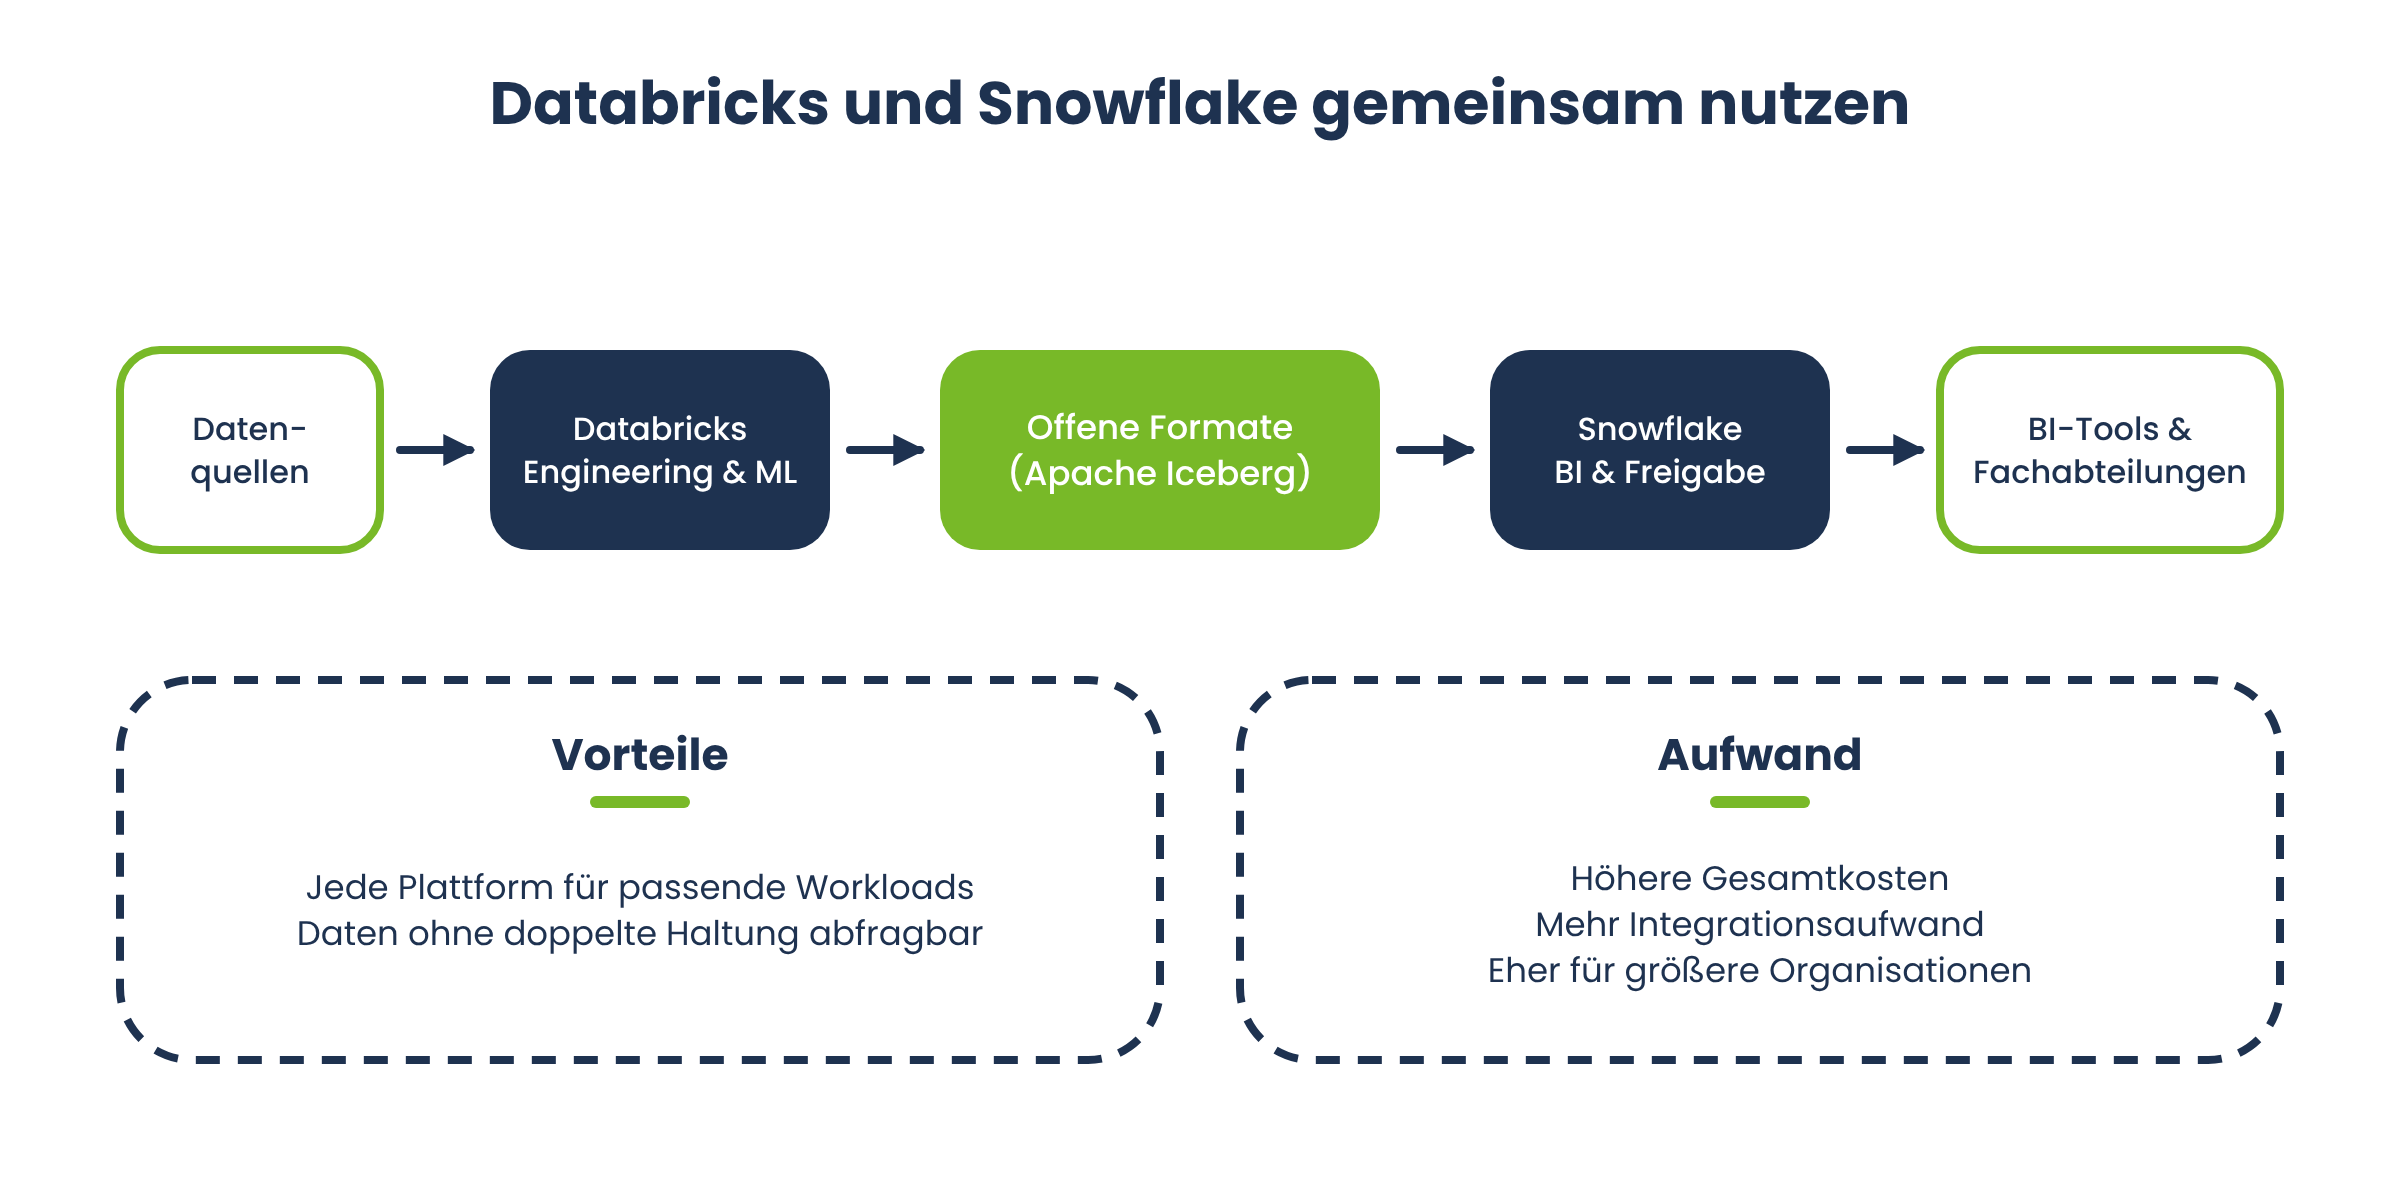
Sì, e nella pratica questa è ormai una delle scelte architetturali più comuni. Databricks si occupa del data engineering e dell’addestramento del machine learning, mentre Snowflake si occupa di fornire i dati puliti e conformi ai requisiti di governance agli strumenti di BI e ai reparti specialistici che utilizzano SQL. I formati di tabella aperti come Apache Iceberg consentono di interrogare i dati direttamente tra le due piattaforme, senza doverli mantenere in doppio. Questa combinazione risolve il problema dell’adattamento del carico di lavoro, ma aumenta anche i costi complessivi e lo sforzo di integrazione, motivo per cui è adatta soprattutto alle organizzazioni di grandi dimensioni che dispongono delle risorse adeguate.
I vantaggi di Snowflake in sintesi
Minimo sforzo amministrativo grazie a un'infrastruttura completamente gestita.
Prestazioni elevate con i classici carichi di lavoro SQL e BI.
Condivisione dei dati semplice e sicura oltre i confini aziendali.
Costi prevedibili grazie alla sospensione automatica dei warehouse inutilizzati.
Ampio supporto per AWS, Azure e GCP.
Le sfide di Snowflake
Supporto nativo limitato per i dati non strutturati.
Le funzionalità di machine learning sono meno avanzate rispetto a quelle di Databricks.
I costi possono aumentare rapidamente in caso di utilizzo incontrollato di più data warehouse.
Forte dipendenza dal proprio ecosistema per alcune funzioni di condivisione dei dati.
I vantaggi di Databricks in sintesi
Piattaforma integrata per data engineering, analisi dei dati e machine learning.
Supporto nativo per dati strutturati e non strutturati.
Formati aperti come Delta Lake e Delta Sharing riducono gli effetti di lock-in.
Elevata flessibilità nei linguaggi di programmazione e nella configurazione dei cluster.
Particolarmente adatta a casi d’uso di streaming e in tempo reale.
Le sfide di Databricks
Maggiore impegno nella configurazione e nell'amministrazione dei cluster.
I costi relativi a DBU e all'infrastruttura cloud devono essere calcolati separatamente.
Curva di apprendimento più ripida per i team senza esperienza con Spark o Python.
L’esperienza con SQL per gli utenti che si occupano esclusivamente di BI è in parte meno intuitiva rispetto a Snowflake.
Migliori pratiche per la scelta della piattaforma
Indipendentemente dalla piattaforma che sceglierai, alcune linee guida fondamentali ti aiuteranno a fare una scelta informata:
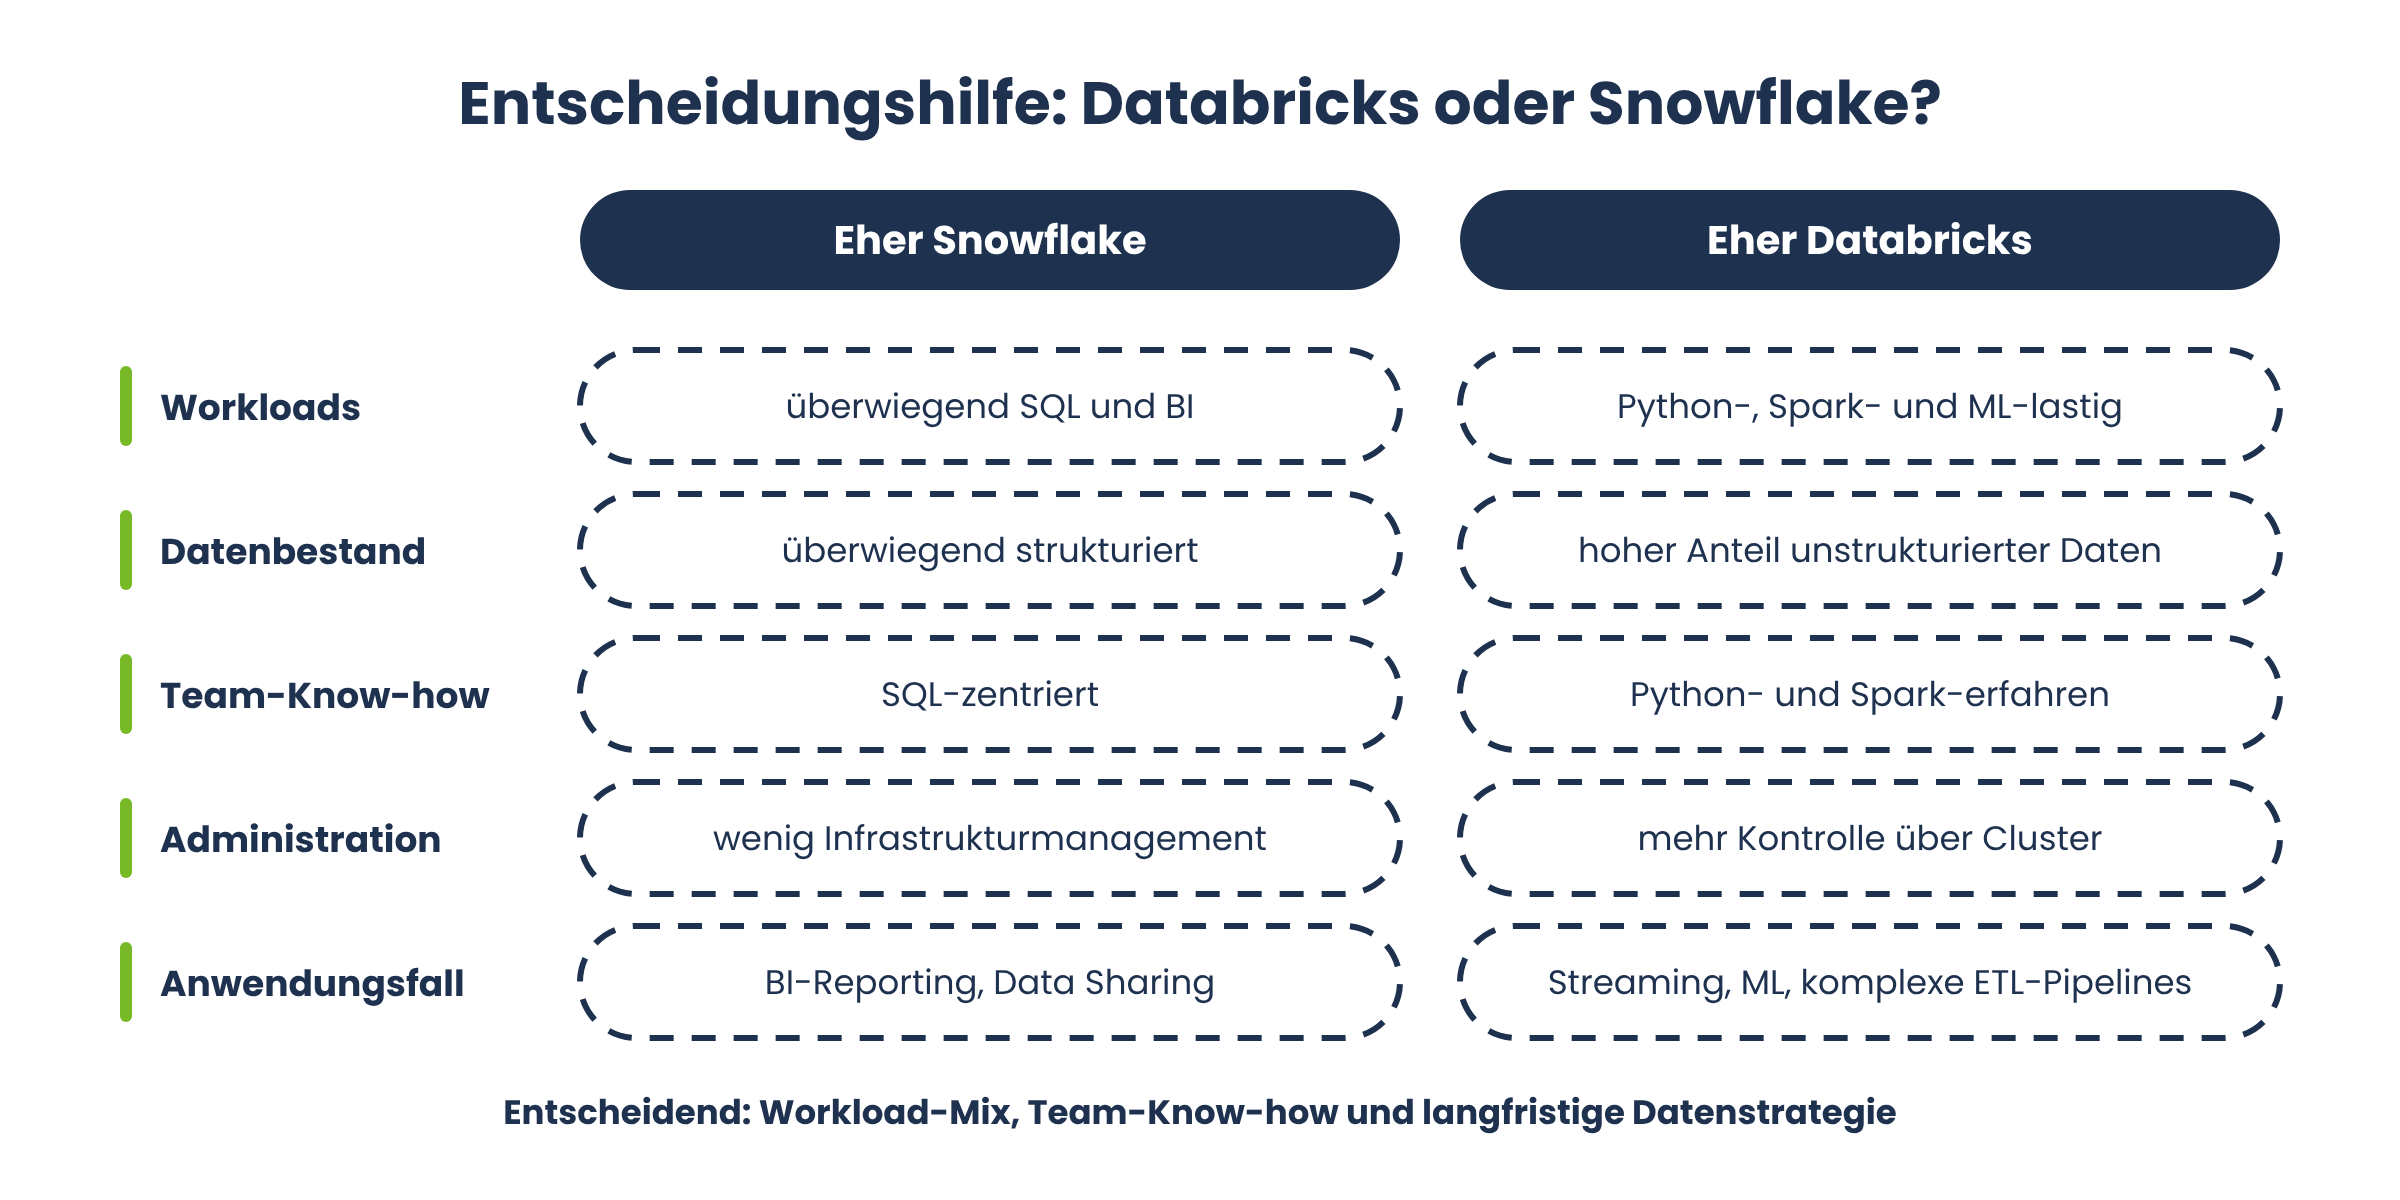
Analizza innanzitutto i tuoi carichi di lavoro effettivi prima di confrontare i listini prezzi.
Crea un foglio di calcolo del TCO che quantifichi singolarmente ogni componente di costo per il tuo mix effettivo di carichi di lavoro.
Prova entrambe le piattaforme con un proof of concept realistico, invece di affidarti esclusivamente ai benchmark forniti dai fornitori.
Tieni conto delle competenze esistenti nel team: i team incentrati su SQL spesso iniziano più rapidamente con Snowflake, mentre quelli con esperienza in Python e Spark traggono vantaggio più rapidamente da Databricks.
Prevedi l’andamento dei costi in caso di raddoppio del volume dei dati, non solo in base alla situazione attuale.
Lista di controllo: come prendere la decisione giusta
[ ] I vostri carichi di lavoro sono prevalentemente basati su SQL o piuttosto su Python e ML?
[ ] Qual è la percentuale di dati non strutturati nel vostro database?
[ ] Quanto è importante per voi la condivisione sicura dei dati con partner esterni?
[ ] Di quali competenze dispone già il vostro team?
[ ] Avete calcolato i costi relativi a uno scenario di crescita realistico?
[ ] Una delle due piattaforme si adatta alla vostra attuale strategia cloud?
Databricks o Snowflake: quale è la soluzione più adatta alla tua azienda?
Databricks e Snowflake sono piattaforme leader nella gestione moderna dei dati, ma seguono filosofie diverse. Snowflake si distingue nelle analisi SQL classiche, nella business intelligence e nella semplicità di gestione. Databricks eccelle nel machine learning, nel data engineering complesso e nell’elaborazione di dati non strutturati. Non esiste una risposta univoca alla domanda «Databricks o Snowflake»: la scelta dipende dal mix dei vostri carichi di lavoro, dalle competenze del vostro team e dalla vostra strategia a lungo termine in materia di dati. Molte aziende, del resto, puntano ormai su entrambe le piattaforme contemporaneamente, anziché optare per un’unica soluzione.
Se non siete sicuri di quale piattaforma dati sia più adatta alle vostre esigenze nel settore assicurativo, pubblico o delle PMI, FIDA vi supporta nell’analisi dei vostri carichi di lavoro e nello sviluppo di una strategia dati adeguata. FIDA conosce bene le esigenze dei settori regolamentati e vi aiuta a calcolare il costo totale di proprietà (TCO) in modo realistico, anziché basarsi su promesse di marketing.
Domande frequenti su Databricks e Snowflake (FAQ)
Non è possibile dare una risposta generale. Per i carichi di lavoro puramente SQL e BI, Snowflake è spesso più conveniente, mentre per quelli incentrati sul machine learning e sul data engineering, Databricks offre spesso prestazioni migliori. Ciò che conta è la composizione specifica dei carichi di lavoro, non il prezzo di listino.
Sì, grazie a Snowpark ML e Cortex AI, Snowflake offre ormai funzionalità di machine learning proprie. Per casi d’uso di ML di livello da semplice a medio, ciò è spesso sufficiente; in caso di addestramento complesso e distribuito, Databricks risulta generalmente più performante grazie all’ambiente Spark nativo.
Un data warehouse memorizza dati pre-strutturati per la reportistica e le analisi. Un data lakehouse, l'approccio proposto da Databricks, combina la flessibilità di un data lake per dati strutturati e non strutturati con la governance e l'affidabilità di un classico data warehouse.
Una DBU misura la capacità di calcolo consumata da un cluster o da un job ogni ora. Il tasso DBU varia a seconda del tipo di cluster, del carico di lavoro e del piano tariffario scelto e viene addebitato in aggiunta ai costi dell'infrastruttura cloud del rispettivo fornitore di servizi cloud.
Sì, sia Snowflake che Databricks sono disponibili su tutti e tre i principali hyperscaler e offrono supporto multi-cloud per l'integrazione di fonti di dati distribuite.
Per pipeline ETL ed ELT estese e complesse, Databricks offre solitamente maggiore flessibilità e prestazioni migliori grazie al supporto nativo di Spark. Snowflake è particolarmente adatto per trasformazioni più semplici in ambito SQL, ma raggiunge più rapidamente i propri limiti in presenza di pipeline molto complesse.
Per le organizzazioni più grandi, con team e esigenze diverse, sì: Databricks per il data engineering e il machine learning, Snowflake per la BI e la condivisione dei dati. Per le aziende più piccole, invece, il funzionamento in parallelo aumenta i costi e la complessità e va valutato con attenzione.
Una migrazione richiede di norma un'analisi accurata delle pipeline esistenti, dei modelli di dati e dei diritti di accesso. I formati aperti come Apache Iceberg facilitano la transizione, poiché consentono di interrogare i dati tra le due piattaforme senza dover procedere a una completa riorganizzazione. Una migrazione graduale con funzionamento in parallelo riduce il rischio rispetto a un passaggio radicale.
Per le PMI con risorse IT limitate, Snowflake rappresenta spesso la soluzione più semplice per iniziare, grazie al minore carico amministrativo. Tuttavia, non appena entrano in gioco progetti di machine learning o l’elaborazione di grandi quantità di dati non strutturati, vale la pena dare un’occhiata più da vicino a Databricks, soprattutto se il team dispone delle competenze necessarie.


