
Databricks vs. Snowflake: Welche Datenplattform passt zu deinem Unternehmen?
Ein mittelständischer Maschinenbauer plant ein neues Reporting für seine Produktionsdaten. Die IT-Leitung holt zwei Angebote ein: eines für Snowflake, eines für Databricks. Beide Anbieter versprechen niedrigere Kosten, bessere Performance und mehr Flexibilität. Am Ende der Gespräche ist die Verwirrung größer als vorher. Genau in dieser Situation stecken aktuell viele Unternehmen, die ihre Dateninfrastruktur modernisieren wollen.
Databricks und Snowflake zählen zu den führenden Plattformen im modernen Datenmanagement. Beide verarbeiten riesige Datenmengen, beide werben mit KI-Funktionen, und beide behaupten, für nahezu jeden Anwendungsfall geeignet zu sein. Doch was bedeutet das konkret für deine Entscheidung? Dieser Artikel vergleicht Databricks und Snowflake entlang der Kriterien, die in der Praxis tatsächlich zählen: Architektur, Preismodell, Total Cost of Ownership, Performance und Anwendungsfälle.
Databricks vs. Snowflake: Warum ist diese Entscheidung so wichtig?
Die Wahl der Datenplattform ist keine reine IT-Entscheidung mehr. Sie bestimmt, wie schnell dein Unternehmen auf Marktveränderungen reagieren kann, wie gut Fachabteilungen mit Daten arbeiten können und wie hoch die laufenden Kosten für Data Engineering, Analytics und KI-Projekte ausfallen. Eine Fehlentscheidung lässt sich zwar später korrigieren, eine Migration zwischen Plattformen ist aber aufwendig und teuer.
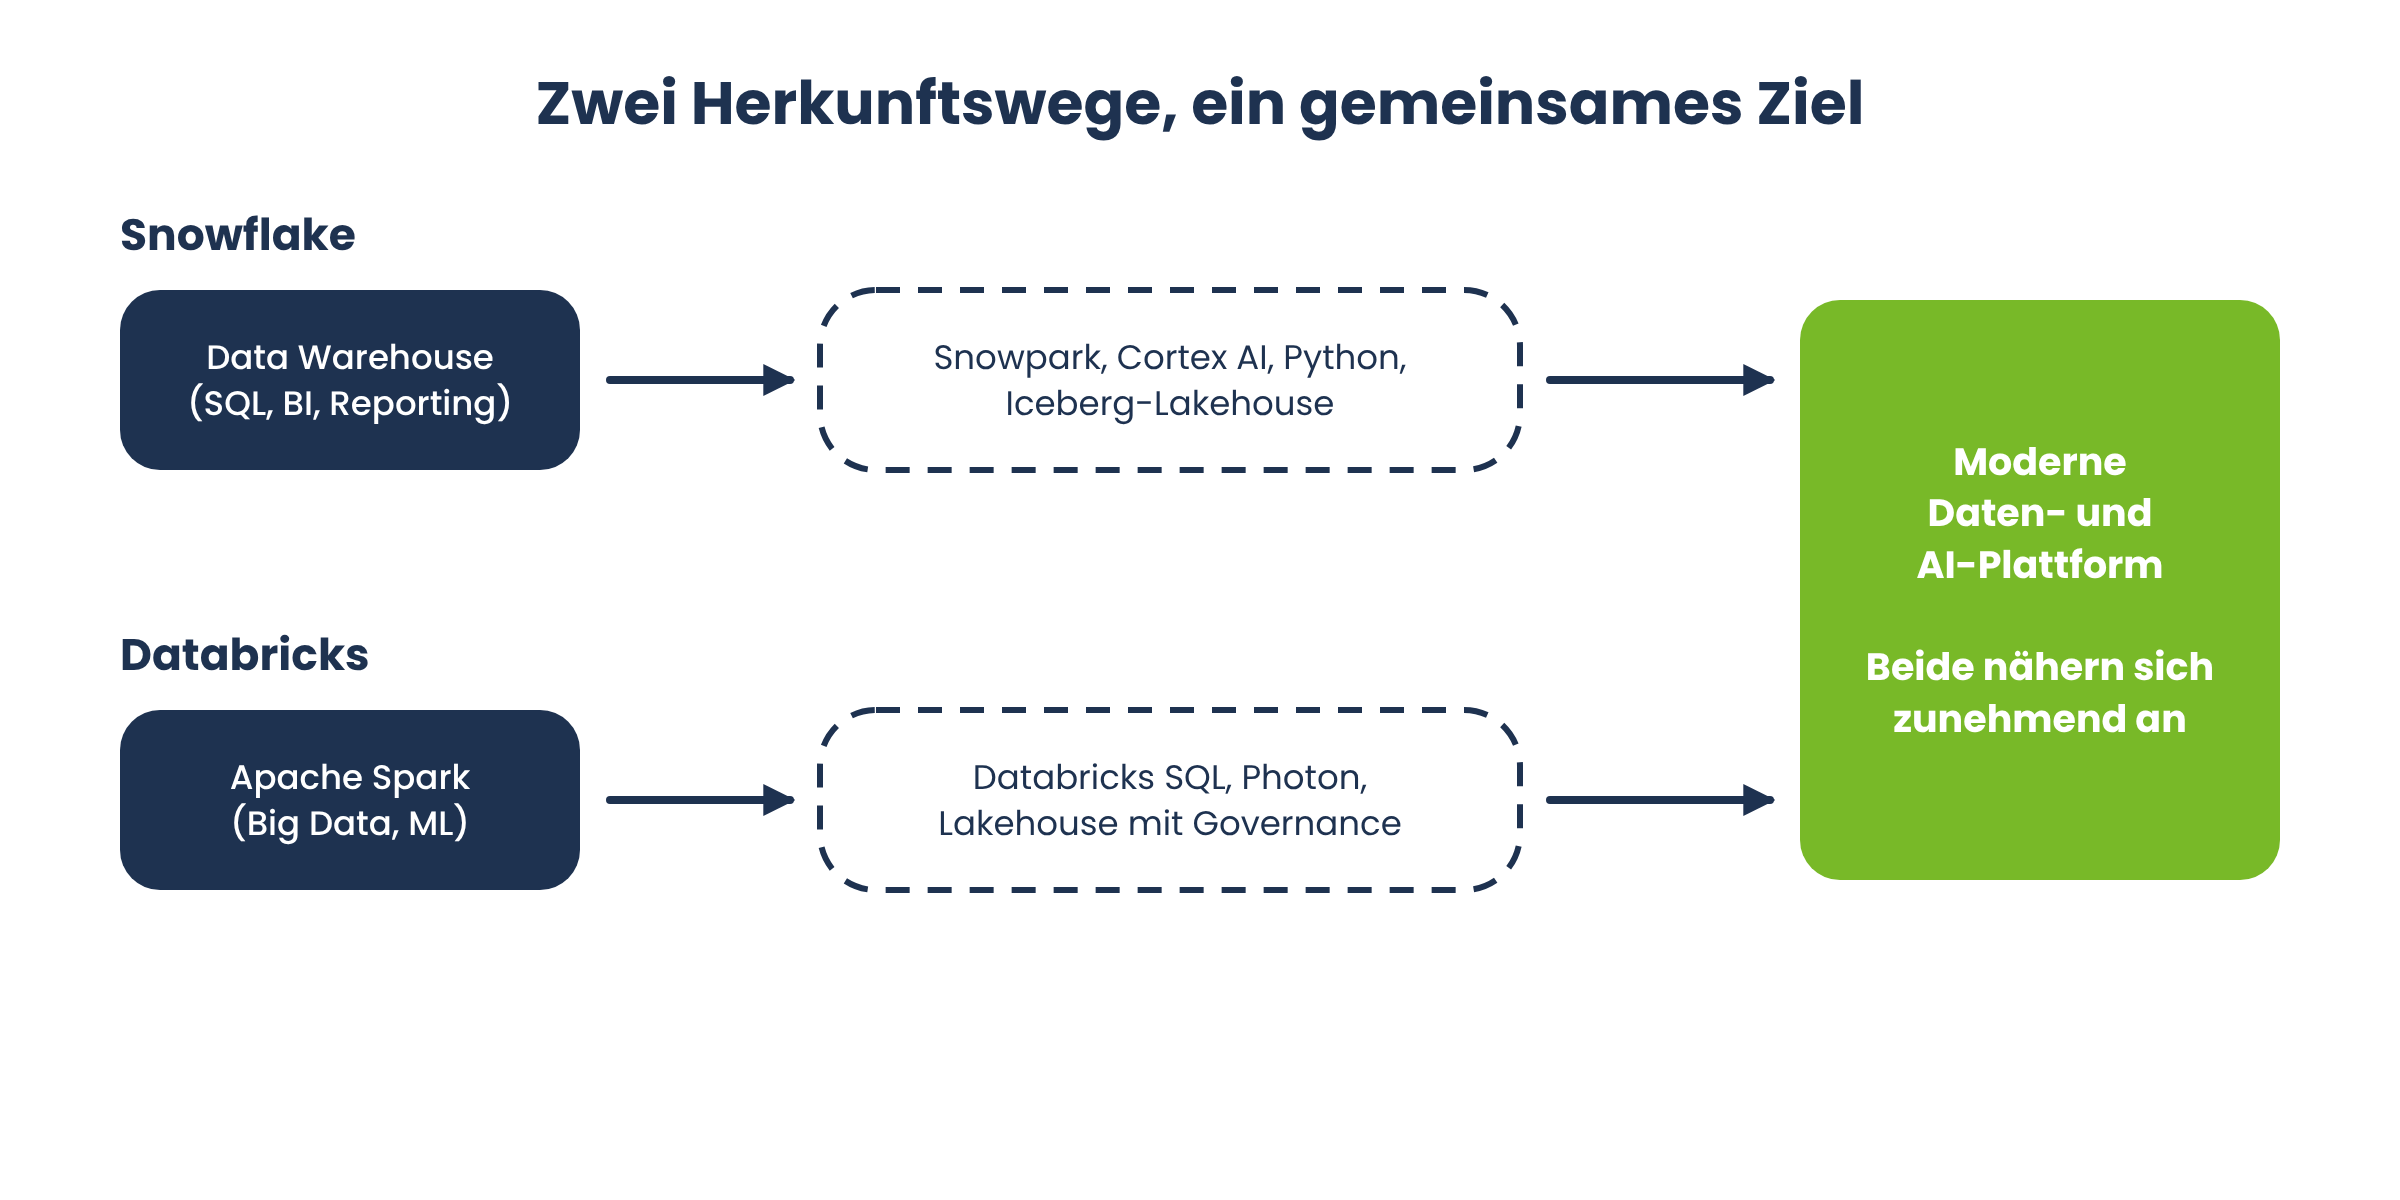
Beide Plattformen haben sich in den vergangenen Jahren stark angenähert. Snowflake hat mit Snowpark, Cortex AI und Unterstützung für Python-Workloads klassische Domänen von Databricks erschlossen. Databricks wiederum hat mit Databricks SQL und Photon eine Antwort auf klassische SQL-Analysen gebaut, die traditionell die Stärke von Snowflake war. Für Unternehmen bedeutet das: Ein oberflächlicher Blick auf Marketingmaterial reicht nicht mehr aus.
Was sind Databricks und Snowflake überhaupt?
Bevor du Databricks und Snowflake vergleichst, lohnt sich ein Blick auf die Grundlagen. Beide Begriffe werden im Unternehmensalltag oft synonym für "moderne Cloud-Datenplattform" verwendet, obwohl sie technisch unterschiedliche Ansätze verfolgen.
Was ist Snowflake?
Snowflake ist eine cloudbasierte Datenplattform, die ursprünglich als Data Warehouse entwickelt wurde. Durch die technische Trennung von Speicher (Storage) und Rechenleistung (Compute) lassen sich beide Ressourcen unabhängig voneinander skalieren. Während Snowflake zunächst vor allem für SQL-basierte Analysen, BI und Reporting eingesetzt wurde, unterstützt die Plattform inzwischen auch semi- und unstrukturierte Daten sowie Lakehouse-Architekturen, etwa auf Basis von Apache Iceberg. Zudem bietet Snowflake Funktionen für AI- und Machine-Learning-Anwendungen und entwickelt sich damit zunehmend von einem klassischen Data Warehouse zu einer umfassenden Daten- und AI-Plattform.
Was ist Databricks?
Databricks entstand aus dem Open-Source-Projekt Apache Spark und verfolgt den sogenannten Lakehouse-Ansatz. Ein Data Lakehouse kombiniert die Flexibilität eines Data Lake, in dem auch unstrukturierte Daten wie Bilder, Logfiles oder Sensordaten abgelegt werden können, mit der Struktur und Governance eines klassischen Data Warehouse. Databricks ist stark auf Big Data, Streaming und Machine Learning ausgelegt und bietet native Unterstützung für Python, Scala, R und SQL.
Databricks und Snowflake im Überblick: Die wichtigsten Unterschiede
Auf den ersten Blick wirken beide Plattformen austauschbar: cloudbasiert, elastisch skalierbar, mit SQL-Zugriff und KI-Funktionen. Bei genauerem Hinsehen zeigen sich jedoch deutliche Unterschiede:
Ursprung: Snowflake kommt aus der Data-Warehouse-Welt, Databricks aus der Big-Data- und Machine-Learning-Welt.
Datentypen: Snowflake und Databricks verarbeiten strukturierte und unstrukturierte Daten gleichermaßen.
Preislogik: Snowflake rechnet in Credits, Databricks in Databricks Units (DBUs).
Zielgruppe: Snowflake spricht vor allem Business-Analystinnen und -Analysten mit SQL-Kenntnissen an, Databricks richtet sich stärker an Data Engineers und Data Scientists.
Governance: Snowflake bietet mit Horizon Catalog eine native Governance-Lösung, genauso wie Databricks mit dem Unity Catalog.
Beide Plattformen entwickeln sich jedoch kontinuierlich weiter und übernehmen zunehmend Funktionen der jeweils anderen Seite.
Architektur im Vergleich: Data Warehouse vs. Data Lakehouse
Die Architektur einer Plattform bestimmt, wofür sie sich in der Praxis eignet. Genau hier setzt der wichtigste Unterschied zwischen Databricks und Snowflake an.
Wie funktioniert die Snowflake-Architektur?
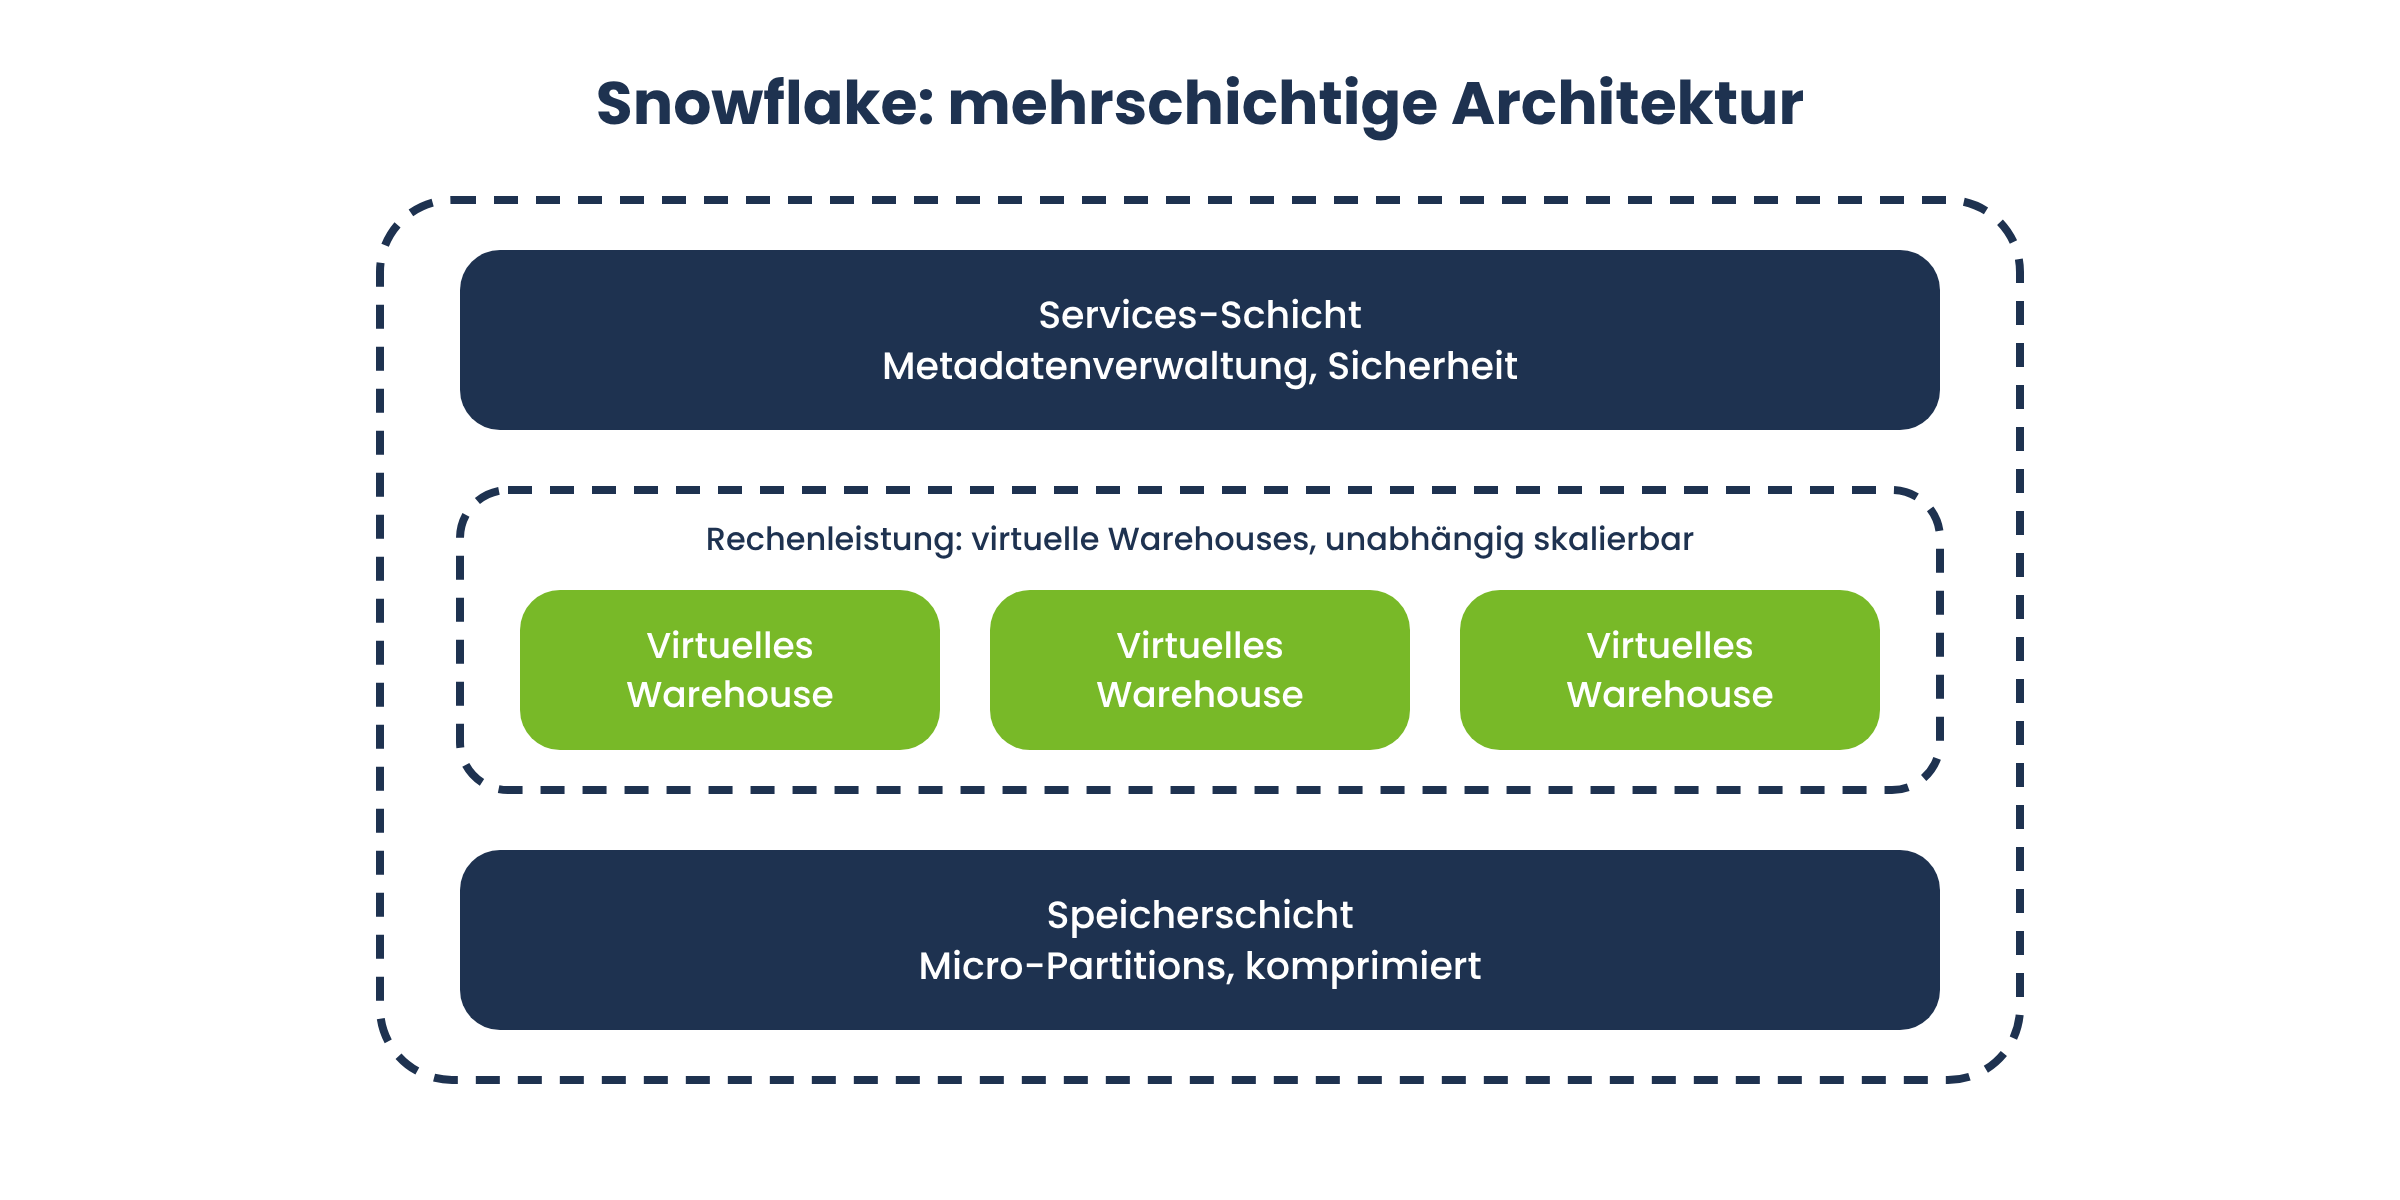
Snowflake nutzt eine mehrschichtige Architektur mit getrennten Ebenen für Speicherung, Rechenleistung und Services wie Metadatenverwaltung oder Sicherheit. Die Daten werden komprimiert und in sogenannten Micro-Partitions abgelegt, kleinen, automatisch verwalteten Speichereinheiten, die Snowflake für eine effiziente Abfrage optimiert. Für Rechenoperationen nutzt Snowflake virtuelle Warehouses, isolierte Rechencluster, die unabhängig voneinander skaliert werden können.
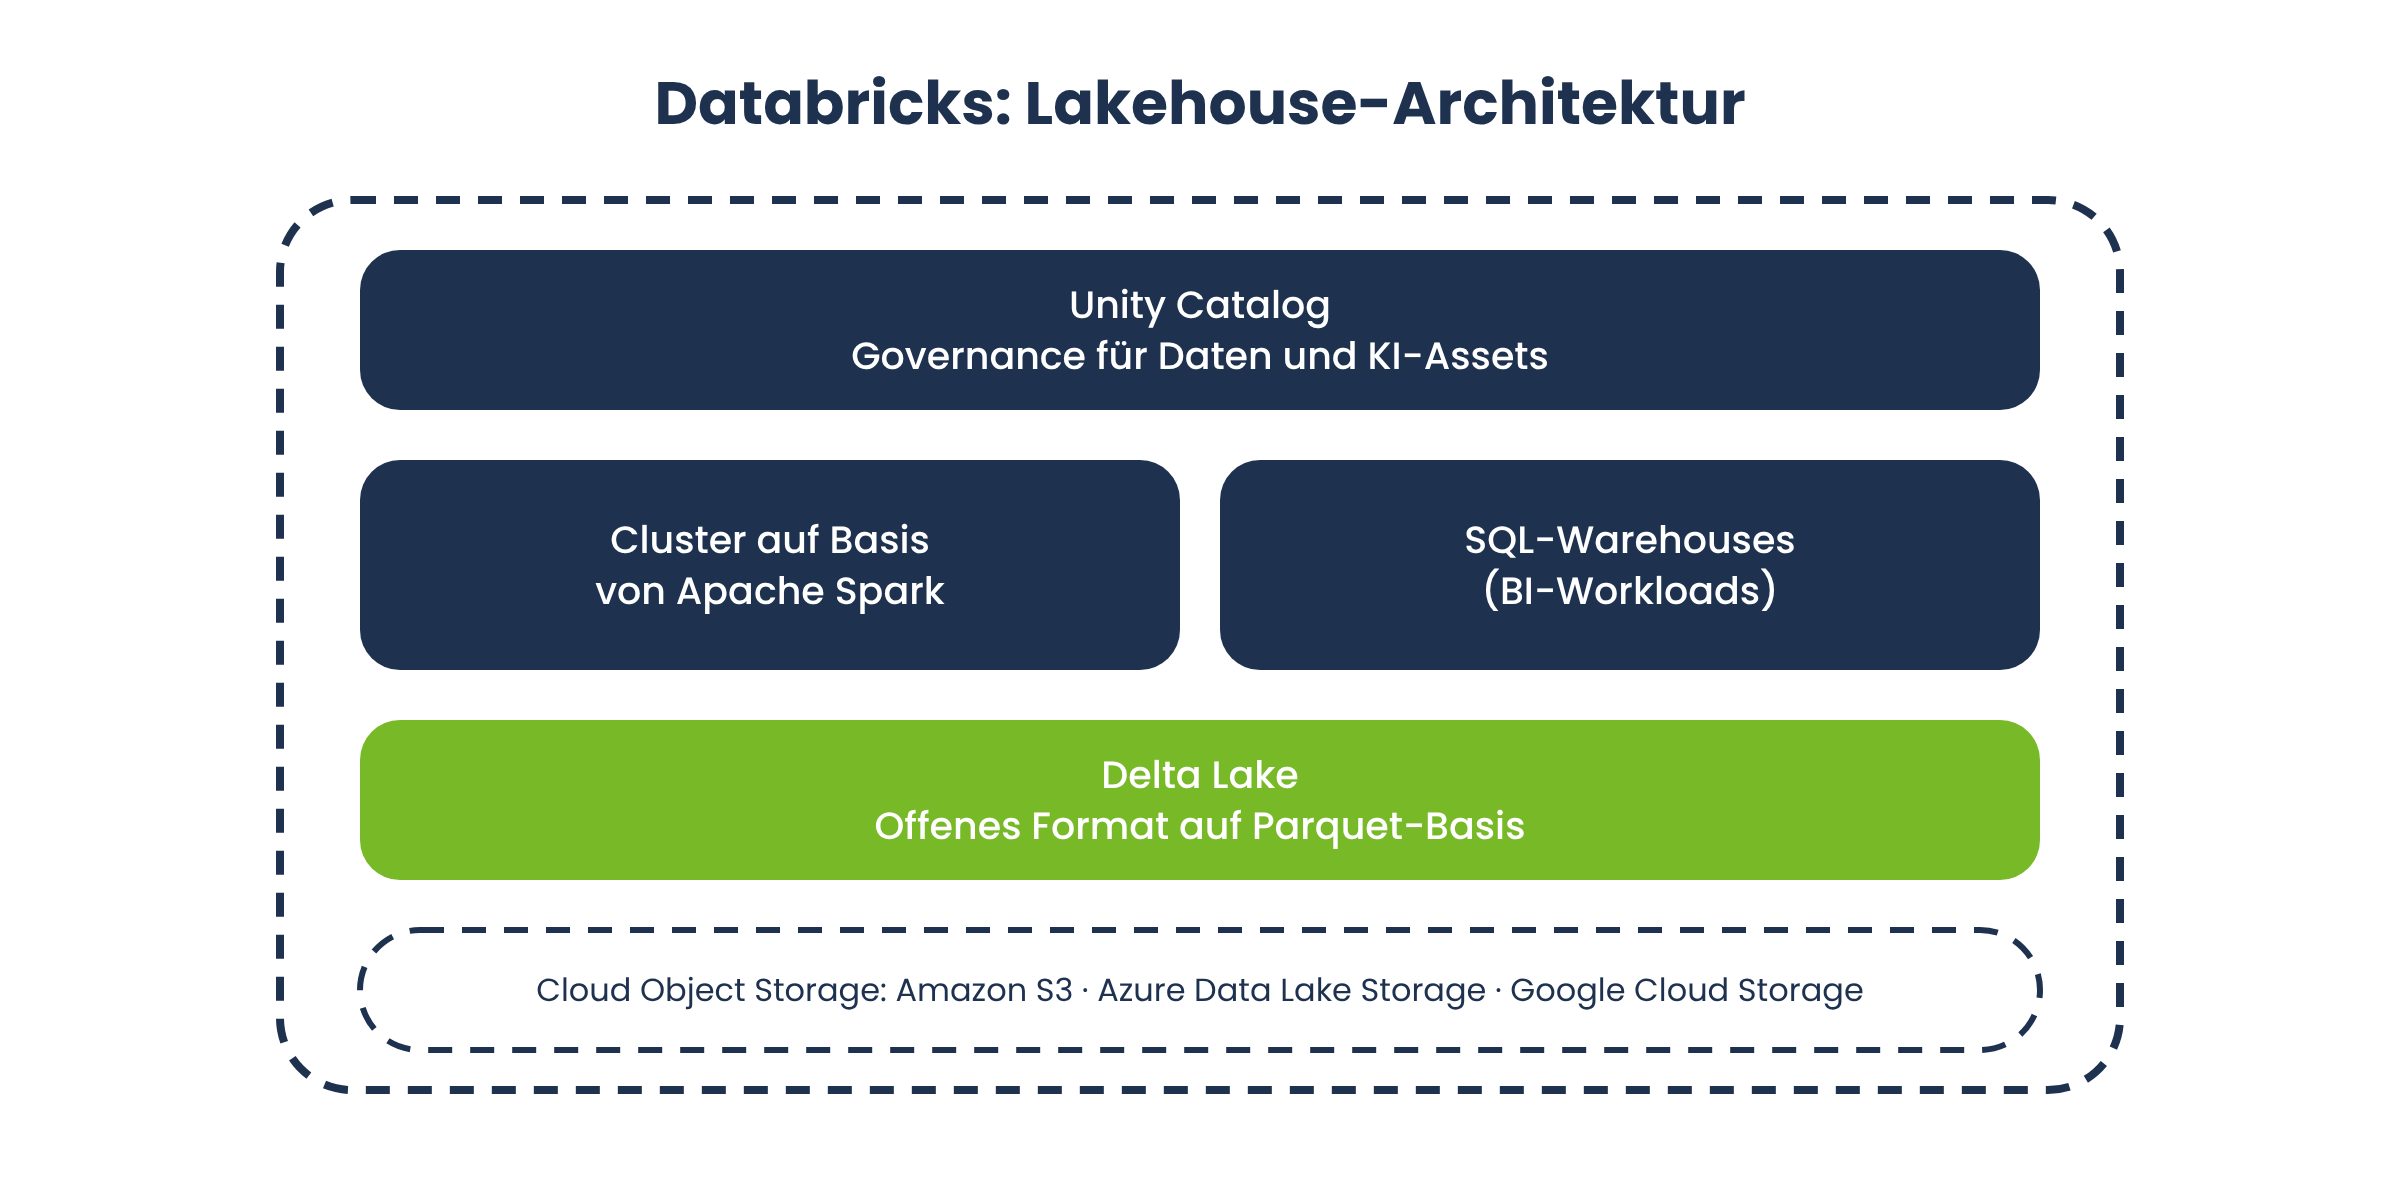
Wie funktioniert die Databricks-Lakehouse-Architektur?
Databricks speichert Daten als Delta-Lake-Tabellen (basierend auf Parquet) direkt in einem Cloud Object Storage wie Amazon S3, Azure Data Lake Storage oder Google Cloud Storage. Rechenoperationen laufen über Cluster, die auf Apache Spark basieren, oder über SQL-Warehouses für BI-Workloads. Weil die Daten in offenen Formaten und im eigenen Cloud-Speicher liegen, bleibt die Kontrolle über die Dateninfrastruktur weitgehend beim Unternehmen selbst.
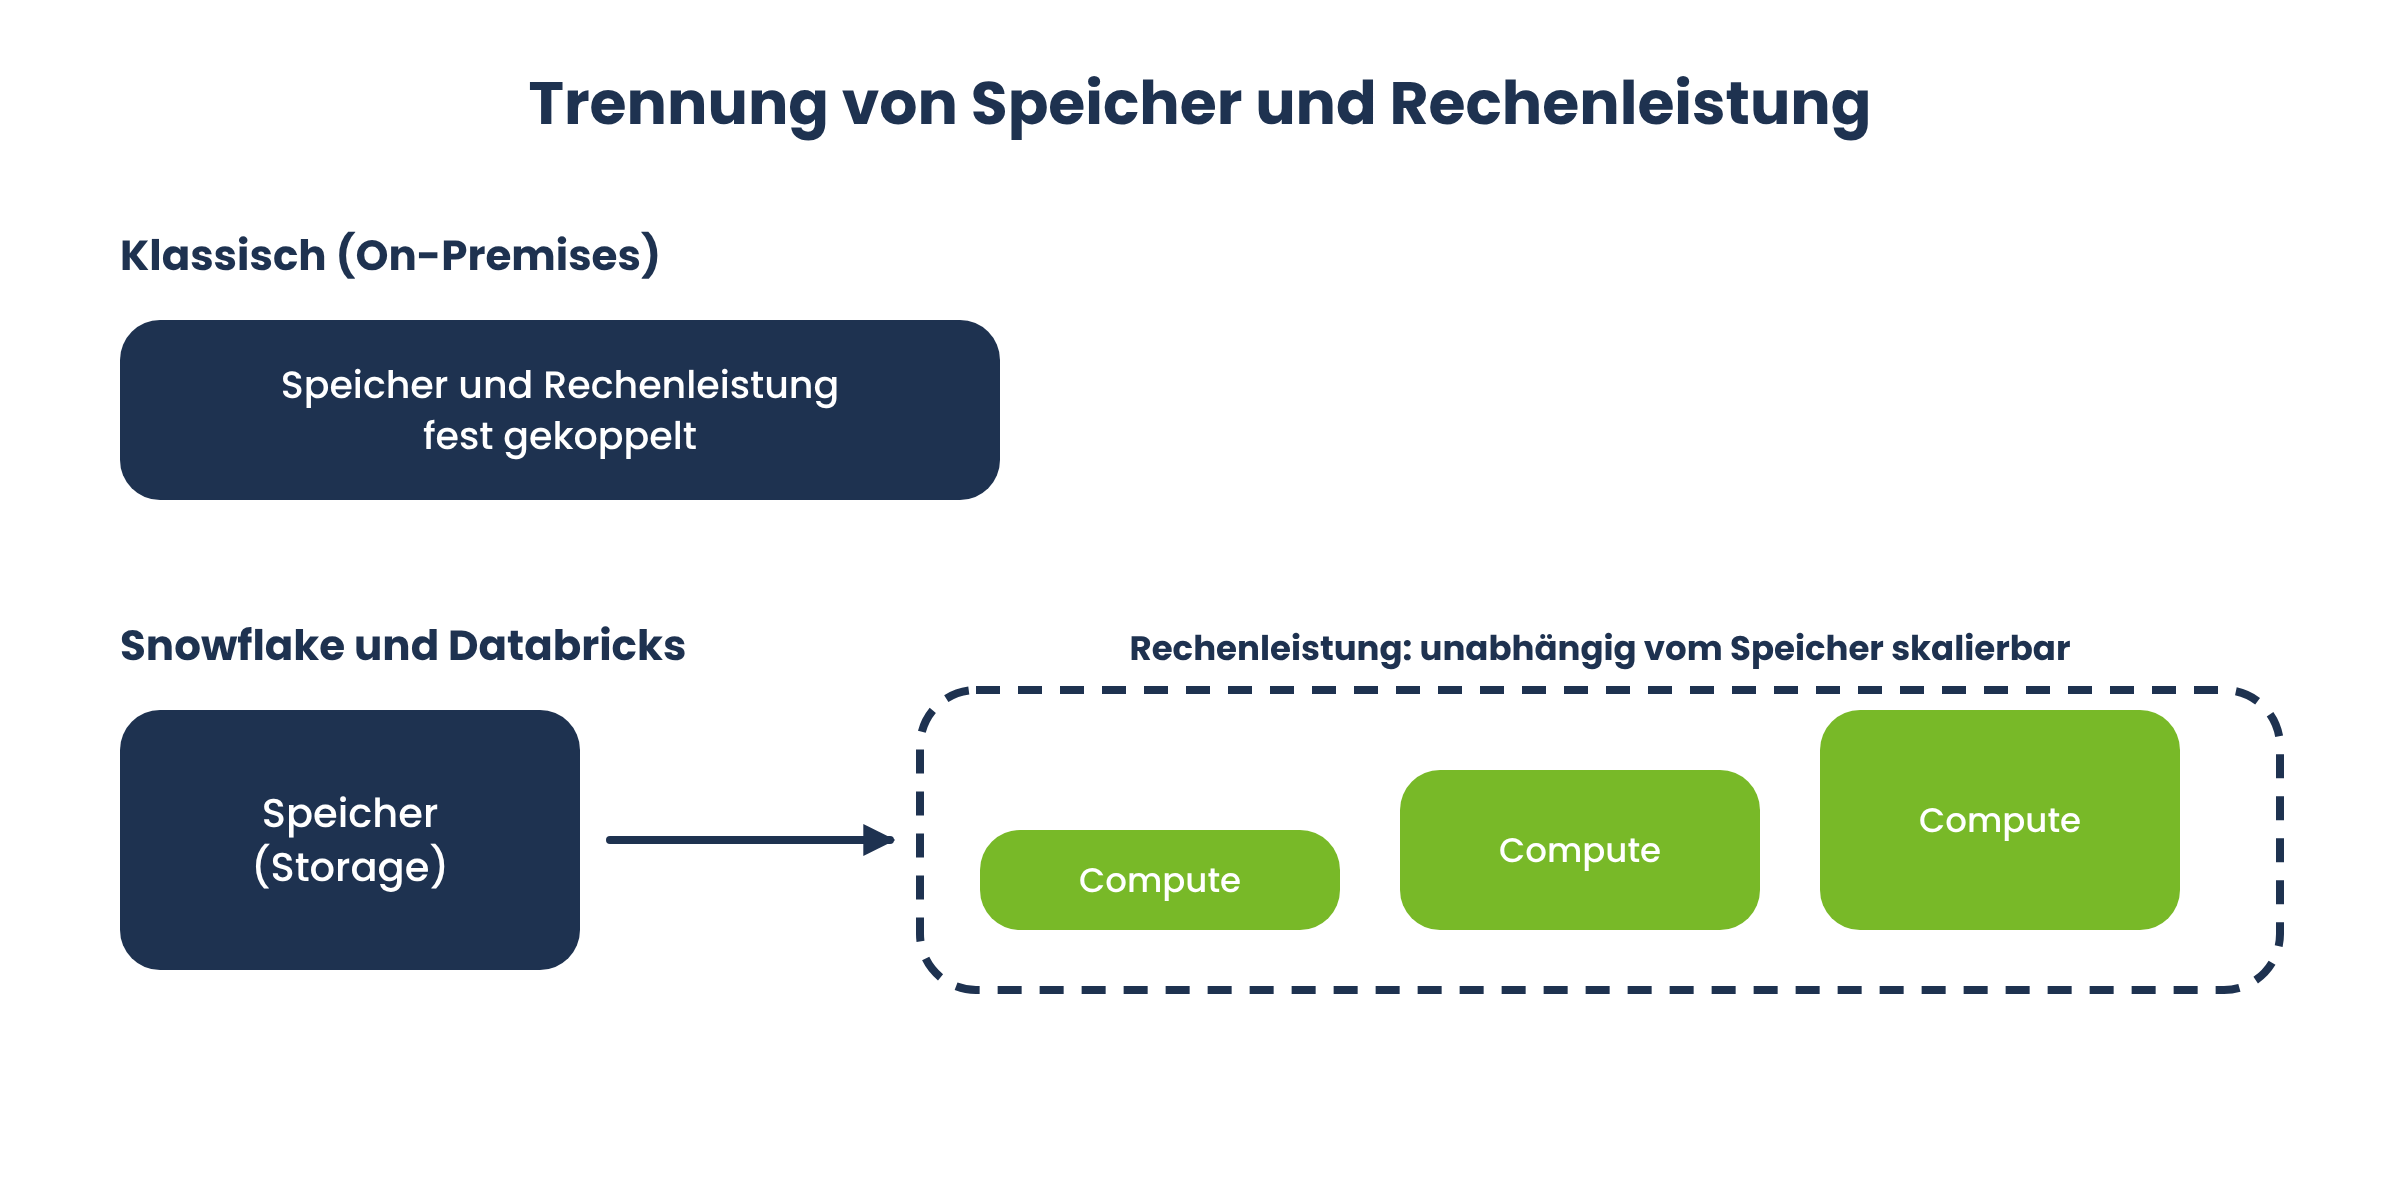
Was bedeutet die Trennung von Storage und Compute?
Beide Plattformen trennen Speicherung und Rechenleistung. Das ist ein zentraler Fortschritt gegenüber klassischen On-Premises-Systemen, bei denen beide Komponenten fest gekoppelt waren.
Preismodelle im Detail: Wie berechnen Snowflake und Databricks ihre Kosten?
Ein Vergleich allein auf Basis der Listenpreise greift zu kurz. Beide Anbieter verwenden nutzungsbasierte Preismodelle, bei denen die tatsächlichen Kosten stark vom individuellen Workload abhängen. Wer beide Preislogiken nicht versteht, trifft schnell eine teure Fehlentscheidung.
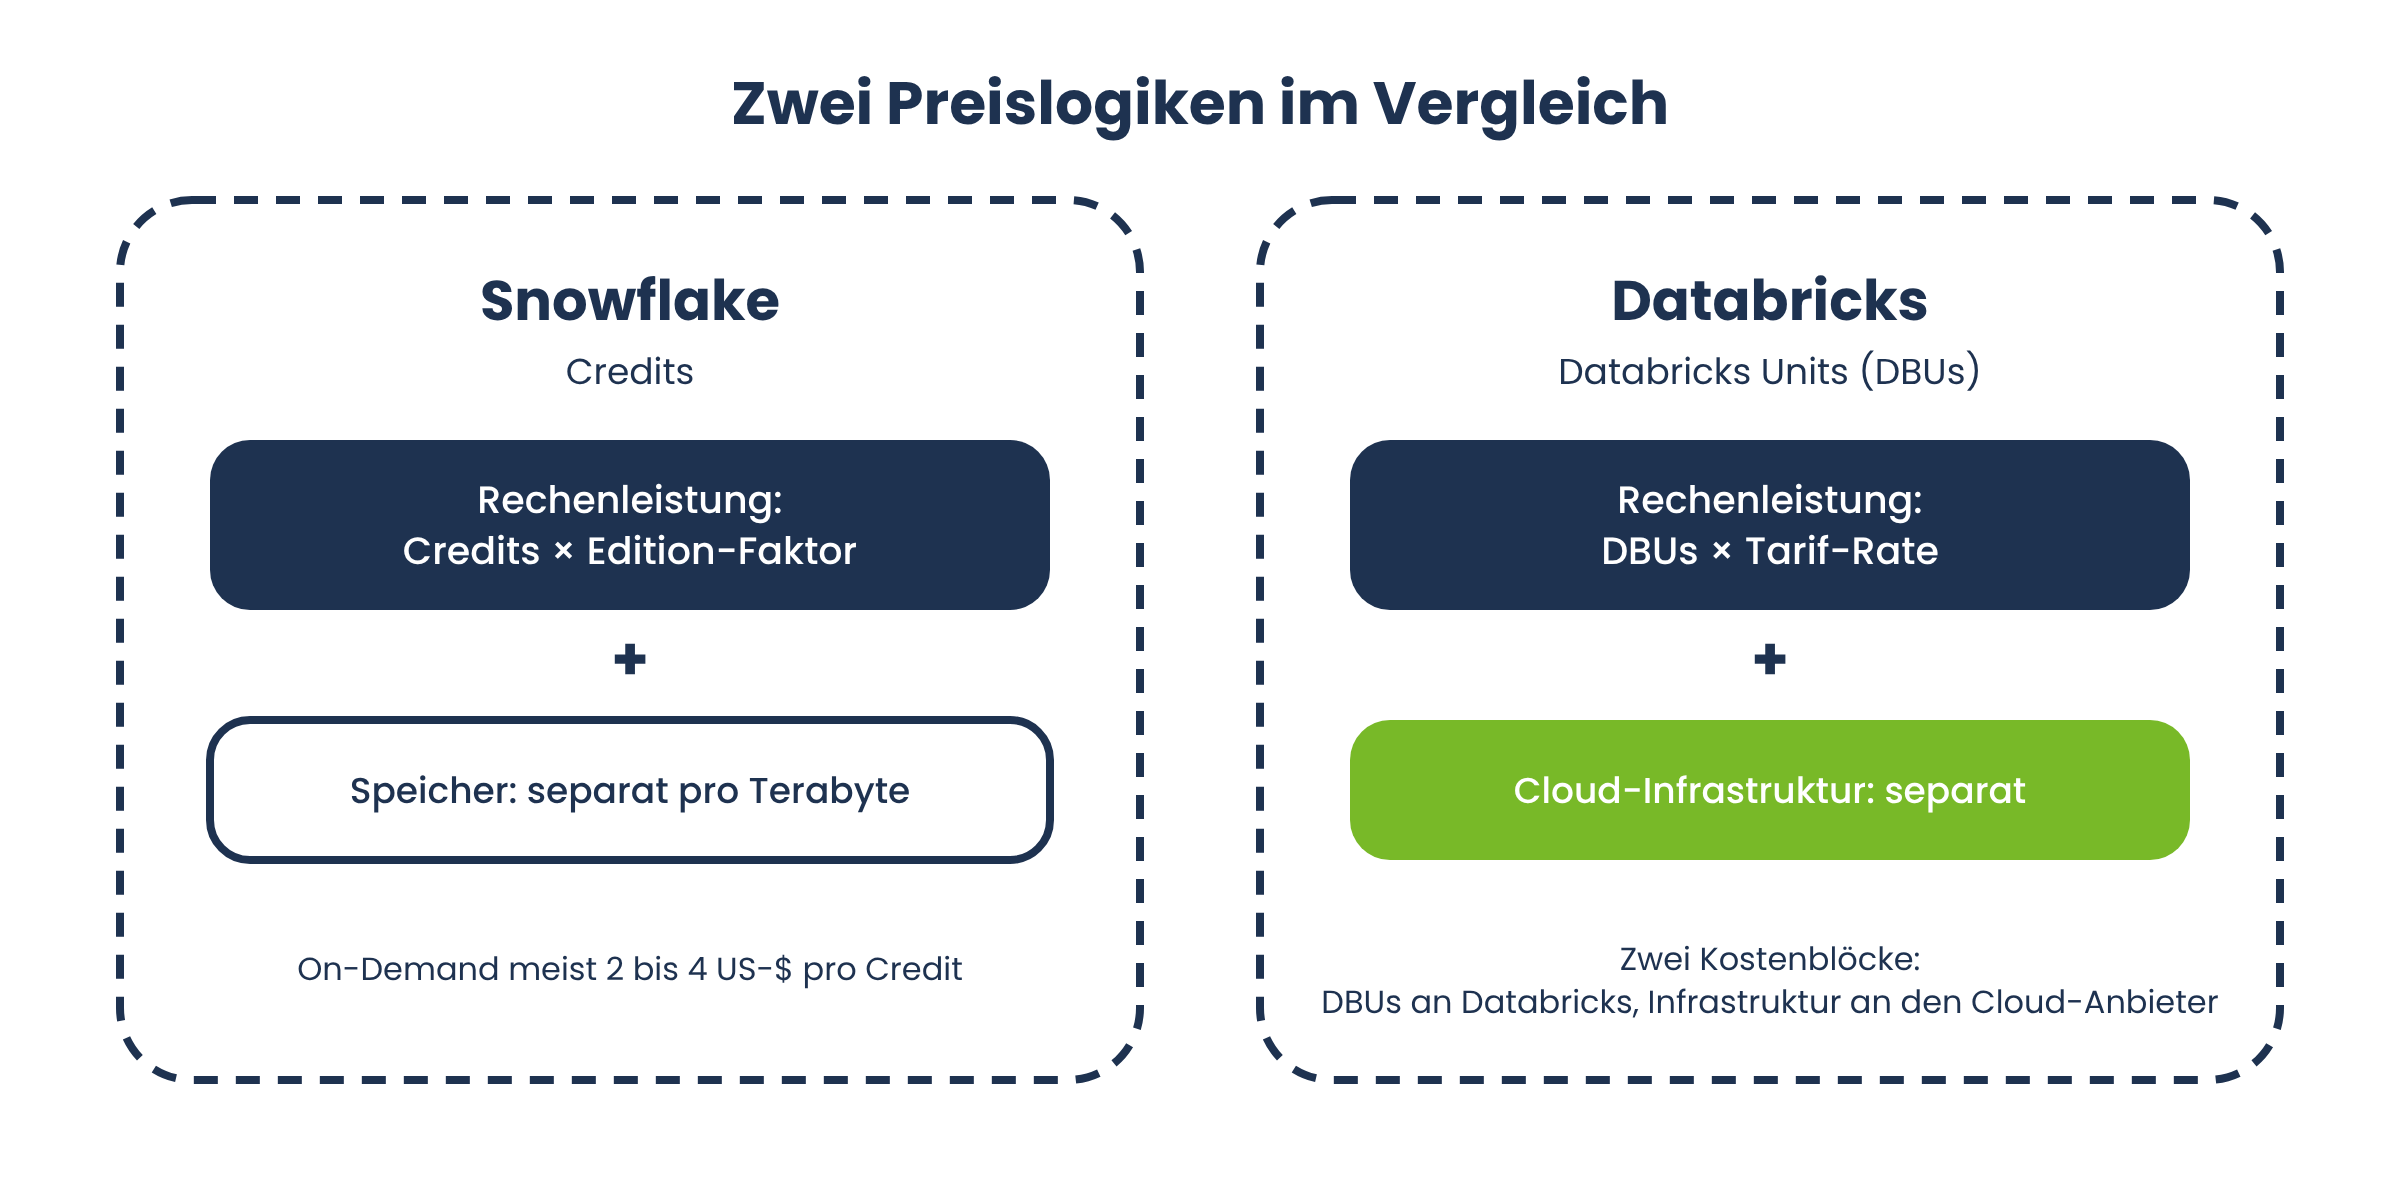
Wie funktioniert das Snowflake-Preismodell mit Credits?
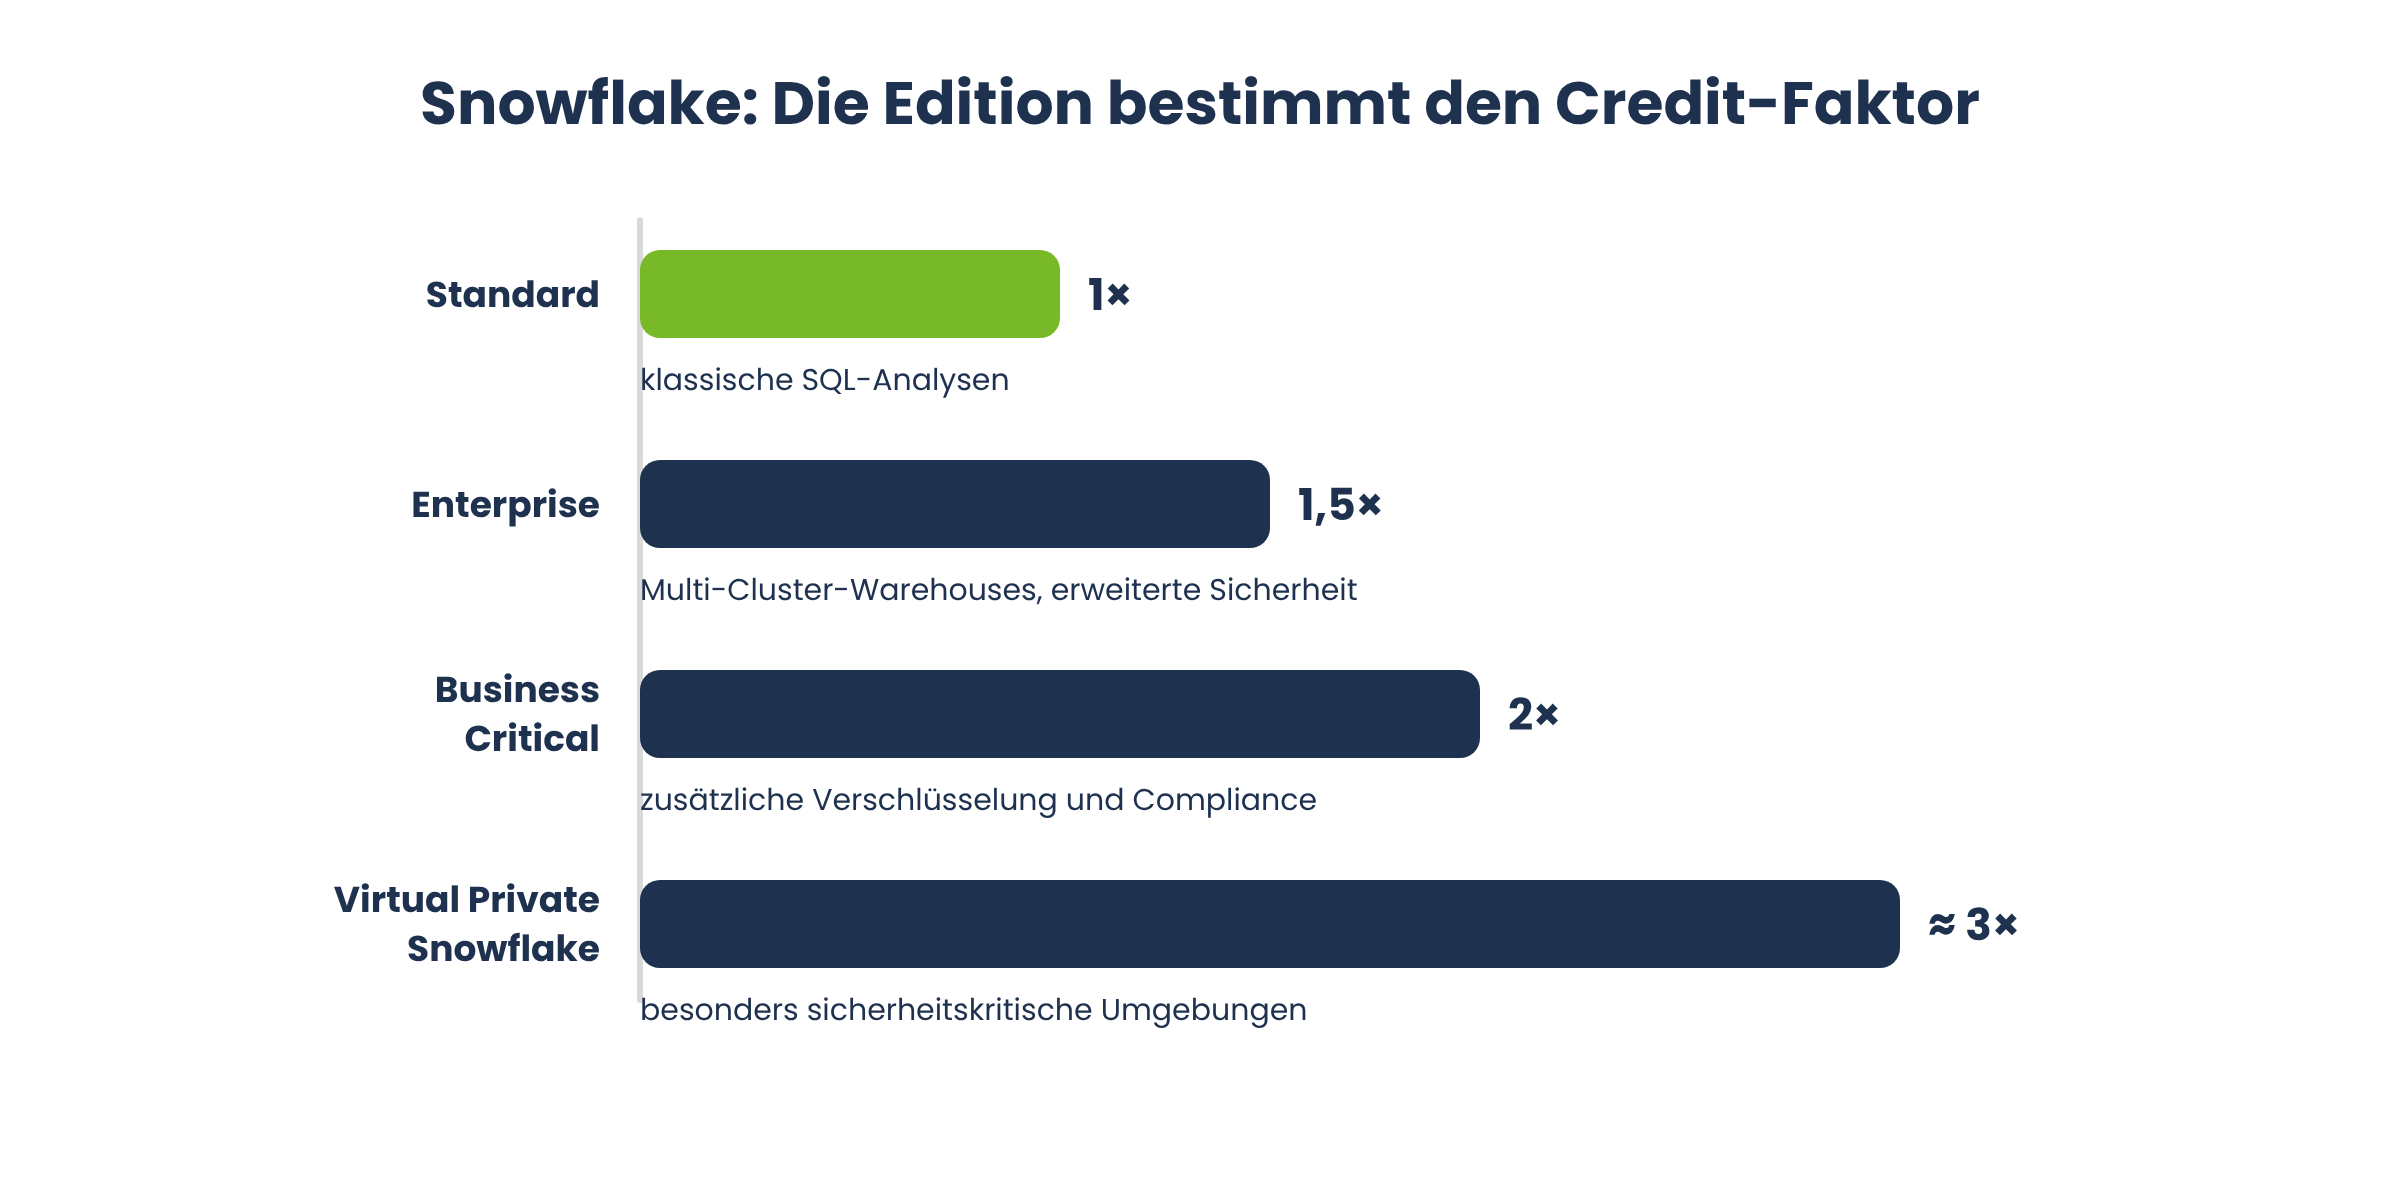
Snowflake verwendet ein kreditbasiertes Preismodell für Rechenressourcen. Ein Snowflake-Kredit entspricht einer Stunde Rechenleistung eines virtuellen Warehouses in der kleinsten Größe. Je nach Edition wird dieser Grundpreis mit einem Faktor multipliziert:
Standard: Basisfaktor 1×, für klassische SQL-Analysen.
Enterprise: Faktor 1,5×, inklusive Multi-Cluster-Warehouses und erweiterten Sicherheitsfunktionen.
Business Critical: Faktor 2×, mit zusätzlicher Verschlüsselung und Compliance-Funktionen.
Virtual Private Snowflake: Faktor rund 3×, für besonders sicherheitskritische Umgebungen.
Der Preis pro Credit liegt bei On-Demand-Nutzung je nach Cloud-Anbieter und Region meist zwischen 2 und 4 Euro. Bei vorab gebuchter Kapazität sinkt der effektive Preis deutlich (Software Pricing Guide).
Was sind Databricks Units (DBUs) und wie werden sie berechnet?
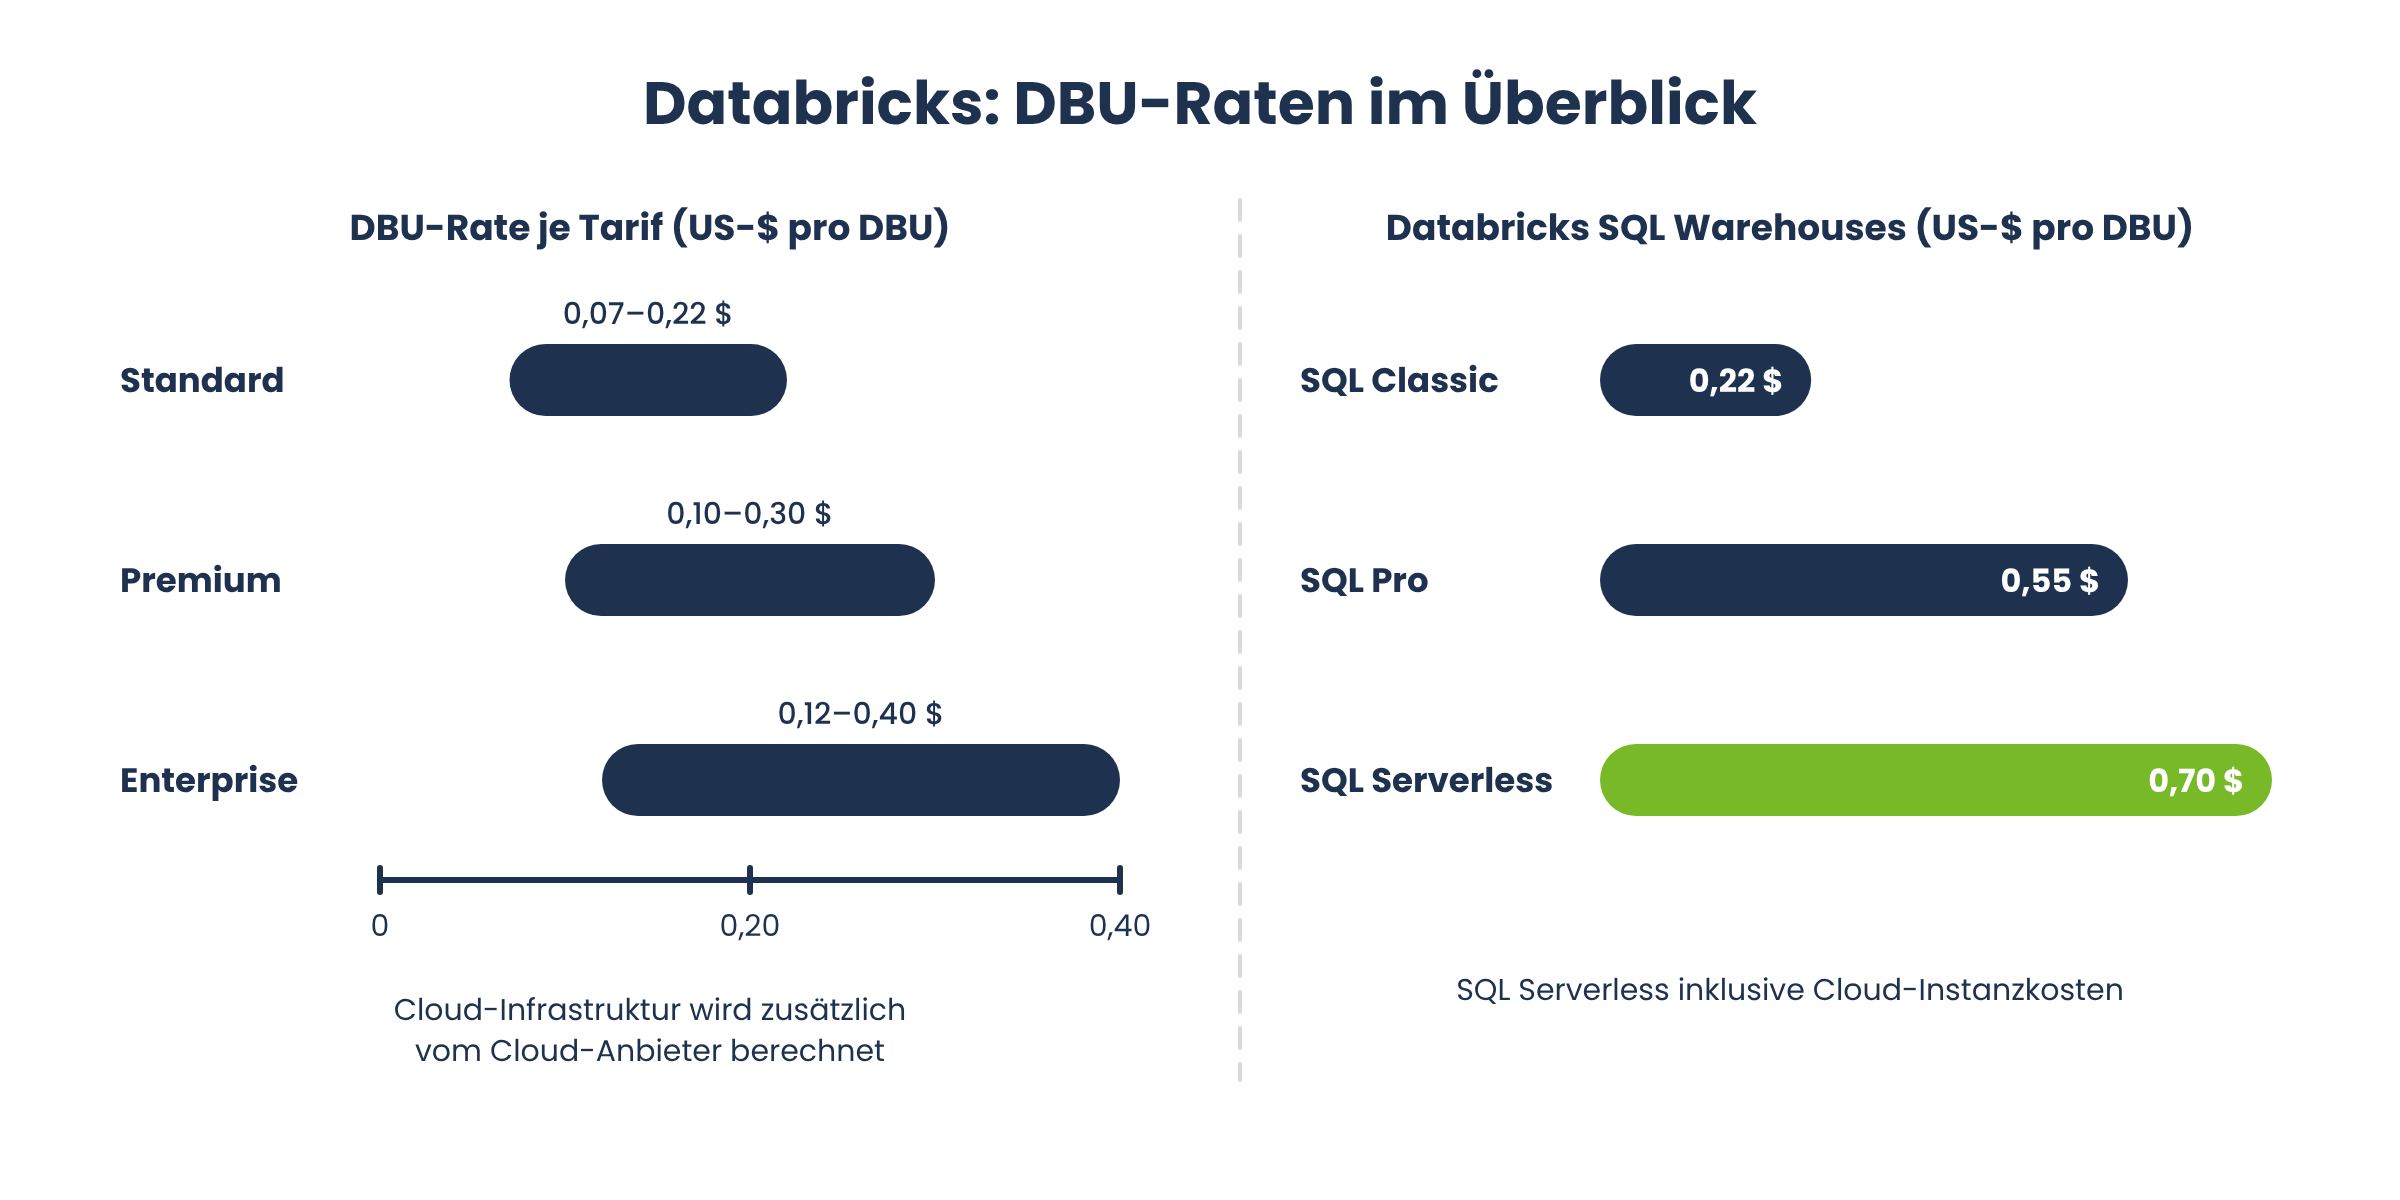
Databricks verwendet Databricks Units (DBUs) zur Preisgestaltung. Eine DBU misst die verbrauchte Rechenkapazität pro Stunde. Der Verbrauch variiert je nach Cluster-Typ und Arbeitslast. Die Kosten pro DBU unterscheiden sich außerdem je nach Tarif:
Standard: rund 0,06 bis 0,20 € pro DBU.
Premium: rund 0,09 bis 0,27 € pro DBU, inklusive rollenbasierter Zugriffskontrolle und Audit-Logs.
Enterprise: rund 0,11 bis 0,36 € pro DBU, inklusive Unity Catalog und erweiterter Governance.
Für Databricks SQL Warehouses, die BI-Abfrageschicht der Plattform, gelten eigene DBU-Sätze:
SQL Classic: rund 0,20 € pro DBU.
SQL Pro: rund 0,49 € pro DBU.
SQL Serverless: rund 0,62 € pro DBU, inklusive Cloud-Instanzkosten.
Die angegebenen Europreise basieren auf einem angenommenen Wechselkurs von 1 US-Dollar = 0,89 € und stellen gerundete Näherungswerte dar. Die tatsächlichen Kosten können je nach Cloud-Anbieter, Konfiguration, Arbeitslast und möglichen Rabatten variieren. Mehrwertsteuer und Wechselkursgebühren sind nicht berücksichtigt.
Warum sind Cloud-Infrastrukturkosten bei Databricks getrennt zu betrachten?
Ein häufiges Missverständnis betrifft die Gesamtkosten von Databricks. DBU-Kosten variieren je nach Cluster-Typ und Arbeitslast und werden direkt an Databricks gezahlt. Die zugrunde liegende Cloud-Infrastruktur wird separat vom Cloud-Anbieter abgerechnet. Deine monatliche Databricks-Rechnung besteht also faktisch aus zwei Kostenblöcken, die bei Verhandlungen mit dem Anbieter getrennt betrachtet werden sollten (Software Pricing Guide).
Was kostet Snowflake in der Praxis? Ein Rechenbeispiel
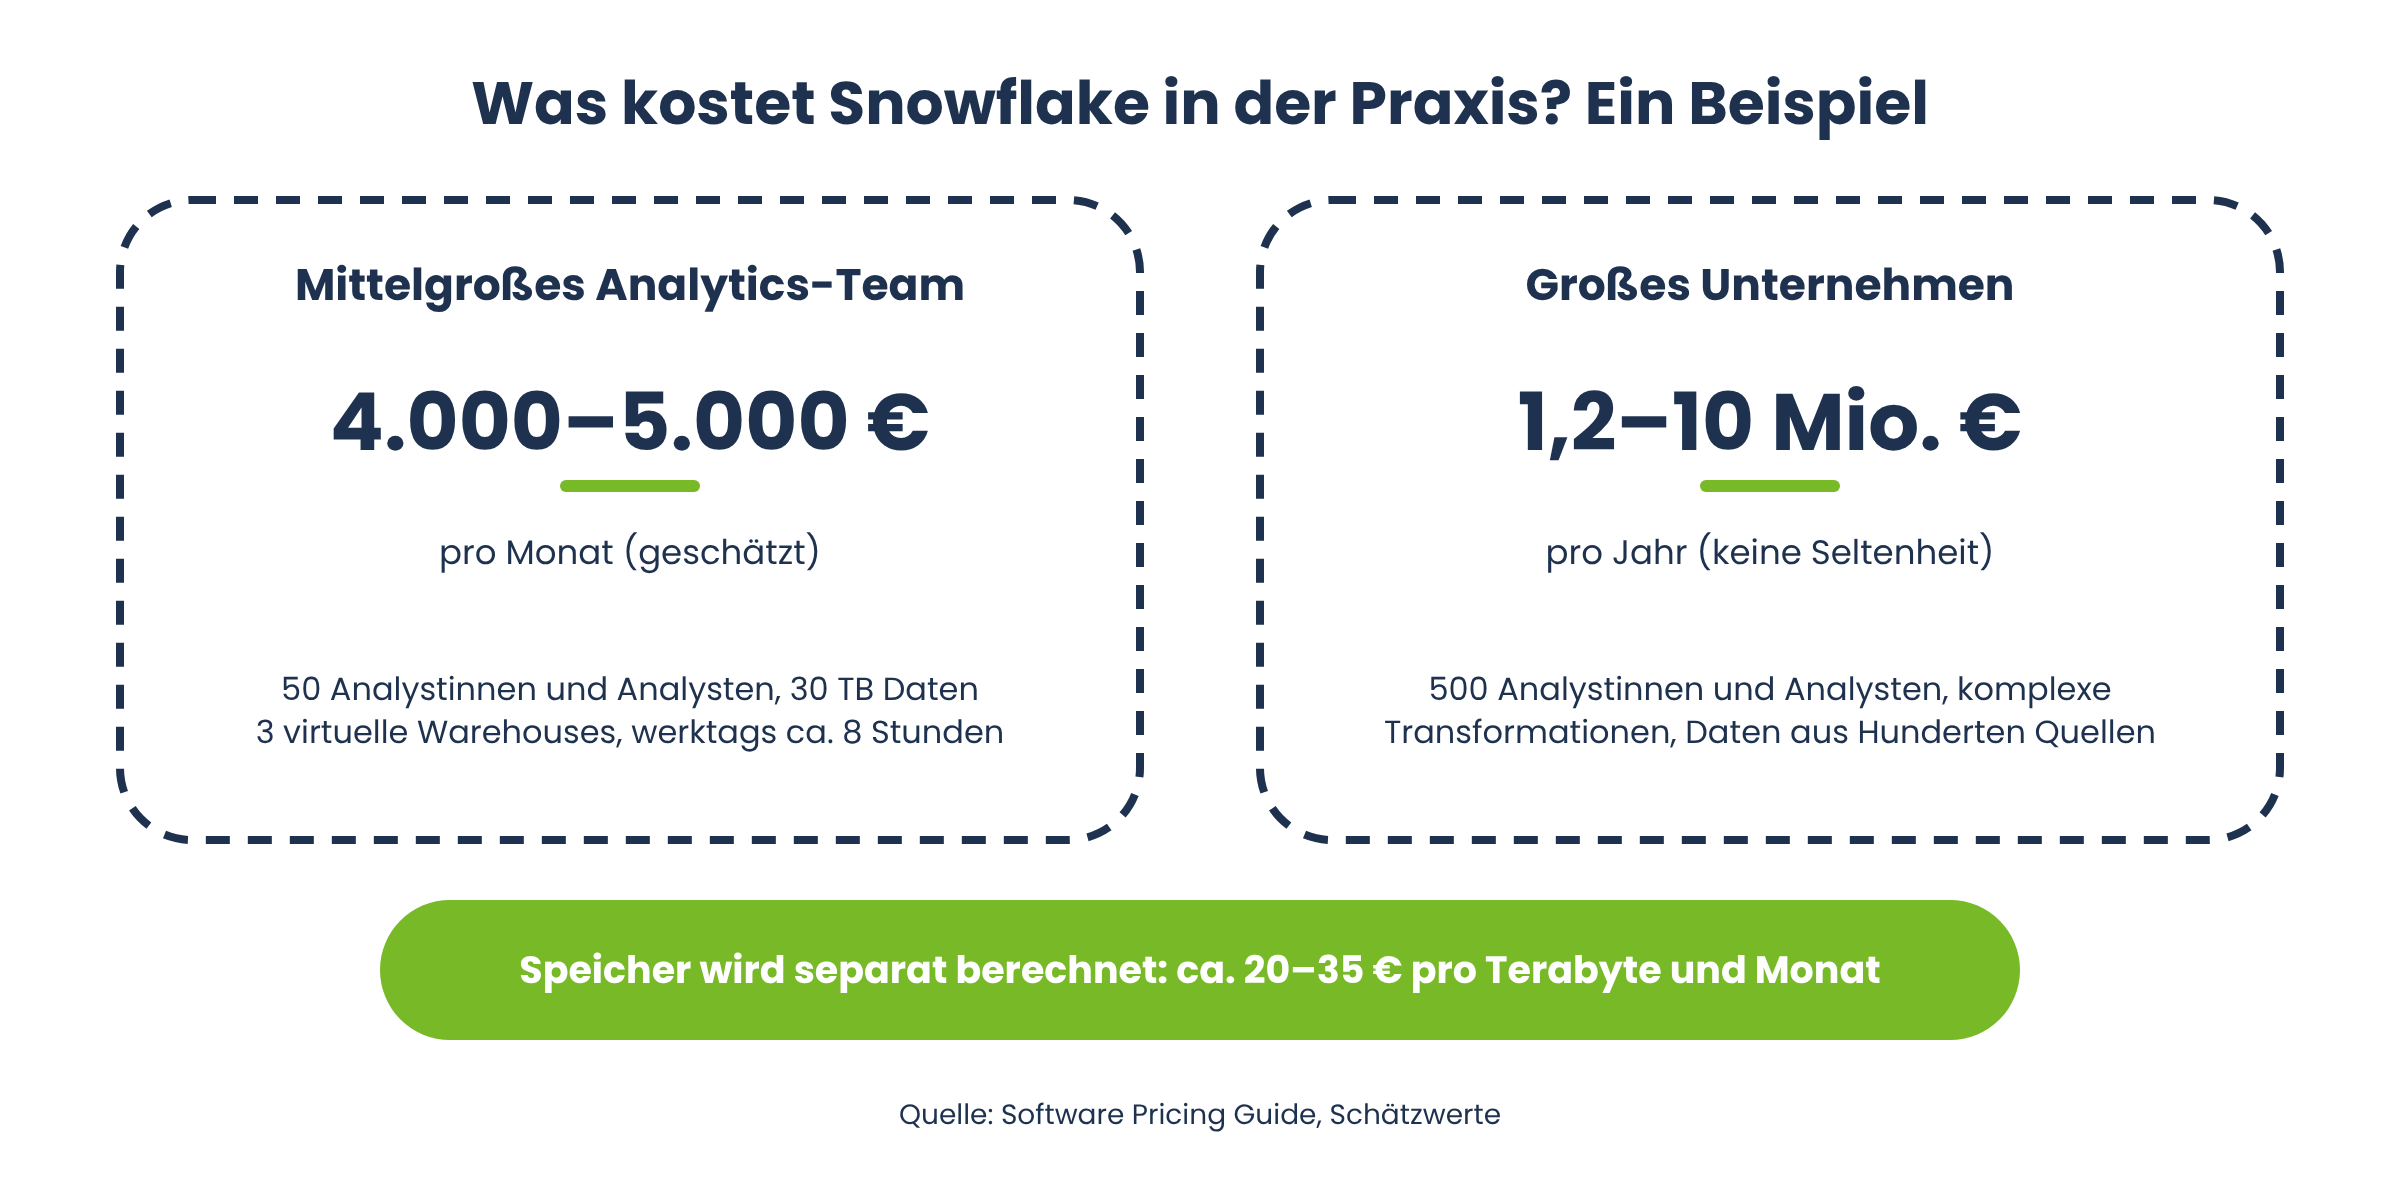
Zahlen helfen mehr als abstrakte Preismodelle. Ein mittelgroßes Analytics-Team mit rund 50 Analystinnen und Analysten, das klassische BI-Workloads betreibt, kommt bei 30 Terabyte komprimierten Daten und drei virtuellen Warehouses, die werktags rund acht Stunden laufen, auf geschätzte Gesamtkosten von etwa 4.000 bis 5.000 Euro pro Monat, also rund 40.000 bis 60.000 Euro im Jahr. Skaliert man dieses Szenario auf ein großes Unternehmen mit 500 Analystinnen und Analysten, komplexen Transformationen und kontinuierlichen Datenladevorgängen aus Hunderten Quellen, ist ein jährlicher Snowflake-Betrag von 1,2 bis 10 Millionen Euro keine Seltenheit (Software Pricing Guide).
Speicher wird bei Snowflake separat abgerechnet: Snowflake charges rund 20 bis 35 Euro pro Terabyte und Monat, abhängig von Cloud-Anbieter und Kompressionsgrad. Durch die spaltenbasierte Kompression wird ein typischer Datenbestand oft auf ein Drittel seines ursprünglichen Volumens reduziert.
Was kostet Databricks in der Praxis?
Bei Databricks lässt sich kein vergleichbar einfaches Rechenbeispiel aufstellen, weil die Kosten stark vom Workload-Mix abhängen: Jobs Compute für automatisierte Pipelines ist günstiger als All-Purpose Compute für interaktive Notebooks, und Model Serving für den Betrieb von ML-Modellen wird meist nach Token oder Rechenzeit abgerechnet. Die Kostenstruktur von Databricks kann komplex sein, insbesondere bei intensiver Nutzung mehrerer Cluster-Typen parallel. Wer Databricks realistisch kalkulieren will, sollte deshalb DBU-Kosten, Cloud-Infrastrukturkosten und den internen Aufwand für Cluster-Tuning gemeinsam betrachten.
Total Cost of Ownership (TCO): Wer ist am Ende günstiger?
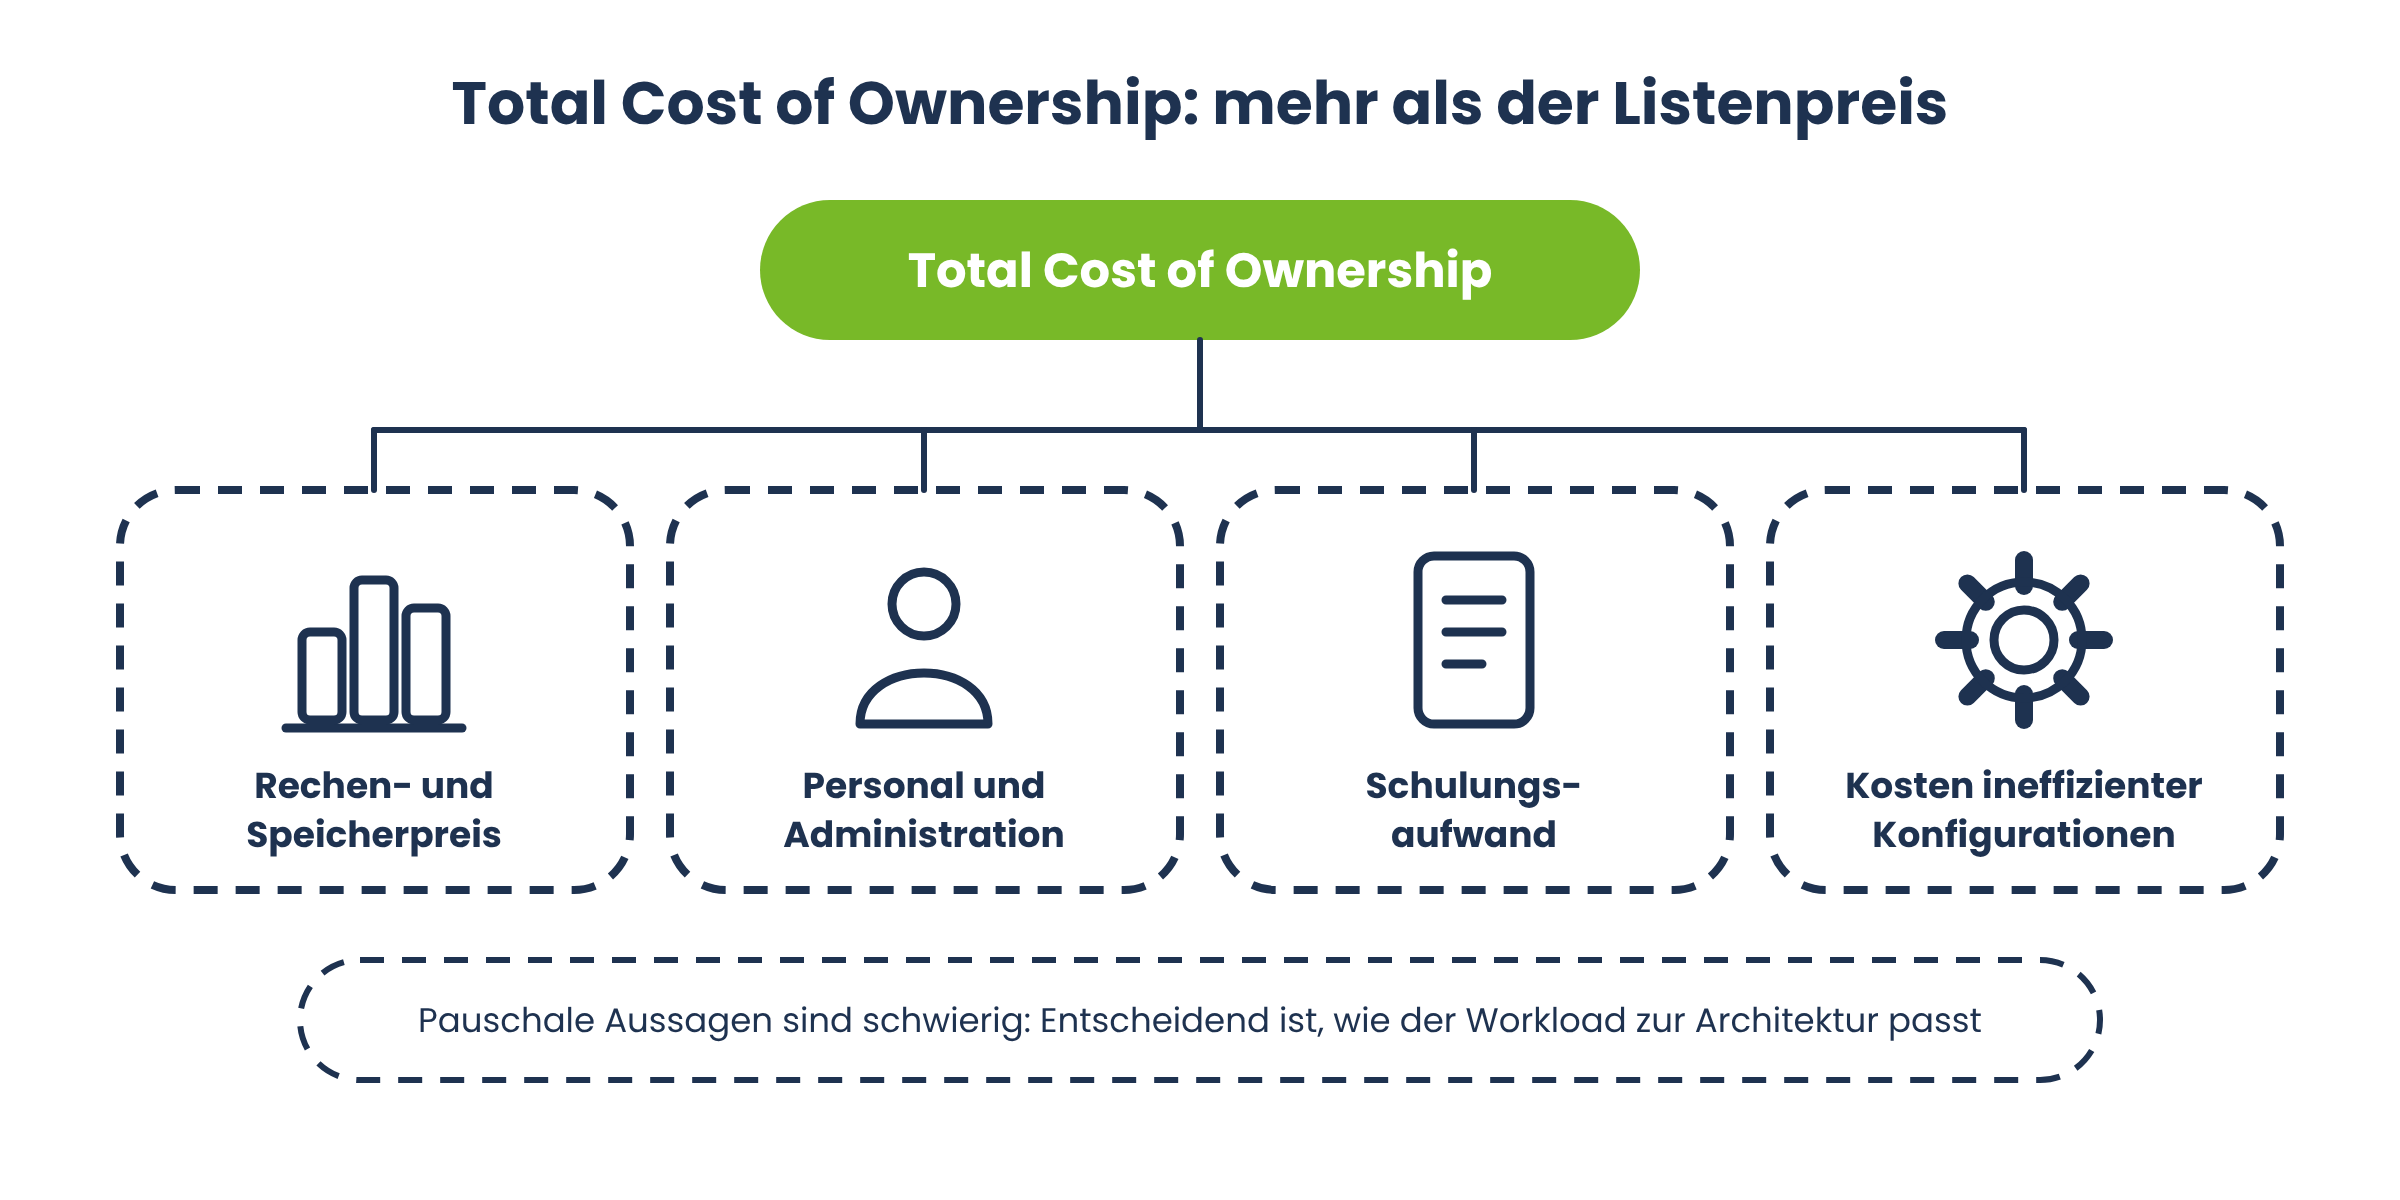
Die Total Cost of Ownership beschreibt die vollständigen Kosten einer Plattform über ihren gesamten Nutzungszeitraum, nicht nur den reinen Rechen- und Speicherpreis. Dazu zählen auch Personalkosten für Administration, Schulungsaufwand und die Kosten ineffizienter Konfigurationen. Die Entscheidung zwischen Databricks und Snowflake hängt von den spezifischen Anforderungen ab, und genau das macht pauschale Aussagen zur TCO so schwierig.
Wann ist Snowflake günstiger?
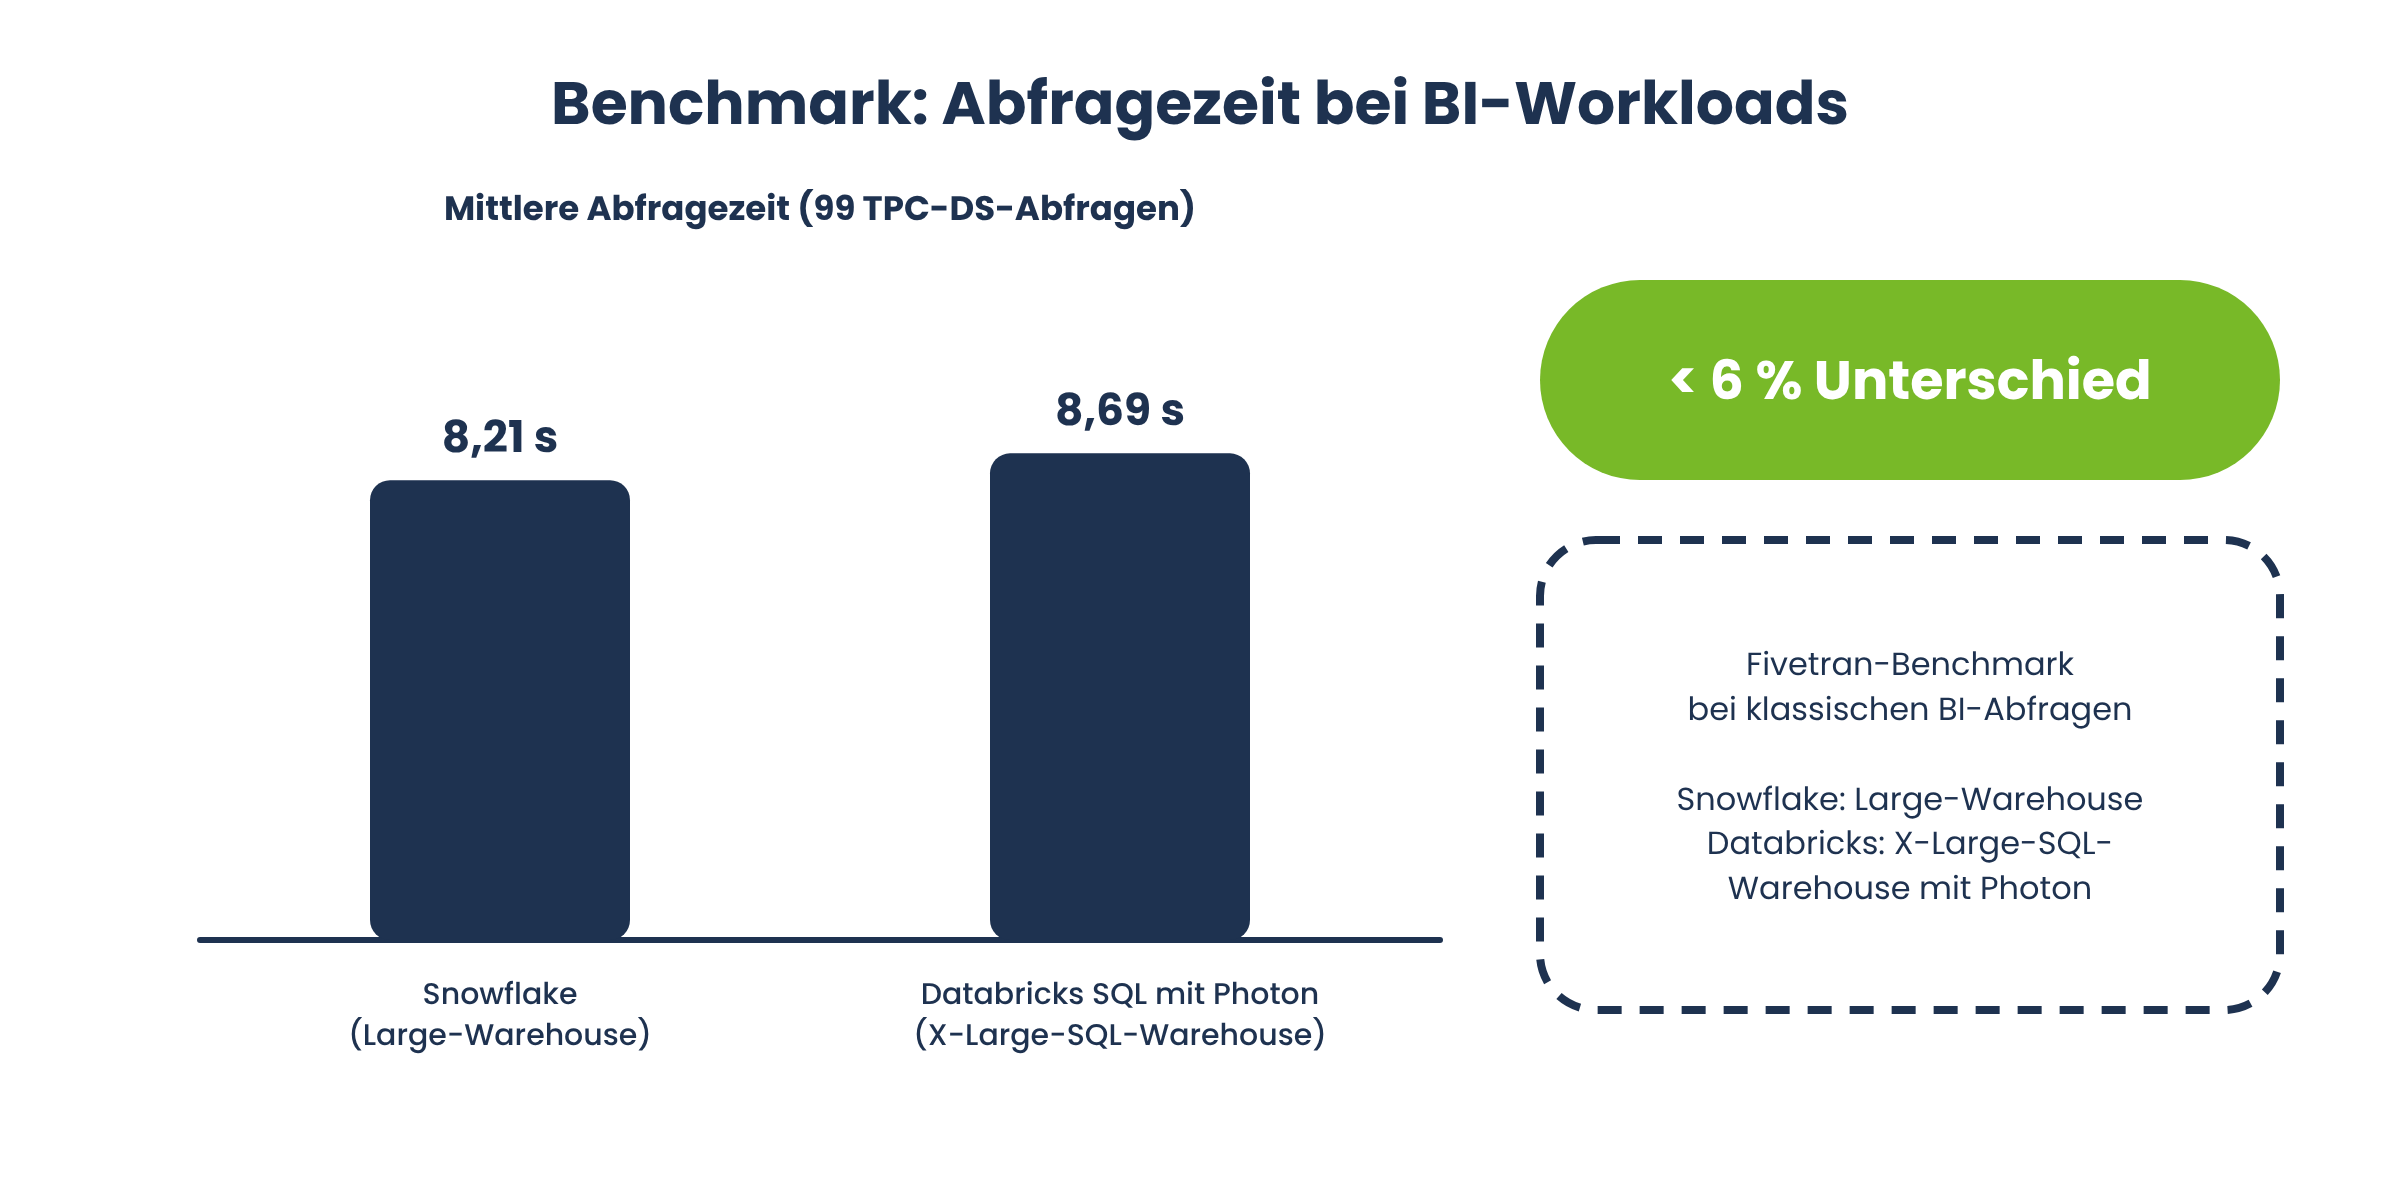
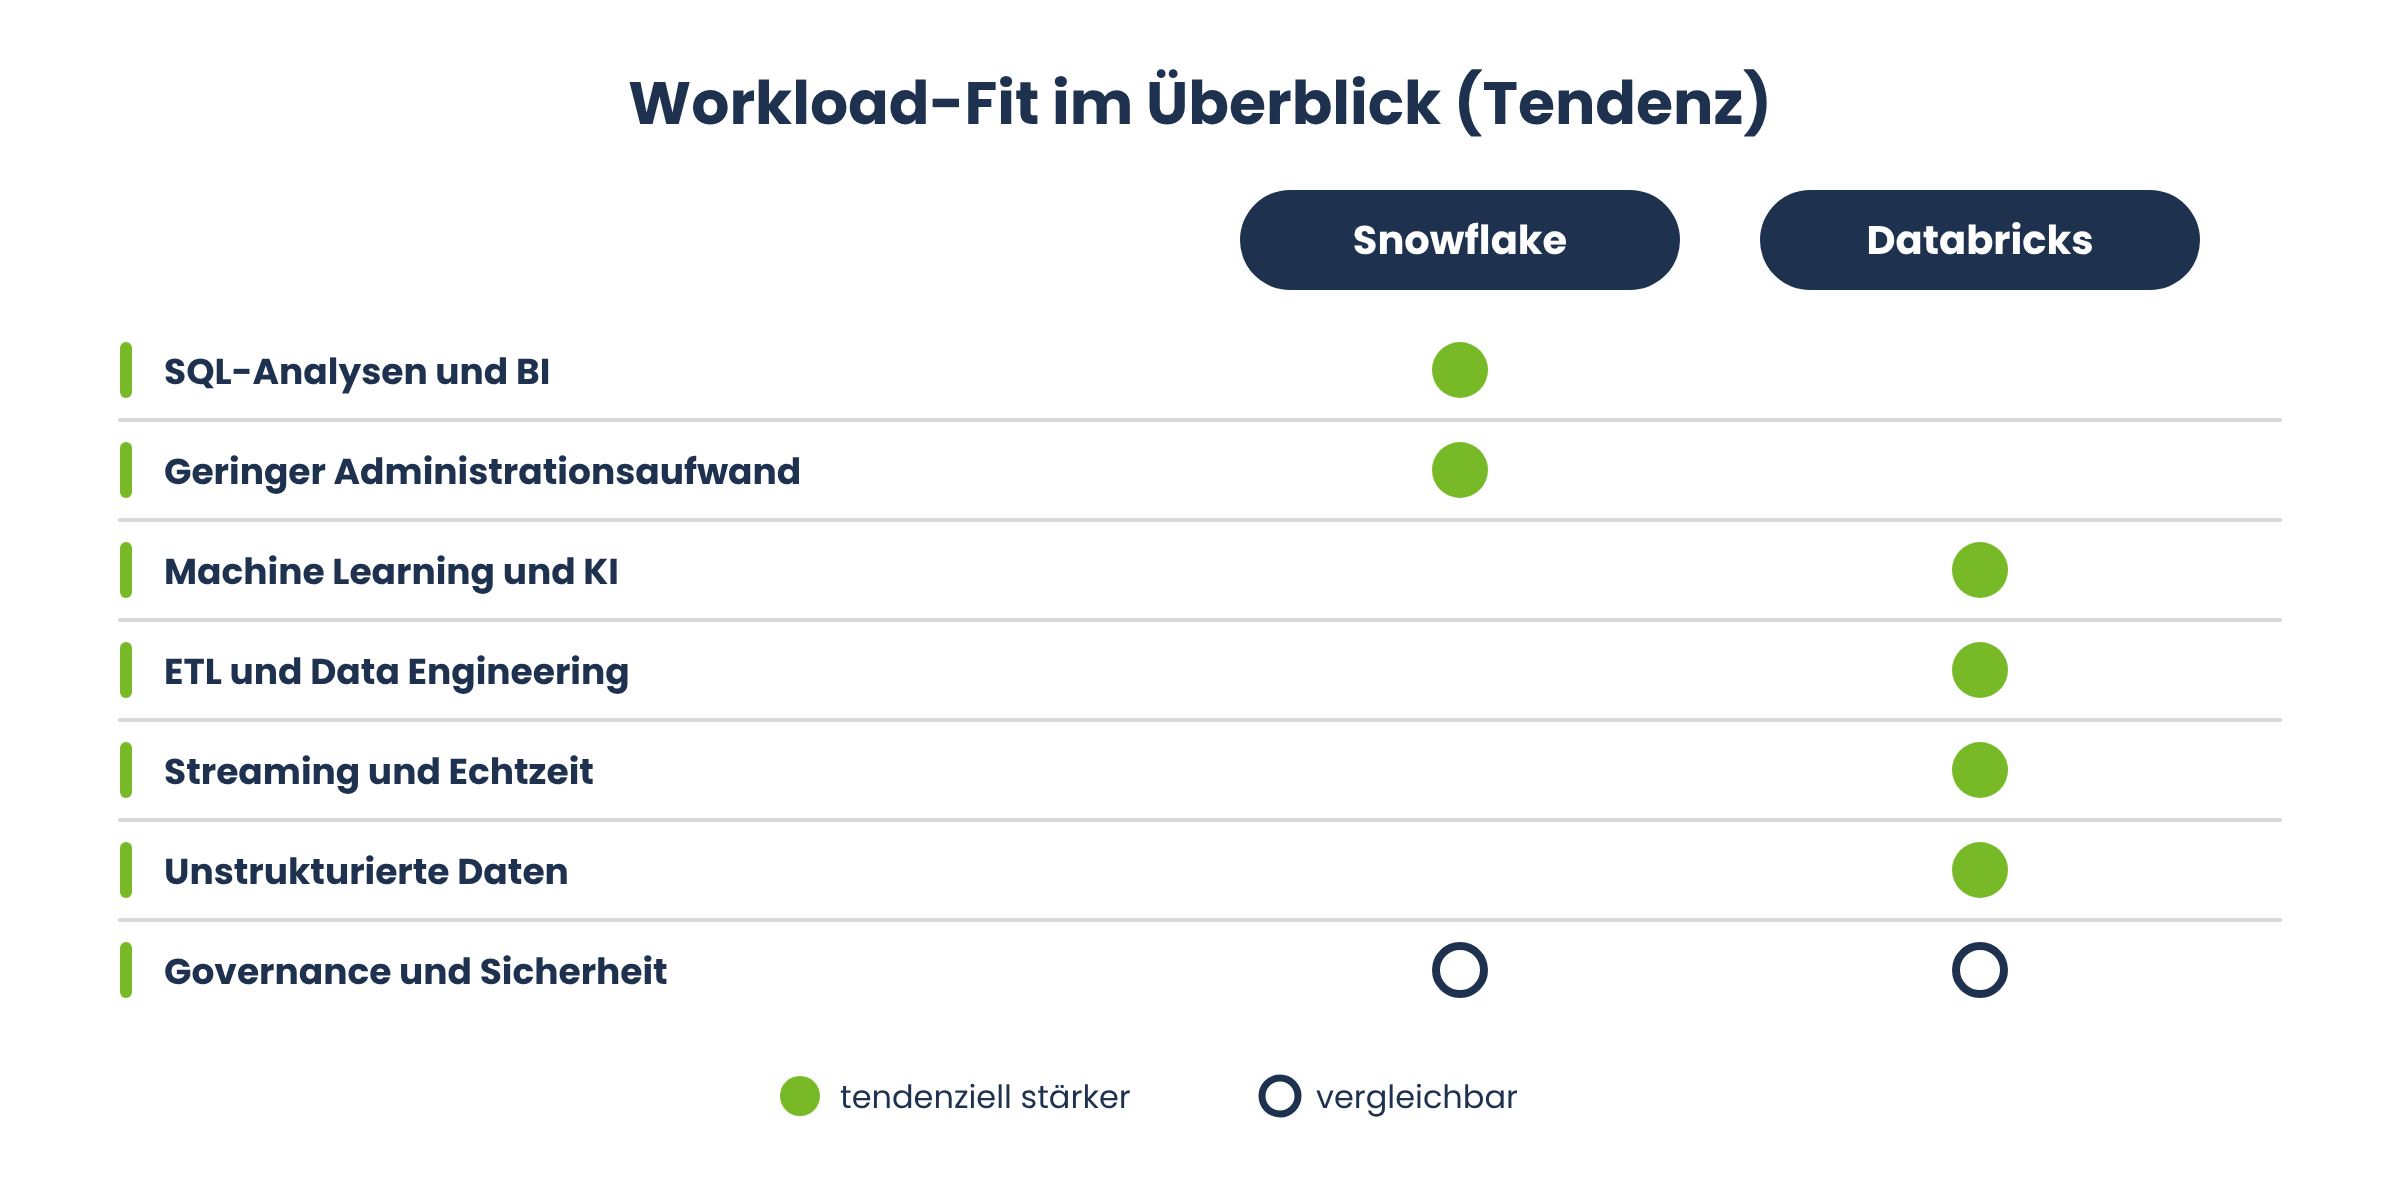
Für reine SQL-Analysen und BI-Workloads ist Snowflake häufig die kosteneffizientere Wahl. Das Nebenläufigkeitsmodell, die automatische Skalierung und die ausgereifte Query-Performance für große SQL-Workloads sorgen dafür, dass Unternehmen mit klassischen Reporting-Anforderungen bei Snowflake oft eine niedrigere Total Cost of Ownership erzielen (Software Pricing Guide). Auch unabhängige Benchmarks bestätigen diesen Trend: Der Fivetran-Benchmark auf Basis der 99 offiziellen TPC-DS-Abfragen ermittelte für Snowflake auf einem Large-Warehouse eine mittlere Abfragezeit von 8,21 Sekunden gegenüber 8,69 Sekunden für Databricks SQL mit Photon auf einem vergleichbaren X-Large-SQL-Warehouse – ein Unterschied von unter 6 Prozent bei klassischen BI-Abfragen (Tech Insider).
Wann ist Databricks günstiger?
Für Machine-Learning-, KI- und Data-Engineering mit Python oder Spark ist Databricks in der Regel kosteneffizienter und leistungsfähiger. Databricks kann eine niedrigere Total Cost of Ownership für gemischte Workloads erzielen, wenn Data Engineering, ETL und Machine Learning auf derselben Plattform stattfinden, statt zusätzliche Tools zu integrieren (Software Pricing Guide).
Warum reicht ein reiner Preisvergleich nicht aus?
Der Listenpreis pro Recheneinheit sagt wenig über die tatsächlichen Kosten aus. Entscheidend ist, wie gut ein Workload zur jeweiligen Architektur passt. Ein Beispiel aus der Praxis: Ein Versicherungsunternehmen mit stabilen, planbaren SQL-Reports über Nacht fährt mit Snowflake oft günstiger, weil ungenutzte Warehouses automatisch pausieren. Ein Unternehmen mit kontinuierlichem Streaming von Sensordaten und Modelltraining profitiert dagegen häufig von der Flexibilität der Databricks-Cluster.
Wie lassen sich die Kosten beider Plattformen senken?
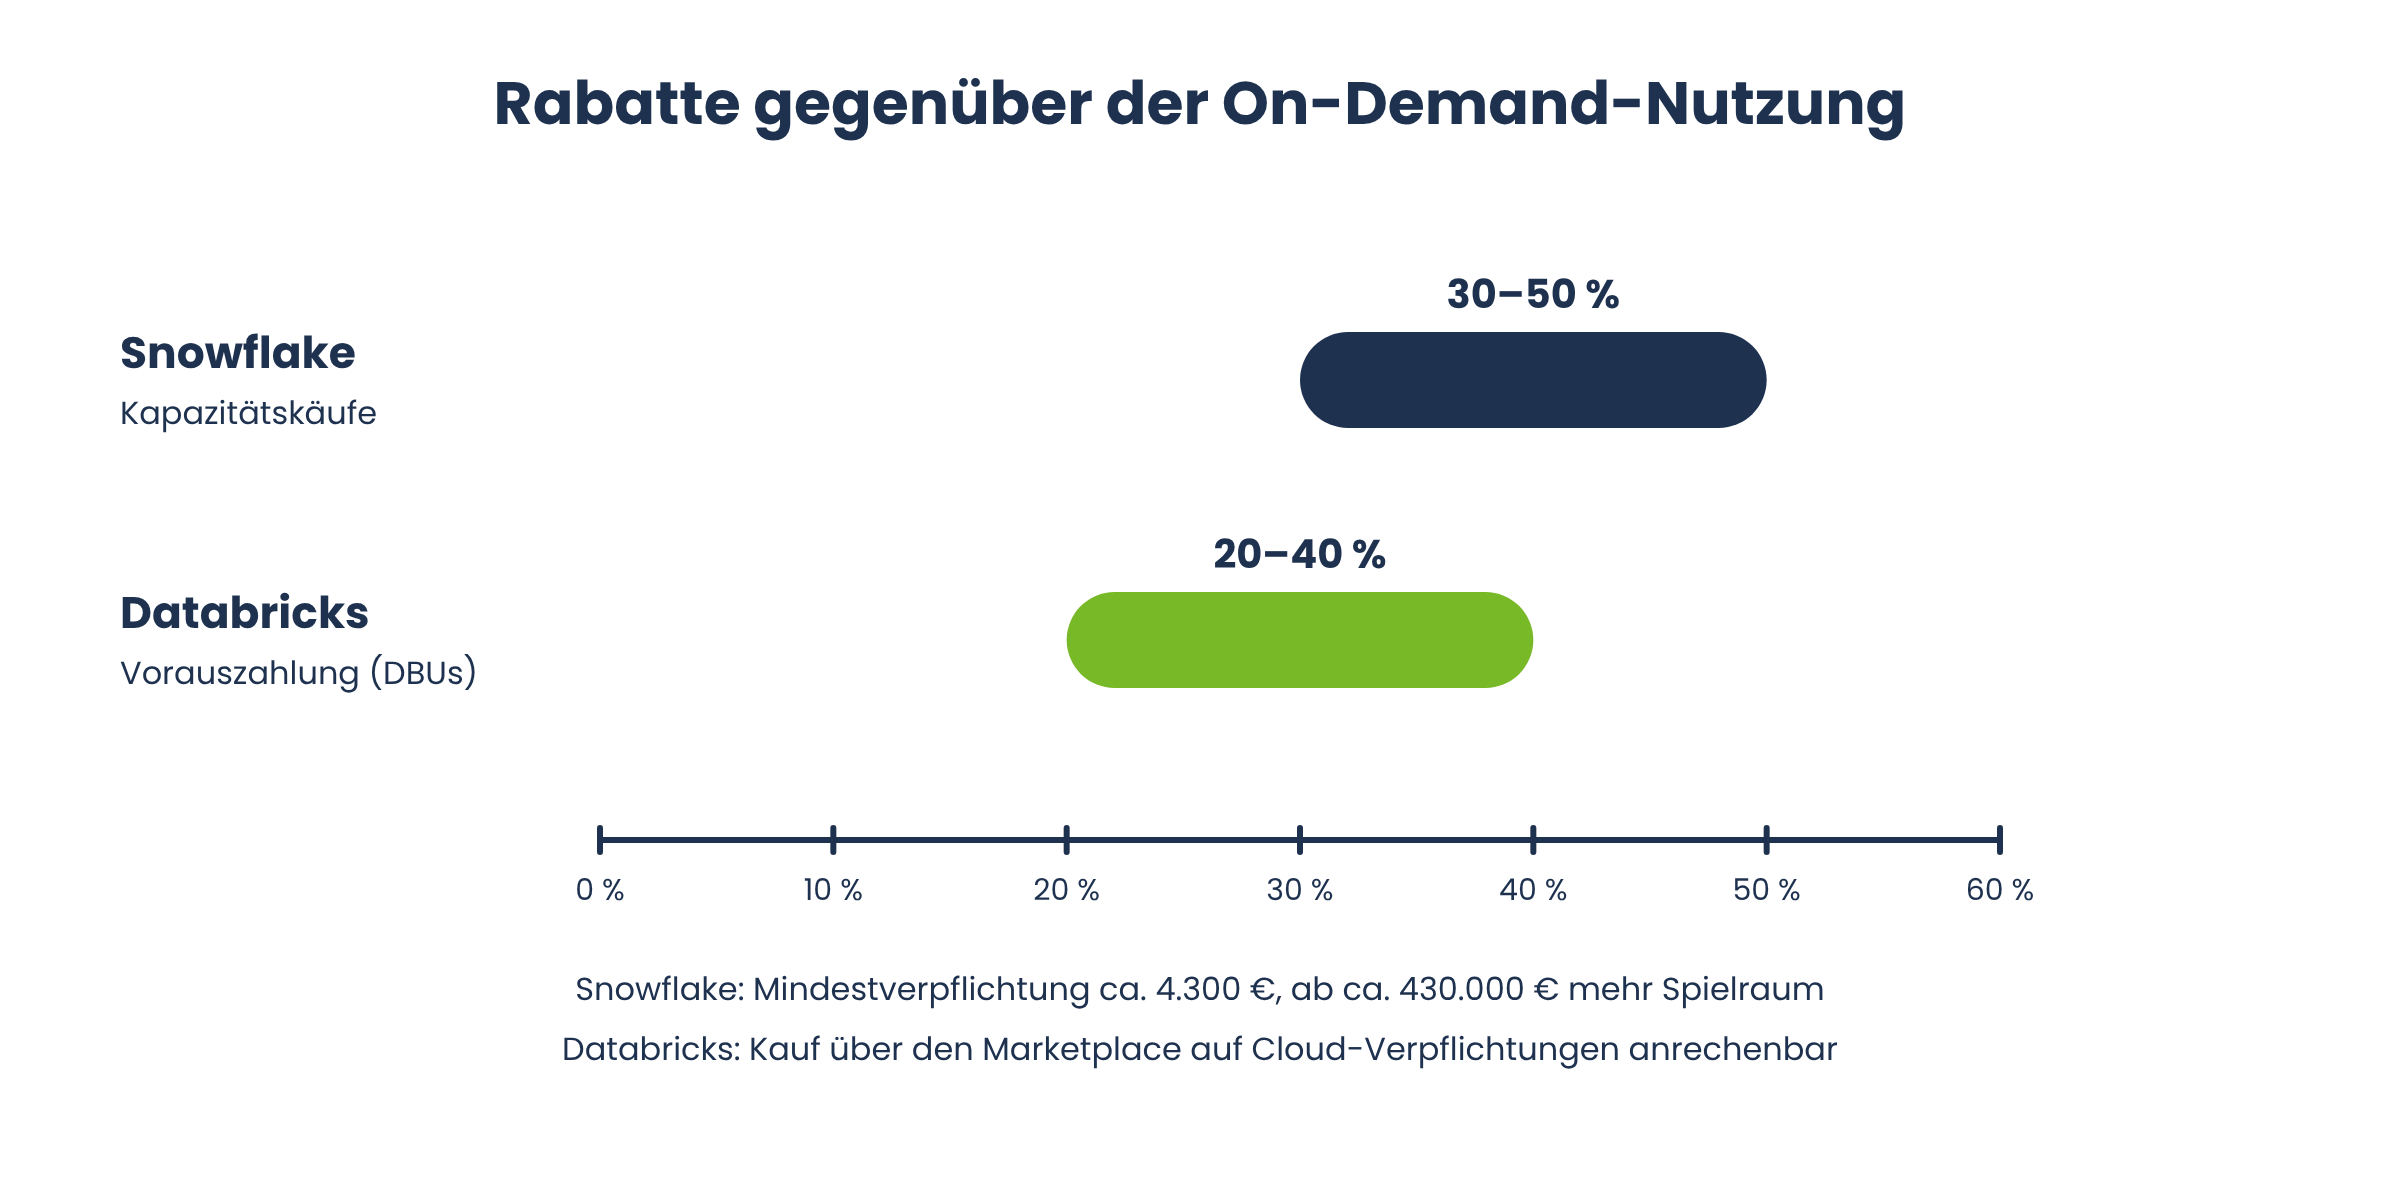
Beide Anbieter bieten deutliche Rabatte gegenüber der On-Demand-Nutzung, wenn Unternehmen sich langfristig binden.
Rabatte und Kapazitätsverträge bei Snowflake
Snowflake kann durch Kapazitätskäufe die Kosten um 30 bis 50 Prozent senken. Die Mindestverpflichtung für Kapazitätspreise liegt üblicherweise bei rund 4.300 Euro, größere Jahresverpflichtungen ab etwa 430.000 Euro eröffnen zusätzlichen kommerziellen Spielraum und einen dedizierten Ansprechpartner (Software Pricing Guide).
Rabatte und Prepaid-Modelle bei Databricks
Databricks bietet 20 bis 40 Prozent Rabatte bei Vorauszahlungen für DBUs. Jährliche und mehrjährige Prepaid-Vereinbarungen sind bei Enterprise-Kunden das gängige kommerzielle Modell. Zusätzlich lässt sich ein Kauf über den Databricks-Marktplatz bei AWS, Azure oder GCP häufig auf bestehende Cloud-Verpflichtungen anrechnen, was einen weiteren Kostenvorteil schafft (Software Pricing Guide).
Datenverarbeitung: Strukturierte und unstrukturierte Daten
Ein zentraler Unterschied zwischen Databricks und Snowflake liegt darin, welche Datentypen sich effizient verarbeiten lassen. Snowflake ist historisch auf strukturierte Daten wie Tabellen und klassische Datenbankformate spezialisiert, unterstützt inzwischen aber auch semistrukturierte Formate wie JSON oder XML und unstrukturierte Daten wie Bilder oder Videos. Databricks eignet sich dagegen für strukturierte und unstrukturierte Daten gleichermaßen: Bilder, Videos, Freitext, Logdateien und Sensordaten lassen sich direkt im Data Lake ablegen und für Machine-Learning-Projekte nutzen, ohne vorher in ein festes Tabellenschema überführt zu werden.
Was ist Unity Catalog und warum ist er für Databricks wichtig?
Unity Catalog ist die zentrale Governance-Ebene von Databricks für Daten und KI-Assets. Er bietet einen einzigen Ort, um Zugriffsrechte zu steuern, Datenherkunft nachzuverfolgen, sensible Daten zu klassifizieren und Datenqualität über Cloud-Grenzen hinweg zu überwachen (Databricks). Vor Unity Catalog mussten Unternehmen häufig mehrere Governance-Tools kombinieren, etwa für Zugriffskontrolle, Datenherkunft und Compliance. Unity Catalog bündelt diese Funktionen und macht sie über Standard-SQL-Befehle wie GRANT und REVOKE steuerbar.
Was ist Delta Lake und welche Rolle spielt er im Lakehouse-Ansatz?
Delta Lake ist das offene Speicherformat, auf dem die Databricks-Lakehouse-Architektur aufbaut. Es erweitert klassische Data-Lake-Formate um Transaktionssicherheit, Versionierung und Schema-Durchsetzung, Funktionen, die bislang vor allem klassischen Datenbanken vorbehalten waren. Für dich bedeutet das: Du kannst große Datenmengen im kostengünstigen Cloud Object Storage ablegen, ohne auf die Zuverlässigkeit eines klassischen Data Warehouse verzichten zu müssen.
Data Sharing: Wie funktioniert Delta Sharing im Vergleich zu Snowflakes Datenfreigabe?
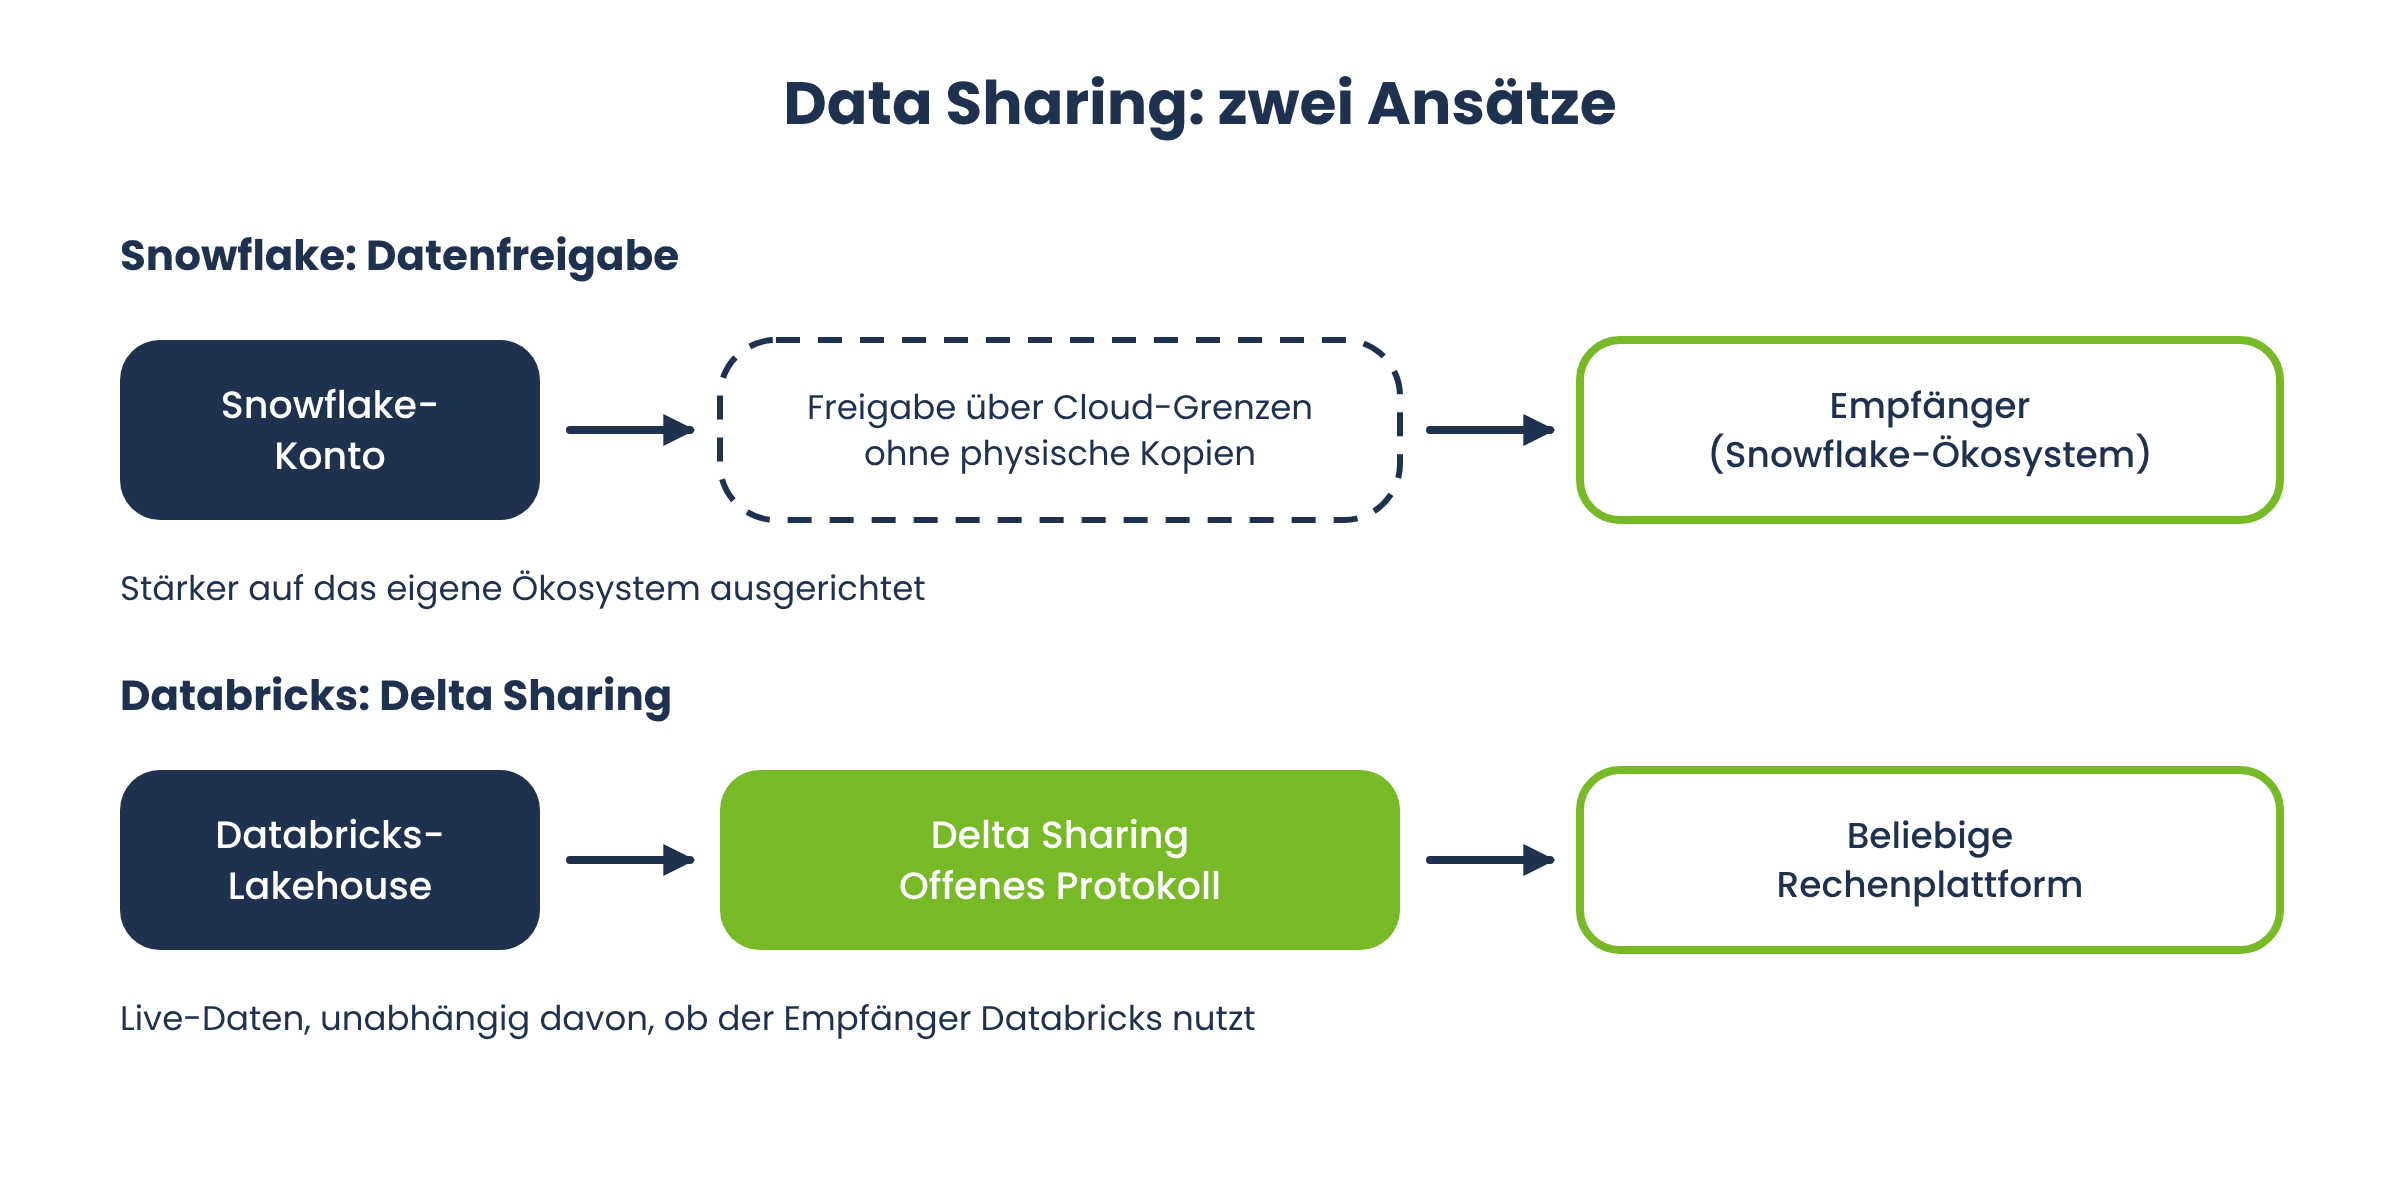
Beide Plattformen legen großen Wert auf sicheren Datenaustausch zwischen Unternehmen. Snowflakes Architektur ermöglicht nahtlose Datenfreigabe über Cloud-Grenzen hinweg, ohne dass Daten physisch kopiert werden müssen. Databricks setzt auf Delta Sharing, ein offenes Protokoll, mit dem Live-Daten aus dem Lakehouse an beliebige andere Rechenplattformen freigegeben werden können, unabhängig davon, ob der Empfänger selbst Databricks nutzt. Für Unternehmen, die Daten mit Partnern, Lieferanten oder Kunden austauschen, ist dieser Unterschied relevant: Delta Sharing setzt auf einen offenen Standard, während Snowflakes Datenfreigabe stärker auf das eigene Ökosystem ausgerichtet ist.
Machine Learning und KI: Wo hat Databricks die Nase vorn?
Databricks entstand aus Apache Spark und hat Machine Learning von Beginn an in den Kern der Plattform integriert. Databricks ist tendenziell besser geeignet für datengestützte Analysen mit umfangreicher ML-Komponente und bietet mit MLflow, Feature Store und Model Serving eine durchgängige Umgebung für den gesamten Machine-Learning-Lebenszyklus, vom Training bis zur Bereitstellung. Snowflake hat mit Cortex AI und Snowpark ML in den vergangenen Jahren aufgeholt, bleibt aber bei komplexen, individuell trainierten Modellen und verteiltem Training häufig im Nachteil gegenüber der nativen Spark-Umgebung von Databricks.
SQL-Analysen und Business Intelligence: Die Stärke von Snowflake
Snowflake ist optimiert für hochperformante SQL-Abfragen und für klassische Business-Intelligence-Anwendungen. Wenn dein Team überwiegend mit SQL arbeitet, Dashboards baut und Ad-hoc-Analysen fährt, bietet Snowflake eine besonders geringe Einstiegshürde: Snowflake is designed for SQL-based business intelligence applications, ohne dass Nutzerinnen und Nutzer Cluster konfigurieren oder Spark-Kenntnisse mitbringen müssen. Diese Einfachheit ist einer der Hauptgründe, warum viele BI-Teams Snowflake gegenüber Databricks bevorzugen.
Data Engineering und ETL/ELT-Workloads
ETL und ELT, also das Extrahieren, Transformieren und Laden von Daten, gehören zu den ressourcenintensivsten Aufgaben moderner Dateninfrastruktur. Databricks eignet sich besser für umfangreiche ETL-Pipelines und Machine-Learning-Projekte, weil native Spark-Unterstützung komplexe Transformationen parallelisiert verarbeiten kann. Databricks selbst wirbt damit, dass ETL-Workloads auf Snowflake im eigenen Vergleich bis zu neunmal teurer ausfallen können als auf der Databricks-Lakehouse-Plattform – eine Kennzahl, die als Herstellerangabe eingeordnet werden sollte und je nach Workload stark variiert (Databricks). Unabhängig von der genauen Zahl gilt: ETL-Workloads machen häufig 50 Prozent oder mehr der gesamten Datenplattformkosten eines Unternehmens aus, weshalb sich eine genaue Prüfung in jedem Fall lohnt.
Data Lakes und Data Warehouses: Wo liegt der Unterschied?
Data Lakes und Data Warehouses verfolgen unterschiedliche Philosophien. Ein Data Warehouse speichert vorstrukturierte, bereinigte Daten für Reporting und Analysen, ein Data Lake speichert Rohdaten in nahezu beliebigem Format und beliebiger Struktur. Snowflake stammt aus der Data-Warehouse-Tradition, Databricks aus der Data-Lake-Welt, kombiniert im Lakehouse-Ansatz aber die Governance eines Warehouse mit der Flexibilität eines Lakes. Für viele Unternehmen ist genau diese Kombination der Grund, warum sie sich für einen Lakehouse-Ansatz statt eines klassischen Warehouse entscheiden.
Governance und Sicherheit im Vergleich
Snowflake bietet starke Governance- und Datenfreigabe-Funktionen, darunter rollenbasierte Zugriffskontrolle, dynamische Datenmaskierung und Row-Level-Security als Standardfunktionen. Databricks bietet mit Unity Catalog eine vergleichbar tiefgreifende Governance-Ebene, die zusätzlich KI-Modelle, Funktionen und Agenten als eigenständige, absicherbare Objekte behandelt. Für regulierte Branchen wie Versicherungen oder den öffentlichen Sektor ist entscheidend, dass beide Plattformen Compliance-Zertifizierungen und feingranulare Zugriffskontrollen anbieten, allerdings mit unterschiedlichem Reifegrad je nach gewähltem Tarif.
Cloud-Infrastruktur: Multi-Cloud-Unterstützung bei beiden Plattformen
Snowflake supports AWS, Azure, and GCP, sodass Unternehmen Snowflake unabhängig vom bestehenden Cloud-Provider einsetzen können. Auch Databricks integriert sich eng mit cloud-nativen Diensten und ist auf allen drei großen Hyperscalern verfügbar.Beide Plattformen unterstützen die Integration verteilter Datenquellen, was besonders für Unternehmen mit gewachsenen, heterogenen IT-Landschaften relevant ist. Ein Unterschied bleibt bestehen: Databricks integriert sich oft enger mit den nativen Diensten des jeweiligen Cloud-Providers, etwa Azure Data Lake Storage oder AWS Glue, während Snowflake bewusst eine einheitliche Erfahrung über alle Clouds hinweg anbietet.
Skalierbarkeit: Virtuelle Warehouses vs. SQL-Warehouses und Cluster
Snowflake skaliert über virtuelle Warehouses, die sich unabhängig voneinander in Sekunden hoch- oder herunterskalieren lassen, ohne dass Daten neu verteilt werden müssen. Databricks skaliert über Cluster und SQL-Warehouses, die je nach Konfiguration automatisch zusätzliche Knoten hinzufügen oder entfernen. Beide Ansätze eignen sich für großangelegte Datenverarbeitung, unterscheiden sich aber in der Feinsteuerung: Snowflake-Warehouses sind einfacher zu konfigurieren, Databricks-Cluster bieten mehr Kontrolle über Instanztypen, Autoscaling-Grenzen und Spot-Instanzen.
Programmiersprachen und Entwicklerfreundlichkeit
Databricks unterstützt diverse Programmiersprachen, darunter Python, Scala, R und SQL, häufig innerhalb desselben Notebooks kombinierbar. Das macht die Plattform besonders attraktiv für Data-Scientist-Teams, die in unterschiedlichen Sprachen arbeiten. Snowflake war lange Zeit primär SQL-zentriert, hat mit Snowpark aber Unterstützung für Python, Java und Scala nachgerüstet. Für Teams, die überwiegend SQL-Kenntnisse mitbringen, bleibt Snowflake dennoch die zugänglichere Plattform.
Anwendungsfälle: Für welche Unternehmen eignet sich Snowflake?
Snowflake ist ideal für Unternehmen, die wenig Infrastrukturmanagement wünschen und ihren Fokus auf SQL-basierte Analysen, Reporting und Datenfreigabe legen. Typische Anwendungsfälle sind:
Zentrales BI-Reporting für mehrere Fachabteilungen.
Data Sharing mit Partnern oder Tochtergesellschaften ohne Datenkopien.
Konsolidierung mehrerer Altsysteme in einem zentralen Data Warehouse.
Compliance-getriebene Anwendungen mit hohen Anforderungen an Governance.
Anwendungsfälle: Für welche Unternehmen eignet sich Databricks?
Databricks ist geeignet für unstrukturierte Daten und KI-Modelle sowie für Unternehmen, deren Datenstrategie stark auf Machine Learning, GenAI und Data Engineering ausgerichtet ist. Typische Anwendungsfälle sind:
Training und Betrieb eigener Machine-Learning-Modelle.
Verarbeitung von Streaming-Daten aus IoT-Sensoren oder Produktionsanlagen in Echtzeit.
Aufbau komplexer, mehrstufiger ETL-Pipelines für heterogene Datenquellen.
Generative-KI-Anwendungen, die auf unternehmenseigenen Daten trainiert oder feinabgestimmt werden.
Praxisbeispiel: Ein Einzelhandelsunternehmen entscheidet sich für Snowflake
Ein Einzelhandelsunternehmen mit mehreren hundert Filialen möchte tägliche Verkaufsdaten aus unterschiedlichen Kassensystemen zentral auswerten. Die Anforderung ist klar umrissen: strukturierte Daten, feste Berichtszyklen, viele gleichzeitige Nutzerinnen und Nutzer im Controlling. In diesem Szenario überzeugt Snowflake durch die einfache Verwaltung, automatische Skalierung bei Lastspitzen zum Monatsabschluss und die Möglichkeit, Daten direkt mit Franchise-Partnern zu teilen, ohne zusätzliche Integrationen zu bauen.
Praxisbeispiel: Ein Industrieunternehmen setzt auf Databricks
Ein Industrieunternehmen sammelt Sensordaten aus Produktionsanlagen, um Ausfälle vorherzusagen. Die Daten fallen kontinuierlich, in hoher Frequenz und in unterschiedlichen Formaten an. Hier spielt Databricks seine Stärken aus: Streaming-Verarbeitung in nahezu Echtzeit, native Machine-Learning-Bibliotheken für die Ausfallprognose und die Möglichkeit, Rohdaten ohne vorheriges Umformatieren direkt im Data Lake zu speichern.
Können Unternehmen Databricks und Snowflake gemeinsam nutzen?
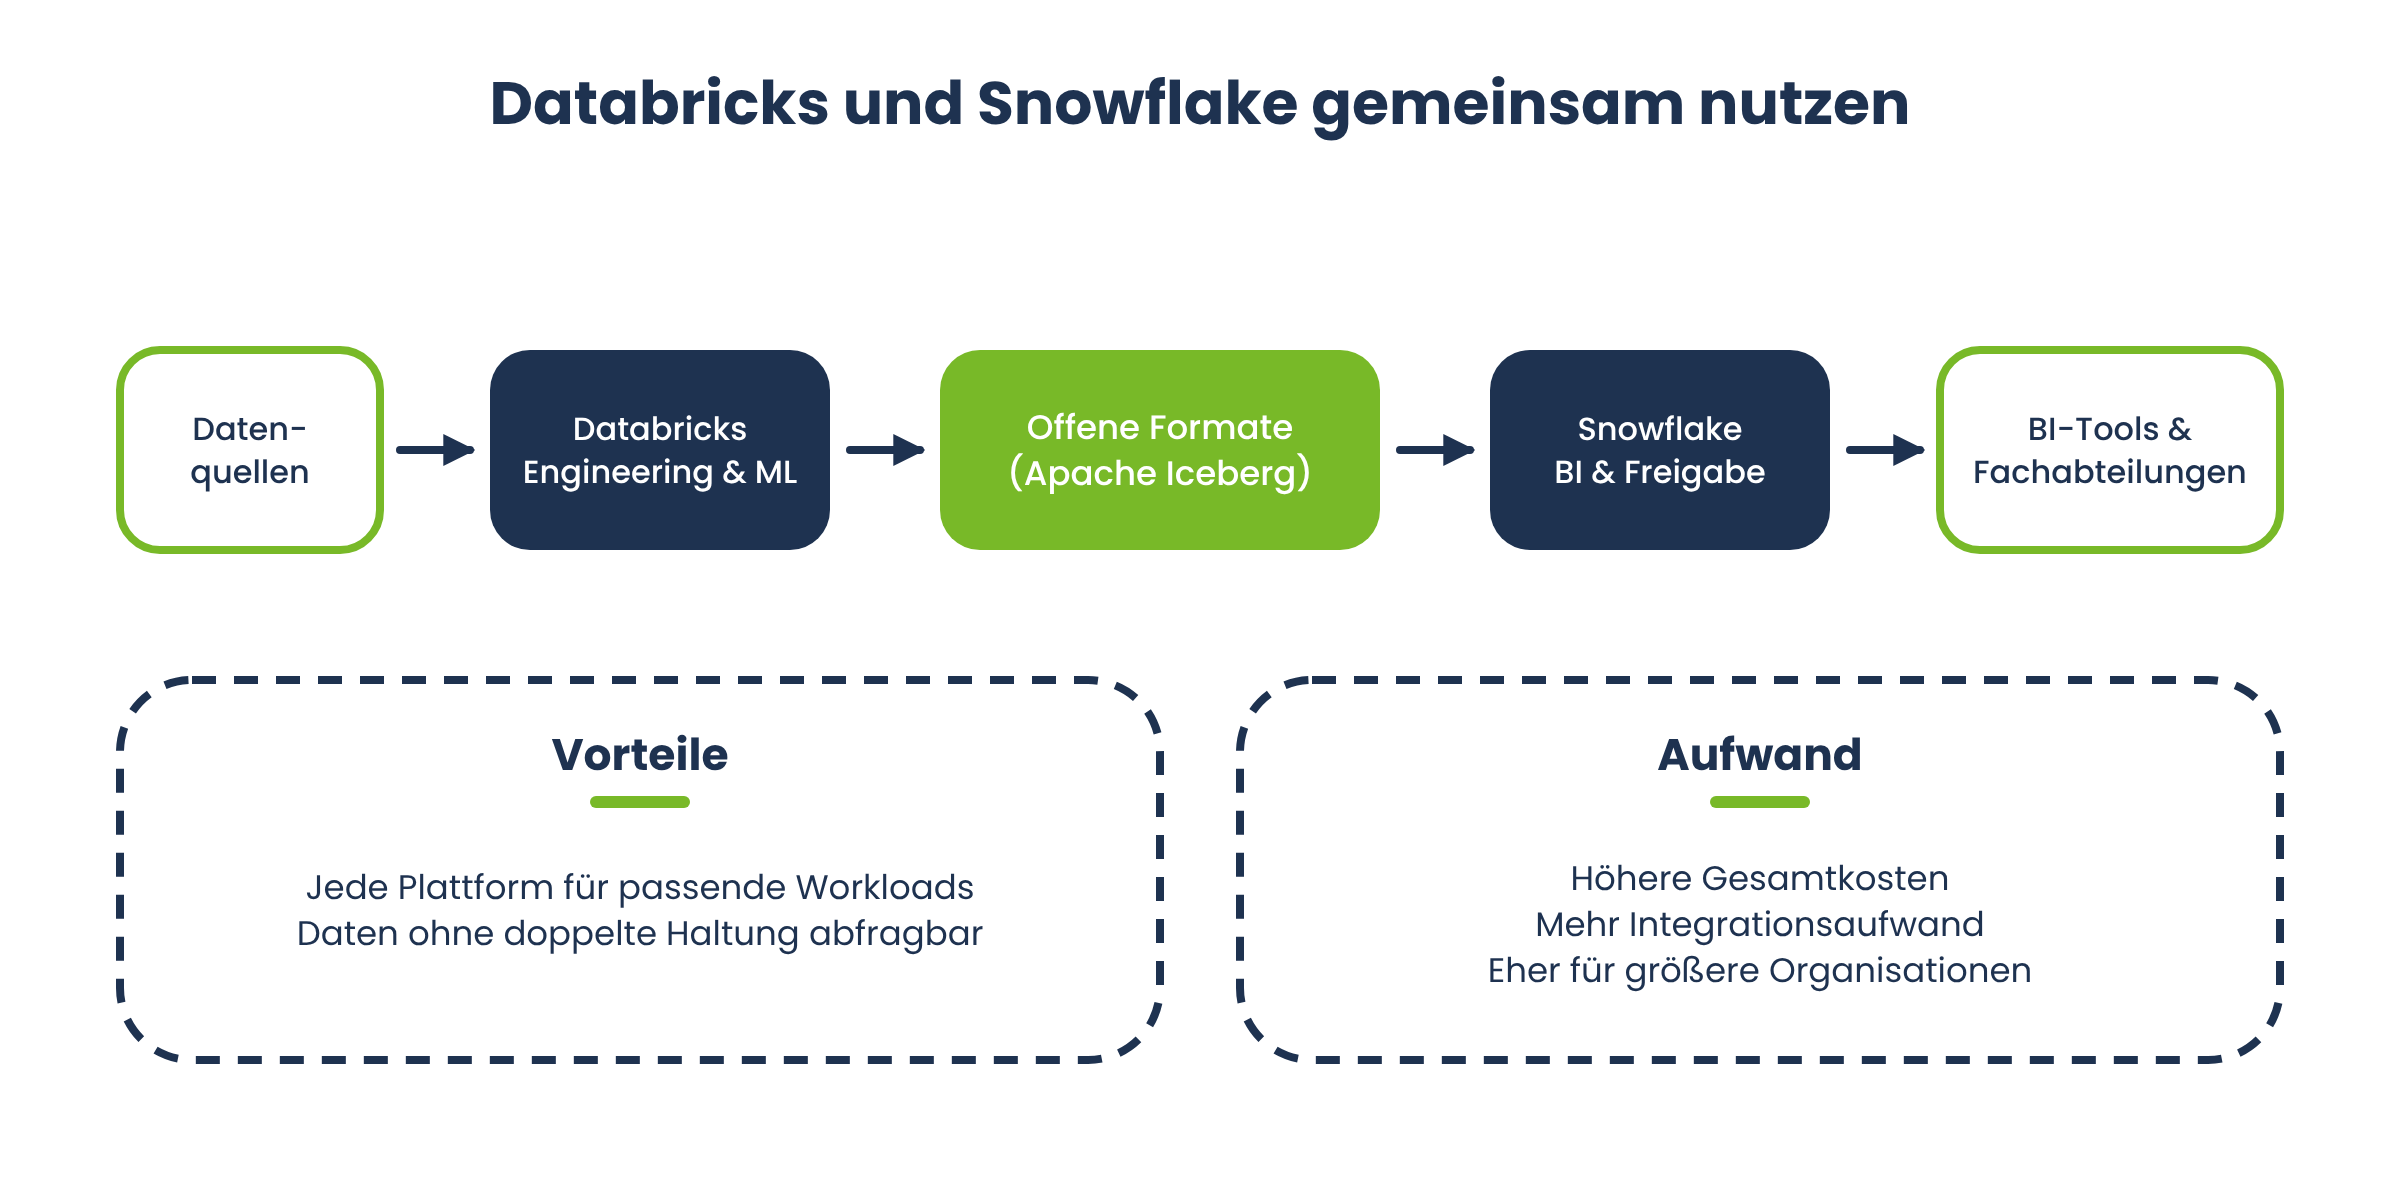
Ja, und in der Praxis ist das inzwischen eine der häufigsten Architekturentscheidungen. Databricks übernimmt Data Engineering und Machine-Learning-Training, Snowflake übernimmt die Bereitstellung der bereinigten, governance-konformen Daten für BI-Tools und SQL-affine Fachabteilungen. Offene Tabellenformate wie Apache Iceberg ermöglichen es, Daten direkt zwischen beiden Plattformen abzufragen, ohne sie doppelt vorzuhalten. Diese Kombination löst das Problem der Workload-Passung, erhöht allerdings auch die Gesamtkosten und den Integrationsaufwand, weshalb sie sich vor allem für größere Organisationen mit entsprechenden Ressourcen eignet.
Vorteile von Snowflake auf einen Blick
Geringer Administrationsaufwand durch vollständig verwaltete Infrastruktur.
Hohe Performance bei klassischen SQL- und BI-Workloads.
Einfache, sichere Datenfreigabe über Unternehmensgrenzen hinweg.
Planbare Kosten durch automatisches Pausieren ungenutzter Warehouses.
Breite Unterstützung für AWS, Azure und GCP.
Herausforderungen von Snowflake
Eingeschränkte native Unterstützung für unstrukturierte Daten.
Machine-Learning-Funktionen sind im Vergleich zu Databricks weniger ausgereift.
Kosten können bei unkontrollierter Nutzung mehrerer Warehouses schnell steigen.
Enge Bindung an das eigene Ökosystem bei einigen Data-Sharing-Funktionen.
Vorteile von Databricks auf einen Blick
Durchgängige Plattform für Data Engineering, Analytics und Machine Learning.
Native Unterstützung für strukturierte und unstrukturierte Daten.
Offene Formate wie Delta Lake und Delta Sharing reduzieren Lock-in-Effekte.
Hohe Flexibilität bei Programmiersprachen und Cluster-Konfiguration.
Starke Eignung für Streaming- und Echtzeit-Anwendungsfälle.
Herausforderungen von Databricks
Höherer Konfigurations- und Administrationsaufwand für Cluster.
DBU-Kosten und Cloud-Infrastrukturkosten müssen separat kalkuliert werden.
Steilere Lernkurve für Teams ohne Spark- oder Python-Erfahrung.
SQL-Erfahrung für reine BI-Nutzerinnen und -Nutzer teils weniger komfortabel als bei Snowflake.
Best Practices für die Plattformwahl
Unabhängig davon, für welche Plattform du dich entscheidest, helfen einige grundsätzliche Vorgehensweisen bei einer fundierten Wahl:
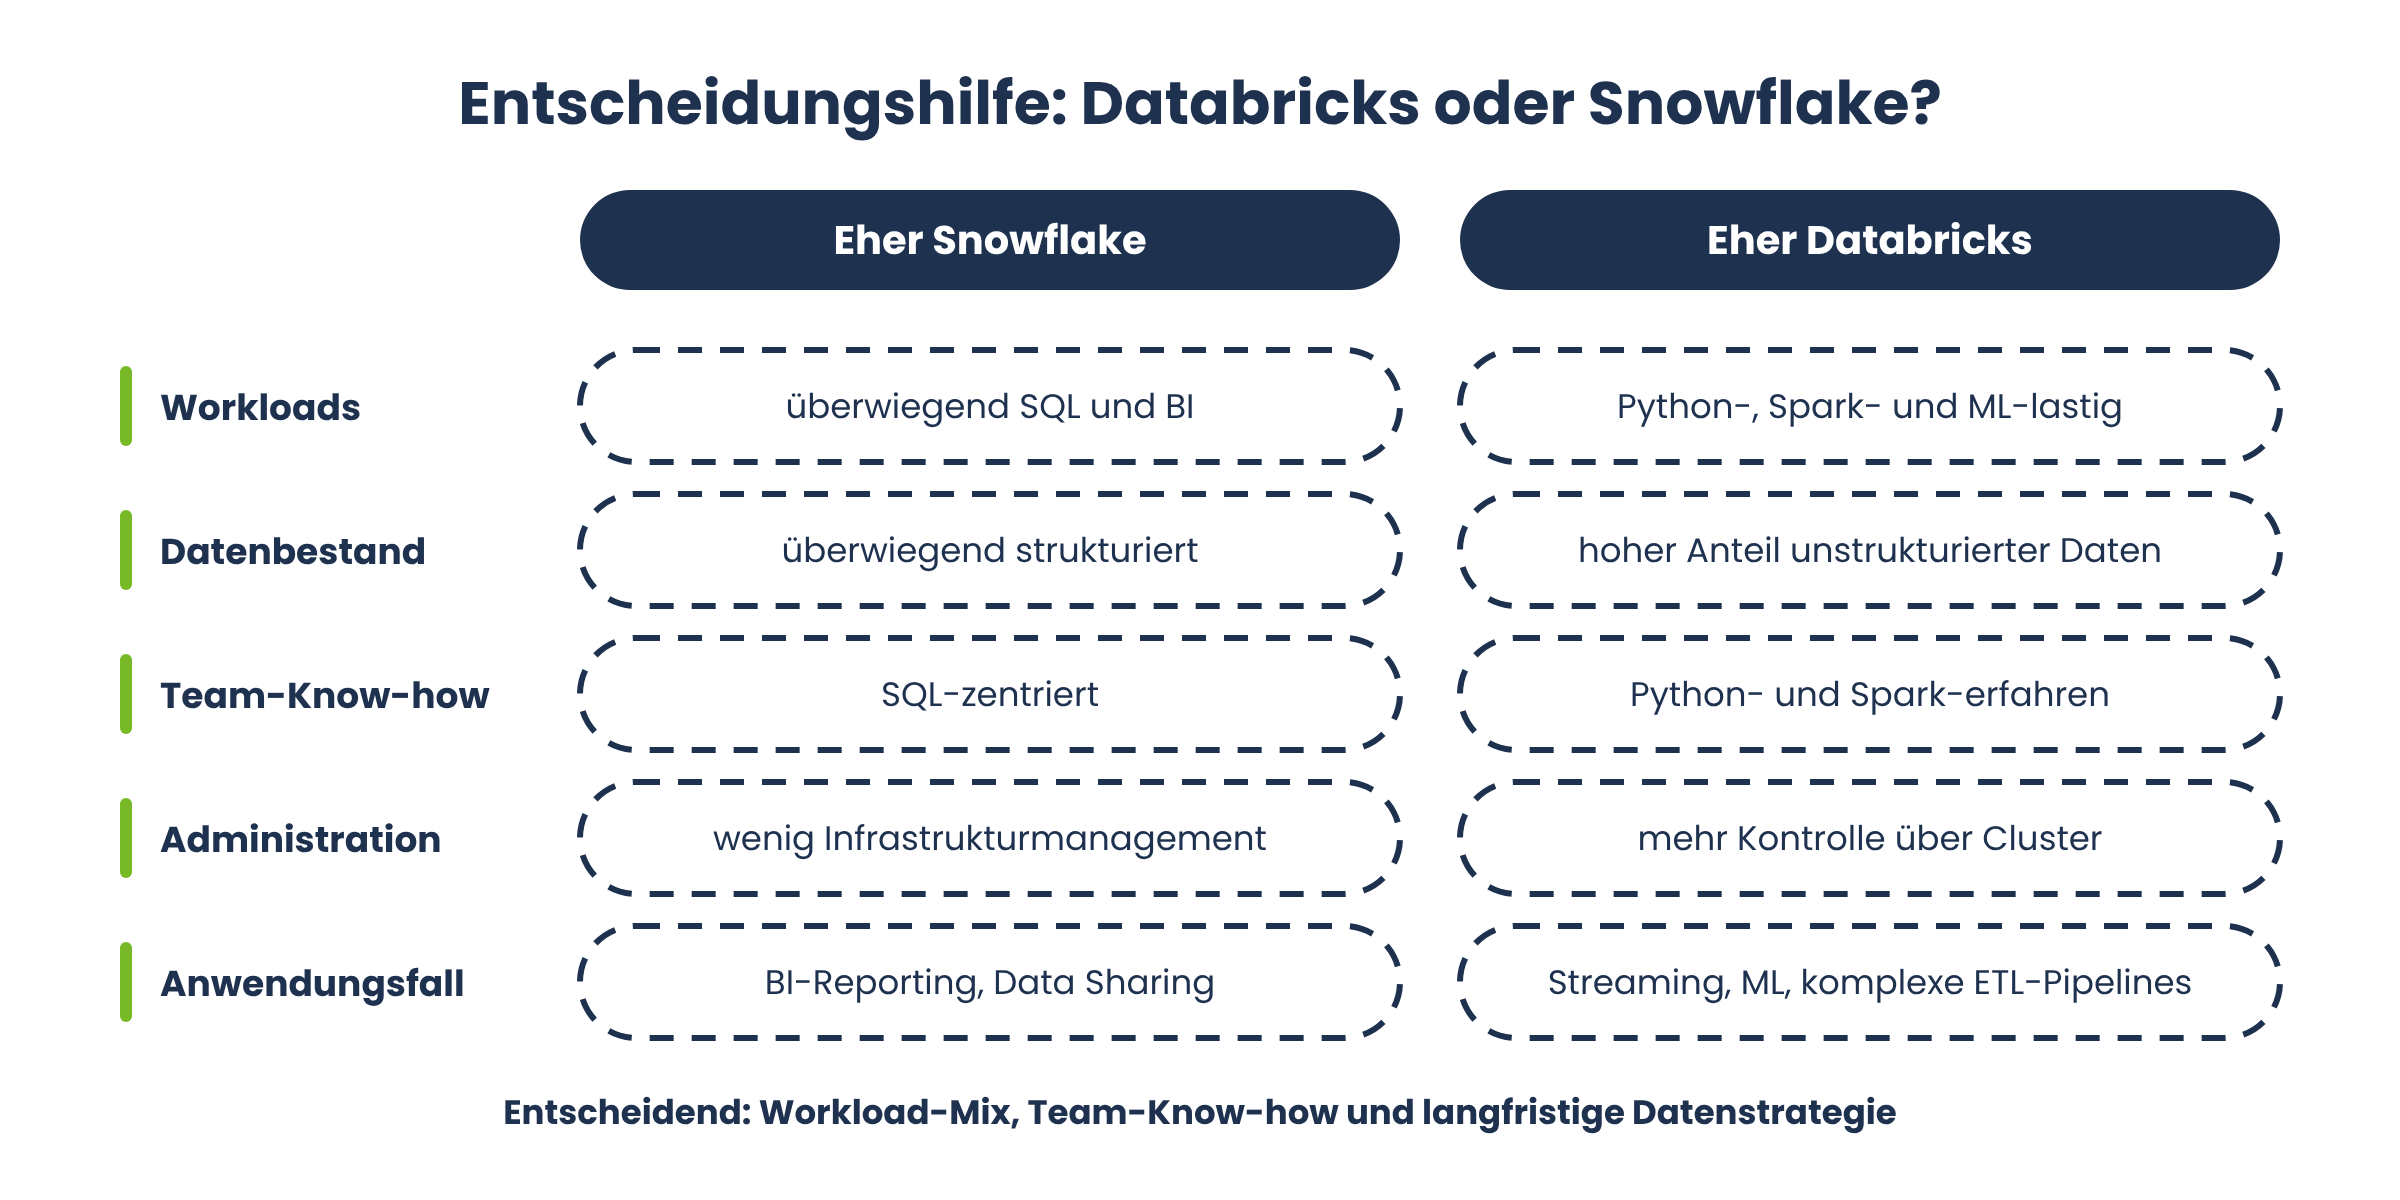
Analysiere zuerst deine tatsächlichen Workloads, bevor du Preislisten vergleichst.
Baue ein TCO-Arbeitsblatt, das jede Kostenkomponente einzeln für deinen realen Workload-Mix bepreist.
Teste beide Plattformen mit einem realistischen Proof of Concept, statt dich allein auf Benchmarks der Anbieter zu verlassen.
Berücksichtige vorhandenes Know-how im Team: SQL-zentrierte Teams starten mit Snowflake oft schneller, Python- und Spark-erfahrene Teams profitieren schneller von Databricks.
Plane die Kostenentwicklung bei doppeltem Datenvolumen ein, nicht nur den aktuellen Stand.
Checkliste: So triffst du die richtige Entscheidung
[ ] Sind eure Workloads überwiegend SQL-basiert oder eher Python- und ML-lastig?
[ ] Wie hoch ist der Anteil unstrukturierter Daten an eurem Datenbestand?
[ ] Wie wichtig ist euch sichere Datenfreigabe mit externen Partnern?
[ ] Welches Know-how bringt euer Team bereits mit?
[ ] Habt ihr die Kosten für ein realistisches Wachstumsszenario durchgerechnet?
[ ] Passt eine der beiden Plattformen zu eurer bestehenden Cloud-Strategie?
Databricks oder Snowflake – was passt zu deinem Unternehmen?
Databricks und Snowflake sind führende Plattformen im modernen Datenmanagement, verfolgen aber unterschiedliche Philosophien. Snowflake überzeugt bei klassischen SQL-Analysen, Business Intelligence und einfacher Verwaltung. Databricks überzeugt bei Machine Learning, komplexem Data Engineering und der Verarbeitung unstrukturierter Daten. Eine pauschale Antwort auf die Frage "Databricks oder Snowflake" gibt es nicht – die Entscheidung hängt von eurem Workload-Mix, eurem Team-Know-how und eurer langfristigen Datenstrategie ab. Viele Unternehmen setzen inzwischen ohnehin auf beide Plattformen gemeinsam, statt sich für eine einzige Lösung zu entscheiden.
Wenn du unsicher bist, welche Datenplattform zu euren Anforderungen im Versicherungs-, öffentlichen oder KMU-Umfeld passt, unterstützt dich die FIDA bei der Analyse eurer Workloads und der Entwicklung einer passenden Datenstrategie. Die FIDA kennt die Anforderungen regulierter Branchen und hilft dabei, die Total Cost of Ownership realistisch statt anhand von Marketingversprechen zu kalkulieren.
Häufig gestellte Fragen zu Databricks und Snowflake (FAQ)
Das lässt sich nicht pauschal beantworten. Für reine SQL- und BI-Workloads ist Snowflake oft günstiger, für Machine-Learning- und Data-Engineering-lastige Workloads schneidet Databricks häufig besser ab. Entscheidend ist der individuelle Workload-Mix, nicht der Listenpreis.
Ja, mit Snowpark ML und Cortex AI bietet Snowflake mittlerweile eigene Machine-Learning-Funktionen. Für einfache bis mittlere ML-Anwendungsfälle reicht das häufig aus, bei komplexem, verteiltem Training bleibt Databricks aufgrund der nativen Spark-Umgebung meist leistungsfähiger.
Ein Data Warehouse speichert vorstrukturierte Daten für Reporting und Analysen. Ein Data Lakehouse, der Ansatz von Databricks, kombiniert die Flexibilität eines Data Lake für strukturierte und unstrukturierte Daten mit der Governance und Zuverlässigkeit eines klassischen Data Warehouse.
Eine DBU misst die Rechenkapazität, die ein Cluster oder Job pro Stunde verbraucht. Die DBU-Rate variiert je nach Cluster-Typ, Workload und gewähltem Tarif und wird zusätzlich zu den Cloud-Infrastrukturkosten des jeweiligen Cloud-Anbieters abgerechnet.
Ja, sowohl Snowflake als auch Databricks laufen auf allen drei großen Hyperscalern und bieten Multi-Cloud-Unterstützung für die Integration verteilter Datenquellen.
Für umfangreiche, komplexe ETL- und ELT-Pipelines bietet Databricks durch native Spark-Unterstützung meist mehr Flexibilität und bessere Performance. Snowflake eignet sich gut für einfachere Transformationen im SQL-Kontext, stößt bei sehr komplexen Pipelines aber schneller an Grenzen.
Für größere Organisationen mit unterschiedlichen Teams und Anforderungen ja: Databricks für Data Engineering und Machine Learning, Snowflake für BI und Datenfreigabe. Für kleinere Unternehmen erhöht der parallele Betrieb jedoch Kosten und Komplexität und sollte gut abgewogen werden.
Eine Migration erfordert in der Regel eine sorgfältige Analyse bestehender Pipelines, Datenmodelle und Zugriffsrechte. Offene Formate wie Apache Iceberg erleichtern den Übergang, weil Daten ohne vollständige Neustrukturierung zwischen beiden Plattformen abgefragt werden können. Eine schrittweise Migration mit Parallelbetrieb reduziert das Risiko gegenüber einem harten Umstieg.
Für KMU mit begrenzten IT-Ressourcen ist Snowflake aufgrund des geringeren Administrationsaufwands häufig der einfachere Einstieg. Sobald jedoch Machine-Learning-Projekte oder die Verarbeitung großer, unstrukturierter Datenmengen hinzukommen, lohnt sich ein genauer Blick auf Databricks, insbesondere wenn entsprechendes Know-how im Team vorhanden ist.


